
إجابة سريعة: كيف تستخدم MiniMax H3 Ref2VA لفيديو NSFW؟
استخدم نقطة تحقق MiniMax H3 Ref2VA المخصصة في سير ComfyUI R2V متوافق. ابدأ بصورة شخصية معتمدة، واربطها باسم <Picture 1>، وعرّف الموضوع المتكرر في الموجّه. أضف فيديو مرجعيًا فقط عند الحاجة إلى حركة أو نمط كاميرا أو بنية مونتاج أو متابعة محددة. اربط الصوت منفصلًا عندما يوجّه صوتًا أو موسيقى أو إيقاعًا أو مسارًا قابلًا لإعادة الاستخدام.
لفيديو NSFW، الترتيب الأكثر أمانًا هو هوية الشخصية أولًا، ثم حركة جسم بسيطة، ثم حركة الكاميرا، وأخيرًا التفاعل القريب. اختبر كل إضافة بمقطع قصير قبل إدخال مرجع آخر.
يحسّن Ref2VA التحكم القائم على المراجع، لكنه لا يضمن هوية أو تشريحًا مثاليين. تظل النتائج معتمدة على الوضعيات المتوافقة وحدود الجسم الواضحة وصور الشخصية المتسقة والموجّه غير الملتبس.
إذا لم تكن لديك شخصية بداية مستقرة، فأنشئ واحدة واعتمدها باستخدام مولّد الصور من AINSFW.AI قبل بناء سير Ref2VA.
 عرض شخصية NSFW
MiniMax H3 Ref2VA مقابل FL2VA: أي سير عمل تستخدم؟
يستخدم MiniMax H3 نقاط تحقق منفصلة لكل مهمة. يعالج FL2VA التحويل من نص إلى صوت وفيديو والتوليد المشروط بالإطار الأول أو الأخير. ويعالج Ref2VA التحويل من مراجع إلى صوت وفيديو باستخدام الصور أو الفيديو أو الصوت أو المراجع المختلطة.
| هدفك | المسار الموصى به |
|---|---|
| إنشاء مشهد من نص | T2VA مع FL2VA |
| تحريك إطار افتتاحي دقيق | I2VA مع FL2VA |
| ربط إطار افتتاحي وختامي | FL2VA |
| الحفاظ على شخصية دون فرض الصورة كإطار صفر | Ref2VA |
| نقل الحركة أو سلوك الكاميرا | Ref2VA |
| مرجع لصوت أو موسيقى أو إيقاع أو نسيج صوتي | Ref2VA |
| تعديل مصدر سمعي بصري قائم أو متابعته | Ref2VA |
الفرق هو دور الأصل. الصورة المتصلة كإطار أول تحدد تركيب البداية الفعلي. أما الصورة نفسها في Ref2VA فيمكنها تعريف وجه الشخصية وجسمها وأسلوبها وبيئتها ووضعيتها من دون أن تصبح الإطار الأول.
هذا مهم في سير شخصيات NSFW. قد تثبّت صورة افتتاحية مقطعًا، لكنها قد لا توفر معلومات كافية عند دوران الجسم أو اتساع اللقطة أو حجب موضوع آخر جزءًا منه. يستطيع Ref2VA استخدام مناظر هوية إضافية إذا وصفت الشخصية نفسها.
يستخدم السيران أيضًا أوزان انتشار مختلفة. تحميل أوزان FL2VA في سير Ref2VA لا ينشئ سلوك مراجع متعدد الوسائط لمجرد أن العقد المحيطة تبدو متوافقة.
كيفية إعداد MiniMax H3 Ref2VA في ComfyUI
1. حمّل نموذج Ref2VA وسير العمل
حدّث ComfyUI قبل فتح سير العمل. قد لا تحتوي التثبيتات القديمة على عقد MiniMax H3 الأصلية والقوالب الحديثة.
افتح مكتبة القوالب وابحث عن MiniMax H3 R2V، أو استخدم JSON الرسمي الحالي. قد يظهر “R2V” في اسم القالب بينما تستخدم نقطة التحقق والمهمة ref2va. يشير الاسمان هنا إلى مسار المرجع إلى الفيديو نفسه.
في بنية مجلدات ComfyUI القياسية يوضع نموذج انتشار Ref2VA في models/diffusion_models، ومشفّر النص في models/text_encoders، وVAE الفيديو والصوت في models/vae، وturbo LoRA الاختياري في models/loras.
تأكد من أن السير يحمّل نموذج Ref2VA لا إصدار FL2VA. استخدم الملفات التي يسميها القالب الحالي لأن BF16 وINT8 وNVFP4 وغيرها قد تحتاج إلى محمّلات أو إعدادات ذاكرة مختلفة.
استخدم مسار التوليد العادي في الاختبار الأول. يسرّع turbo LoRA الاختياري ذي الخطوات الأربع التكرار، لكن الوثائق الرسمية تشير إلى احتمال انخفاض جودة الحركة والصوت.
2. أضف مرجع شخصية معتمدًا واحدًا
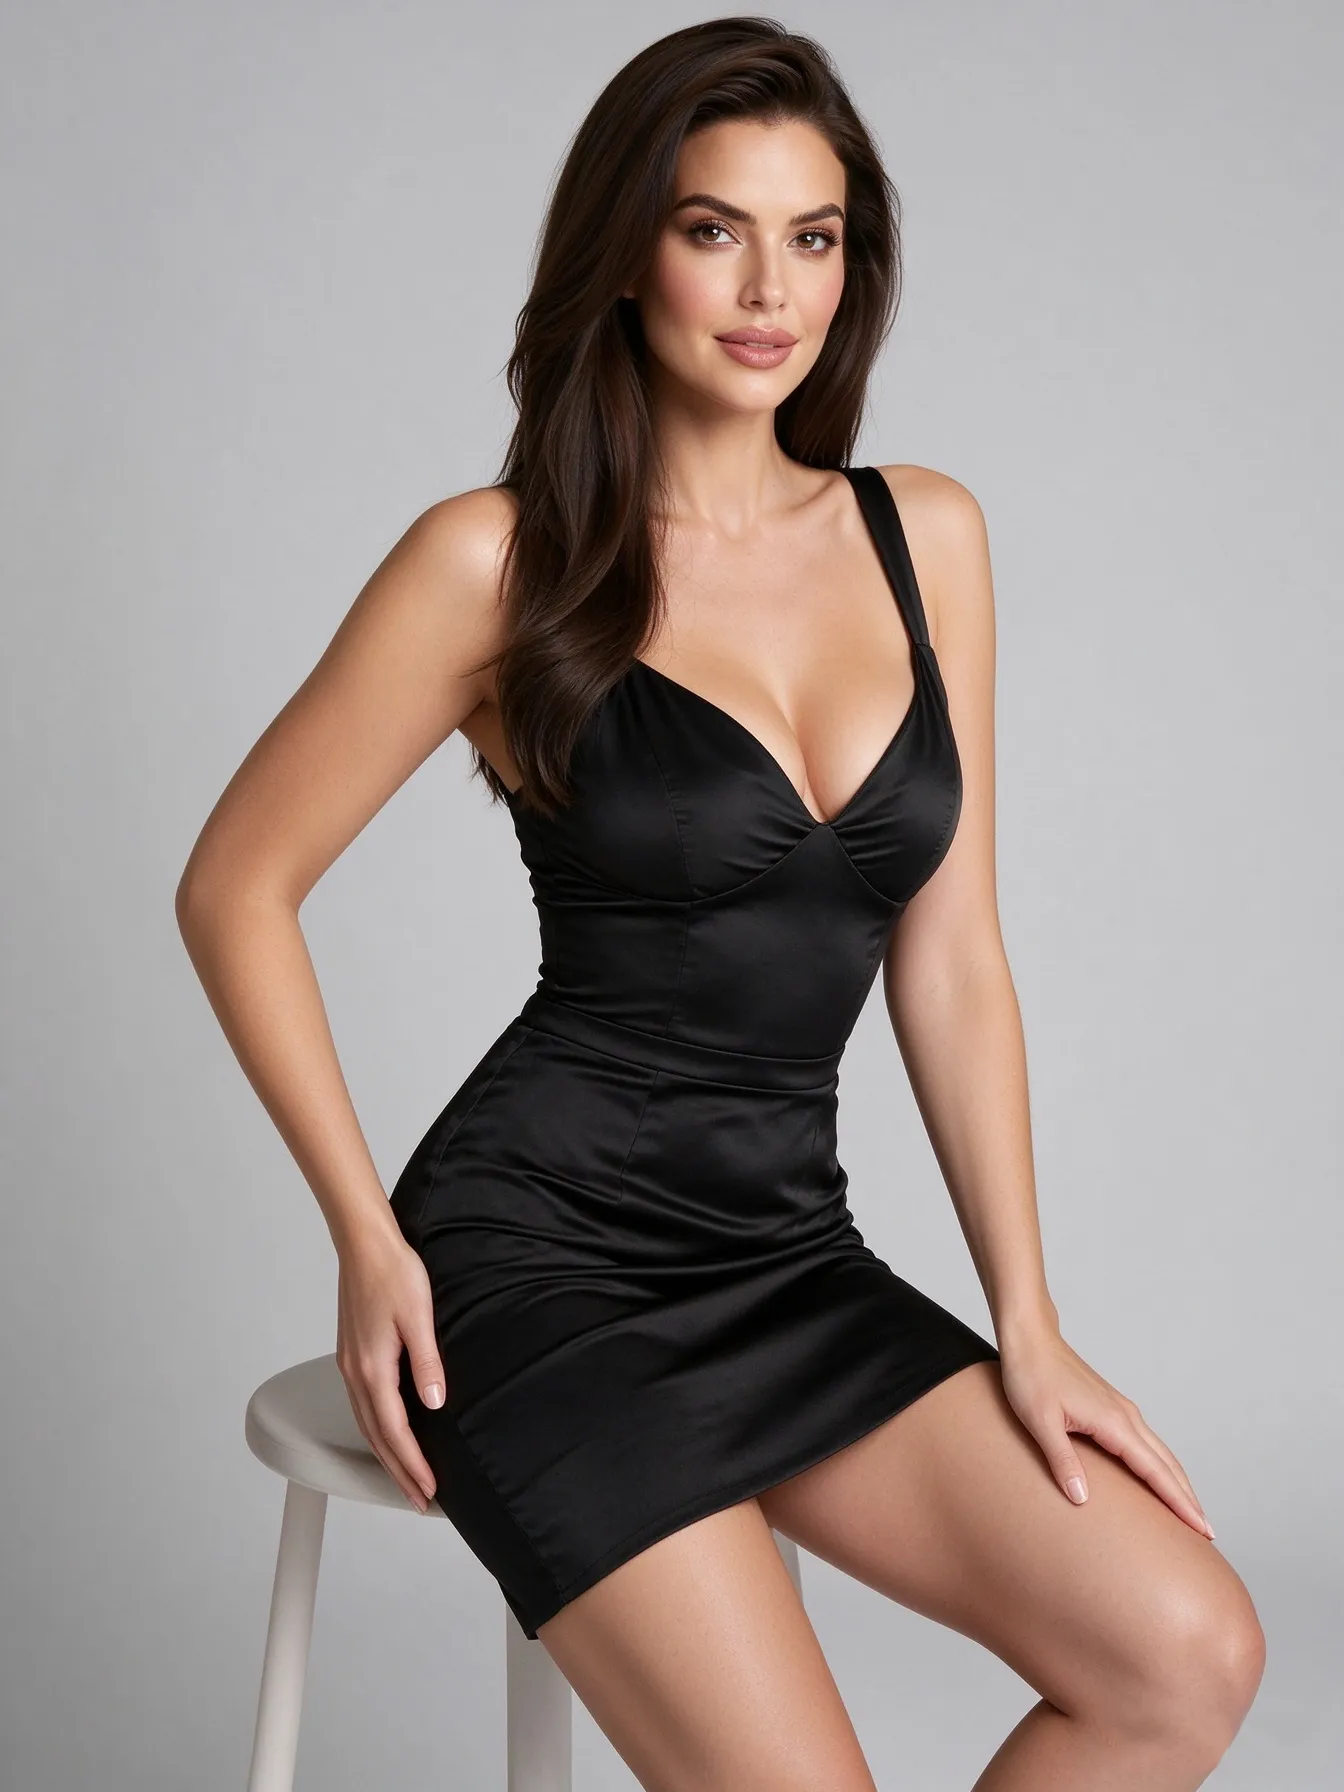
ابدأ بصورة شخصية واحدة بدل معرض كامل. يجب أن يكون الوجه واضحًا، ومنطقة الجسم المقصودة ظاهرة، وحدود الوضعية قابلة للقراءة.
قد يكفي وجه وجزء علوي واضحان للقطة قريبة متحدثة. أما تعديل وضعية جلوس أو حركة حسية أوسع فيحتاج صورة تظهر الكتفين والجذع والخصر واليدين ووضعية البداية. لا تطلب من صورة شخصية مقصوصة معلومات جسم لم تحتوها.
اربط الصورة بأول مدخل لمرجع الصورة. تصبح <Picture 1> في الموجّه. تُرقم الصور الأخرى حسب ترتيب اتصالها.
يجب أن تثبت أقوى صورة هوية ما يلي:
- شكل الوجه والسمات المميزة
- مظهر الشعر والبشرة
- نسب الجسم الظاهرة في اللقطة الهدف
- الأسلوب أو حالة الملابس التي يجب تثبيتها
- وضعية البداية واتجاه الجسم
لا تبدأ بربط نسخ ذات وجوه أو تسريحات أو نسب أو أساليب مختلفة. تساعد المراجع الإضافية فقط عندما تضيف معلومات متوافقة.
3. اربط فيديو مرجعًا للحركة
يمكن للفيديو المرجعي توفير حركة الجسم أو سلوك الكاميرا أو إيقاع المونتاج أو مشهد للتعديل أو نقطة للمتابعة. يجب أن يحدد الموجّه العلاقة المقصودة.
تعيد بعض محمّلات فيديو ComfyUI كائن VIDEO، بينما يتوقع مدخل MiniMax H3 تسلسل صور مستخرجًا. إذا لم تتصل المنافذ، فاستخدم عقدة Get Video Components الأصلية لإظهار الإطارات والصوت ومعدل الإطارات، ثم اربط التسلسل بمدخل الفيديو المرجعي.
إذا احتجت إلى المسار الصوتي الأصلي، فاربط الصوت المستخرج منفصلًا. لا تفترض أن تحميل فيديو يعيّن صوته تلقائيًا كمرجع <Audio N> قابل للاستخدام.
لنقل الحركة، اختر مصدرًا تشبه وضعية بدايته وضعية الشخصية الهدف. التوفيق بين شخصية جالسة ومصدر حركة جالس أسهل من صورة وجه قريبة ودوران فوري لكامل الجسم واقفًا.
يجب أن تبقى الحركة واضحة بصريًا. تداخل الأجسام الشديد، أو الأيدي خلف الجذع، أو الشعر فوق المفاصل، أو عبور مؤديين بعضهما قد يجبر النموذج على إعادة بناء معلومات لا يوضحها أي مصدر.
اذكر أن الفيديو يوفر الحركة لا الهوية:
<Subject 1> تستمد هويتها ومظهرها من <Picture 1>.
يوفر <Video 1> فقط تعديل وضعية الجلوس البطيء وإيقاع الكاميرا.
لا تُحفظ المؤدية في <Video 1> داخل الفيديو الهدف.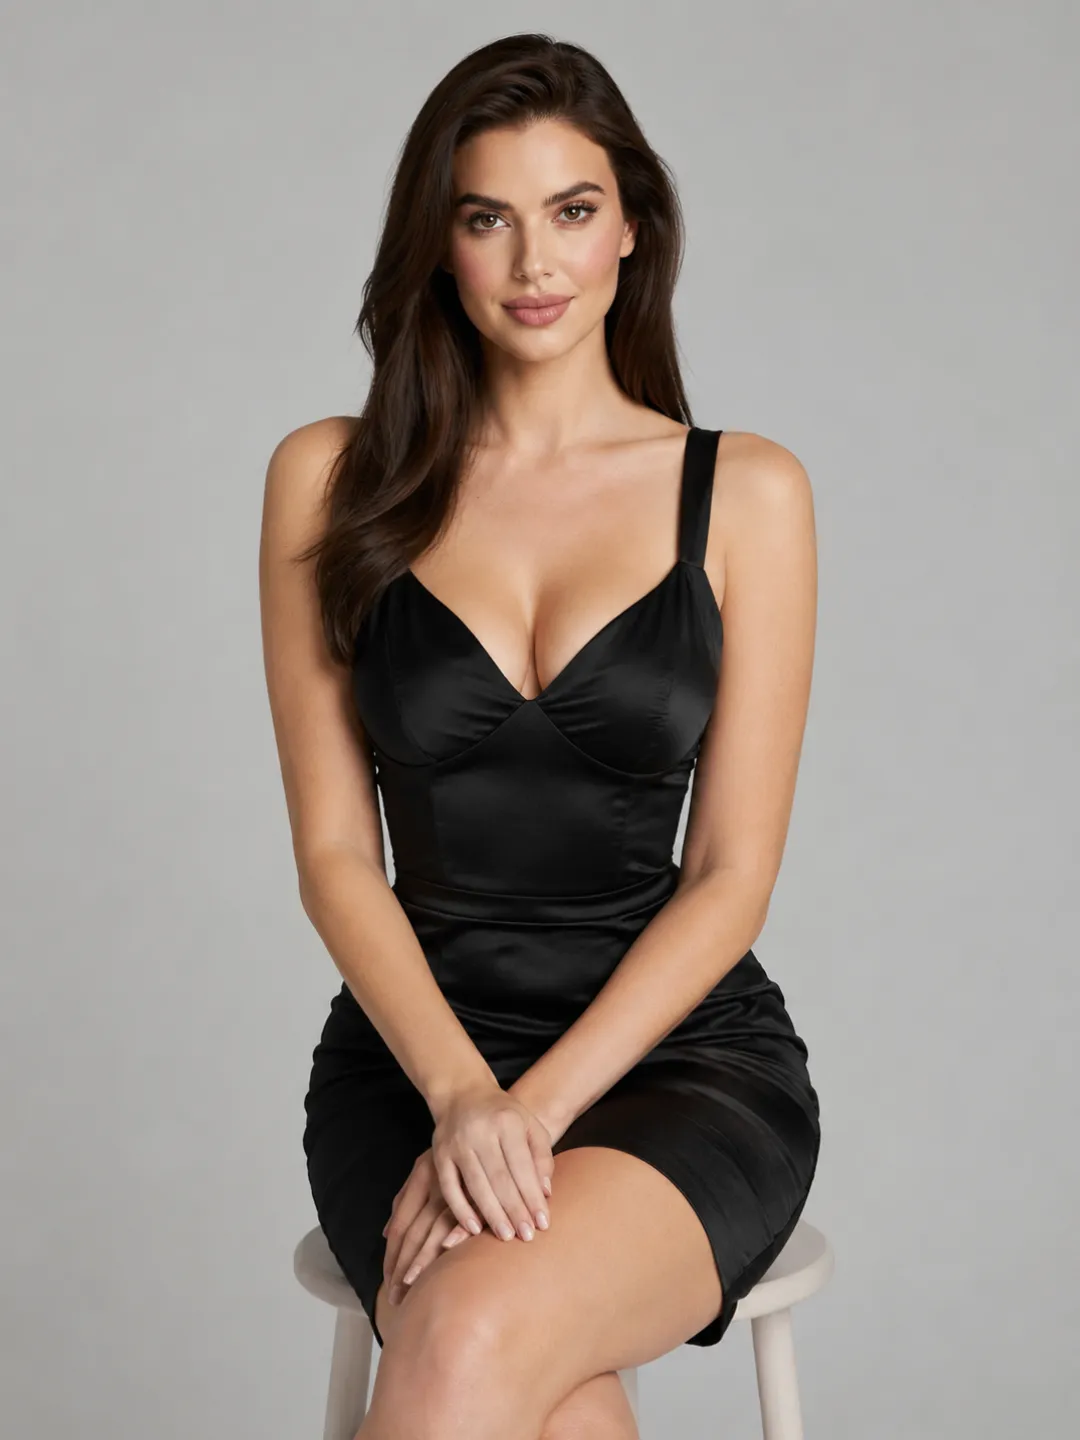 مرجع الشخصية
 مرجع الحركة
 النتيجة المولدة
4. أضف الصوت فقط عندما يكون دوره واضحًا
يمكن لـ Ref2VA استخدام صوت مستخرج من فيديو مرجعي أو ملف منفصل. وفق قواعد الإدخال الرسمية الحالية لا يمكن أن يكون الصوت وسيط المرجع الوحيد؛ بل يجب أن يصاحب صورة أو فيديو.
حدد ما إذا كان المصدر يقدم:
- مرجعًا لطابع الصوت
- مرجعًا للأداء أو العاطفة
- حوارًا أو كلمات يعاد استخدامها
- موسيقى خلفية يعاد استخدامها
- مرجعًا للإيقاع أو أسلوب الموسيقى
- مرجعًا للصوت البيئي
الإشارة إلى صوت ليست نسخ إشارته الأصلية. إذا كان على الشخصية قول حوار جديد بجودة مشابهة، فعرّف المصدر كمرجع لطابع الصوت واكتب الحوار الجديد في الموجّه.
تُرقم تسميات الصوت بصورة مستقلة عن الفيديو. لا يُفهم <Video 1> و<Audio 1> تلقائيًا كجزأين من الملف نفسه ما لم يشرح الموجّه علاقتهما.
استخدم فقط مراجع وجه وفيديو وصوت تملكها أو مأذونًا بها. لا ينبغي استخدام Ref2VA لانتحال شخص معروف بلا إذن.
 مشهد مرجع صوتي
5. اربط المراجع بصورة متسقة
استخدم التسمية نفسها لكل مدخل في الموجّه كله:
تحدد <Picture 1> مظهر <Subject 1>.
توفر <Picture 2> منظرًا أوسع للشخصية نفسها.
يوفر <Video 1> حركة الجسم وتوقيت الكاميرا.
يوفر <Audio 1> طابع صوت <Subject 1>.
لا تذكر رقم صورة أو فيديو أو صوت غير متصل. ولا تغيّر معنى <Picture 1> لاحقًا.
يدعم السير عدة صور وفيديوهات ومقاطع صوتية، لكن السعة القصوى ليست إعداد بداية موصى به. ابدأ بصورة ومصدر حركة واحد، وأضف مرجعًا فقط عندما يقدم معلومات ناقصة.
6. شغّل مقطع تحقق قصيرًا
يجب أن يتضمن التوليد الأول:
- شخصية واحدة
- فعلًا رئيسيًا واحدًا
- لقطة واحدة
- كاميرا ثابتة أو مقيّدة
- بيئة بسيطة
- دون حوار أو موسيقى غير ضروريين
تحقق من الشخصية قبل زيادة التعقيد. يجب أن يبقى الوجه ونسب الجسم والأسلوب وتغطية الجسم واتجاه الوضعية متسقة من البداية حتى الحركة الرئيسية.
عندما ينجح المقطع الأساسي، أضف متغيرًا واحدًا كل مرة: منظرًا ثانيًا أو فيديو مرجعيًا أو حركة كاميرا أو صوتًا أو شخصًا آخر. هكذا تعرف أي مصدر غيّر النتيجة.
كيفية الحفاظ على اتساق شخصية NSFW بين المراجع
استخدم مناظر مختلفة للشخصية نفسها
قد تتضمن مجموعة مفيدة منظر وجه واضحًا ولقطة متوسطة ومنظر جسم أوسع. يجب أن تقدم الصور معلومات مختلفة مع الحفاظ على الهوية نفسها.
يجب أن تتفق ملامح الوجه والشعر والبشرة ونسب الجسم وتفاصيل الأسلوب المميزة. إذا غيرت صورة بنية الوجه أو الأسلوب، يتلقى النموذج تعريفين متنافسين.
يجب أن تتفق المراجع أيضًا على الحالة البصرية للّقطة الهدف. إذا عرضت صورة ملابس أو تغطية مختلفة كثيرًا، فحدد الحالة التي سيحفظها الهدف واحذف المصدر المتعارض.
استخدمها معًا
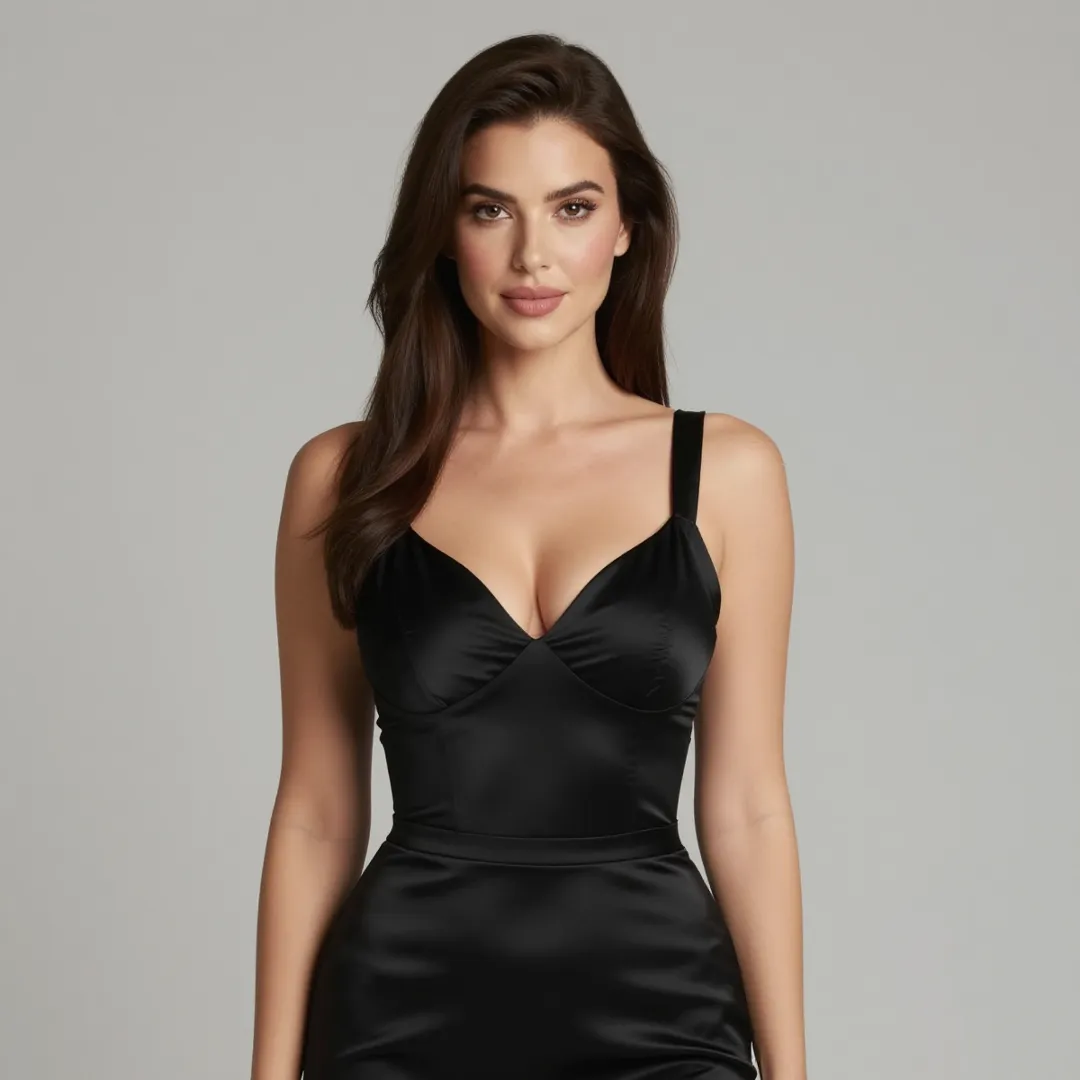
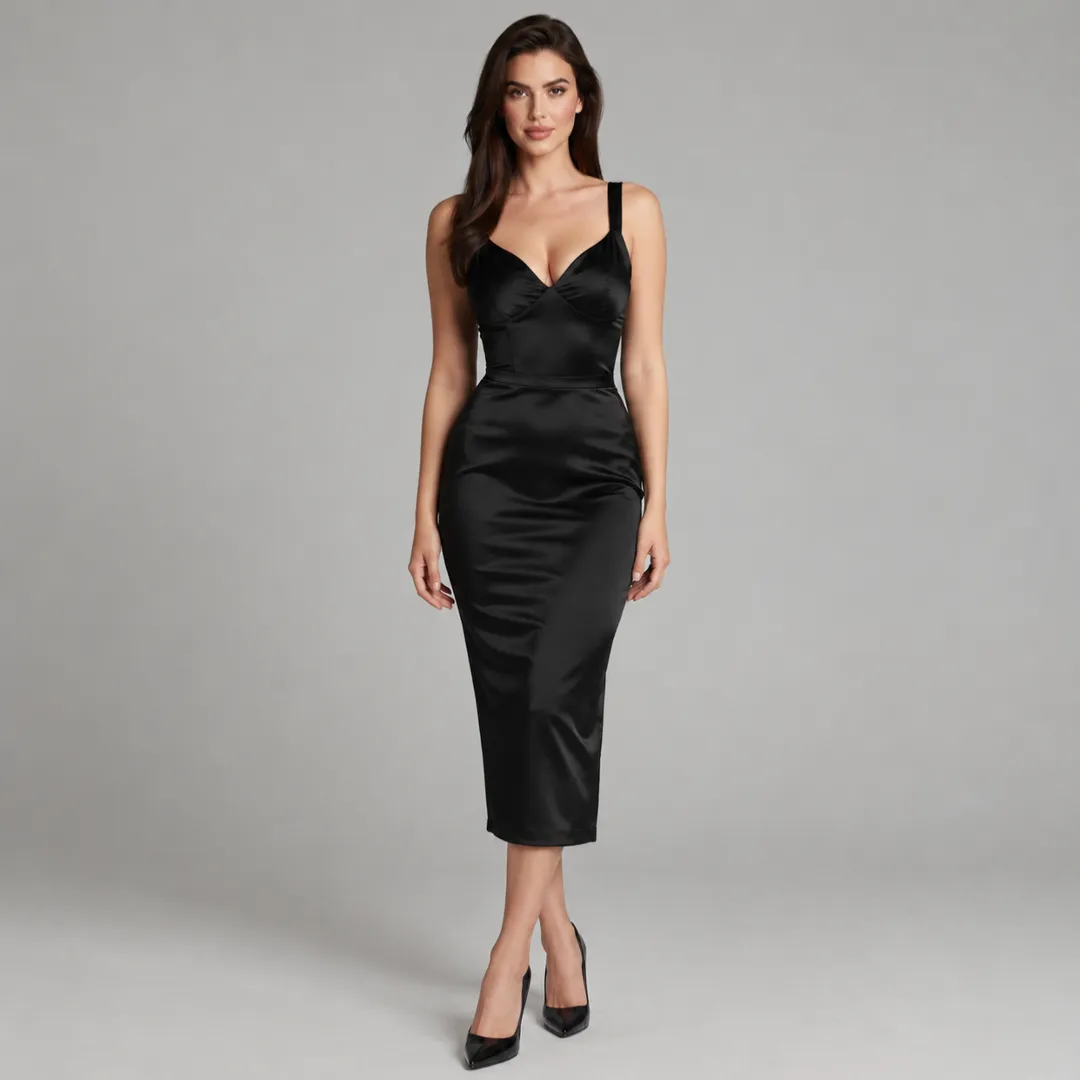
لا تخلط
طابق صورة المرجع مع الحركة
اختر صورة هوية تظهر أصلًا منطقة الجسم المشاركة. إذا عبرت الحركة الخصر أو غيرت الجلوس أو وضعت يدًا على الجذع، فيجب أن تكون هذه المناطق ظاهرة وواضحة بنيويًا.
تزداد الصعوبة عندما يكشف النموذج تشريحًا مخفيًا أو يفصل أطرافًا متداخلة أو يحافظ على نقاط اتصال متعددة. لذلك قد تكون الوضعية البسيطة مرجعًا أفضل من صورة أكثر درامية.
امنع مصدر الحركة من استبدال الشخصية
قد يحتوي فيديو الحركة على مؤدية أقوى بصريًا في الوجه أو الجسم أو الملابس أو البيئة من صورة الهوية. وقد يحتفظ النموذج من هذا المصدر بأكثر مما هو مقصود.
عرّف الموضوع الهدف قبل وصف الحركة، واذكر صراحة أن مؤدية المرجع لا تُحفظ. إذا ضعفت الهوية، فاختر مقطعًا يكون فيه وجه المصدر أقل بروزًا أو الوضعية أكثر توافقًا.
اختبر التفاعل القريب منفصلًا
يضيف التفاعل بين شخصين هوية أخرى وأطرافًا أكثر وحجبًا مؤقتًا ونقاط اتصال متحركة. لا تستخدمه كأول اختبار لشخصية جديدة.
تحقق من الشخصية الرئيسية وحدها أولًا، ثم أدخل الشخص الثاني في لقطة قصيرة مضبوطة. أبق الجسمين منفصلين بصريًا قدر الإمكان ولا تغيّر عدة أيدٍ ووجوه وحركات كاميرا معًا.
للتسلسل الأطول، أنشئ مقاطع منفصلة للمقدمة وتغيير الوضعية والتفاعل القريب واللقطة الأخيرة. أعد استخدام مراجع الهوية المعتمدة بدل إجبار توليد واحد على كل الانتقالات.
كيفية كتابة موجّه Ref2VA لاتساق شخصية NSFW وحركتها
يجب أن يشرح موجّه Ref2VA الفيديو الهدف وعلاقته بالمصادر. تكرار صفات المظهر لا يغني عن تعيين المراجع بوضوح.
ينظم تنسيق الموجّه كامل المراجع من MiniMax طلب Ref2VA في ستة أقسام:
subject_definitions:
<Subject 1> امرأة خيالية بالغة تستمد هوية الوجه والشعر الداكن الطويل ونسب الجسم وأسلوب الساتان الأسود من <Picture 1>.
توفر <Picture 2> منظرًا أوسع للشخصية نفسها وتؤكد نسبها ووضعية البداية.
يوفر <Video 1> تعديلًا بطيئًا لوضعية الجلوس ودفعًا مقيّدًا للكاميرا.
<Audio 1> هو مرجع طابع الصوت لـ <Subject 1> (S1).

summary:
[توليد مرجعي + مرجع صوتي]
الهدف فيديو بلقطة واحدة لـ <Subject 1> في استوديو خاص. تتبع الهوية والأسلوب <Picture 1> و<Picture 2>، وتتبع الحركة والكاميرا <Video 1>، ويسترشد طابع الصوت بـ <Audio 1>.

retention_analysis:
<Subject 1>: fully_preserved - الحفاظ على الوجه والشعر ونسب الجسم وأسلوب الساتان والحالة البصرية العامة.
<Video 1>: reference - نقل تغير الوضعية وإيقاع الكاميرا دون الاحتفاظ بالمؤدية أو البيئة الأصلية.
<Audio 1>: reference - توجيه طابع الصوت دون نسخ التسجيل.

detailed_description:
يستخدم الفيديو إضاءة فوتوغرافية واقعية في استوديو خاص هادئ.
[Shot 1] تجلس <Subject 1> في لقطة متوسطة بزاوية ثلاثة أرباع. تبعًا للحركة المضبوطة من <Video 1>، تنقل وزنها ببطء وتدير كتفًا نحو الكاميرا وتستقر في الوضعية الجديدة. تتحرك الكاميرا مرة واحدة إلى الأمام دون تغيير الزاوية. تقول <Subject 1> (S1) بطابع الصوت الهادئ المرجعي من <Audio 1>: <d>[العربية] ابقي هنا للحظة.</d>

overall_soundscape:
صوت غرفة هادئ، وحركة قماش خفيفة، وأداء صوتي مرجعي.

non_diegetic_music:
لا توجد موسيقى خلفية.
يعرّف هذا الموجّه الهوية مرة واحدة ويخصص الباقي للحركة والكاميرا والصوت. تجنب تكرار وصف الوجه والجسم في كل حقل.
إذا احتاج الناتج إلى لقطة واحدة مستمرة، فلا تضف تعليمات كاميرا غير مترابطة. وإذا احتاج الفعل الثاني إلى وضعية أو تأطير أو اتصال جديد، فقد يستحق مقطعًا منفصلًا.
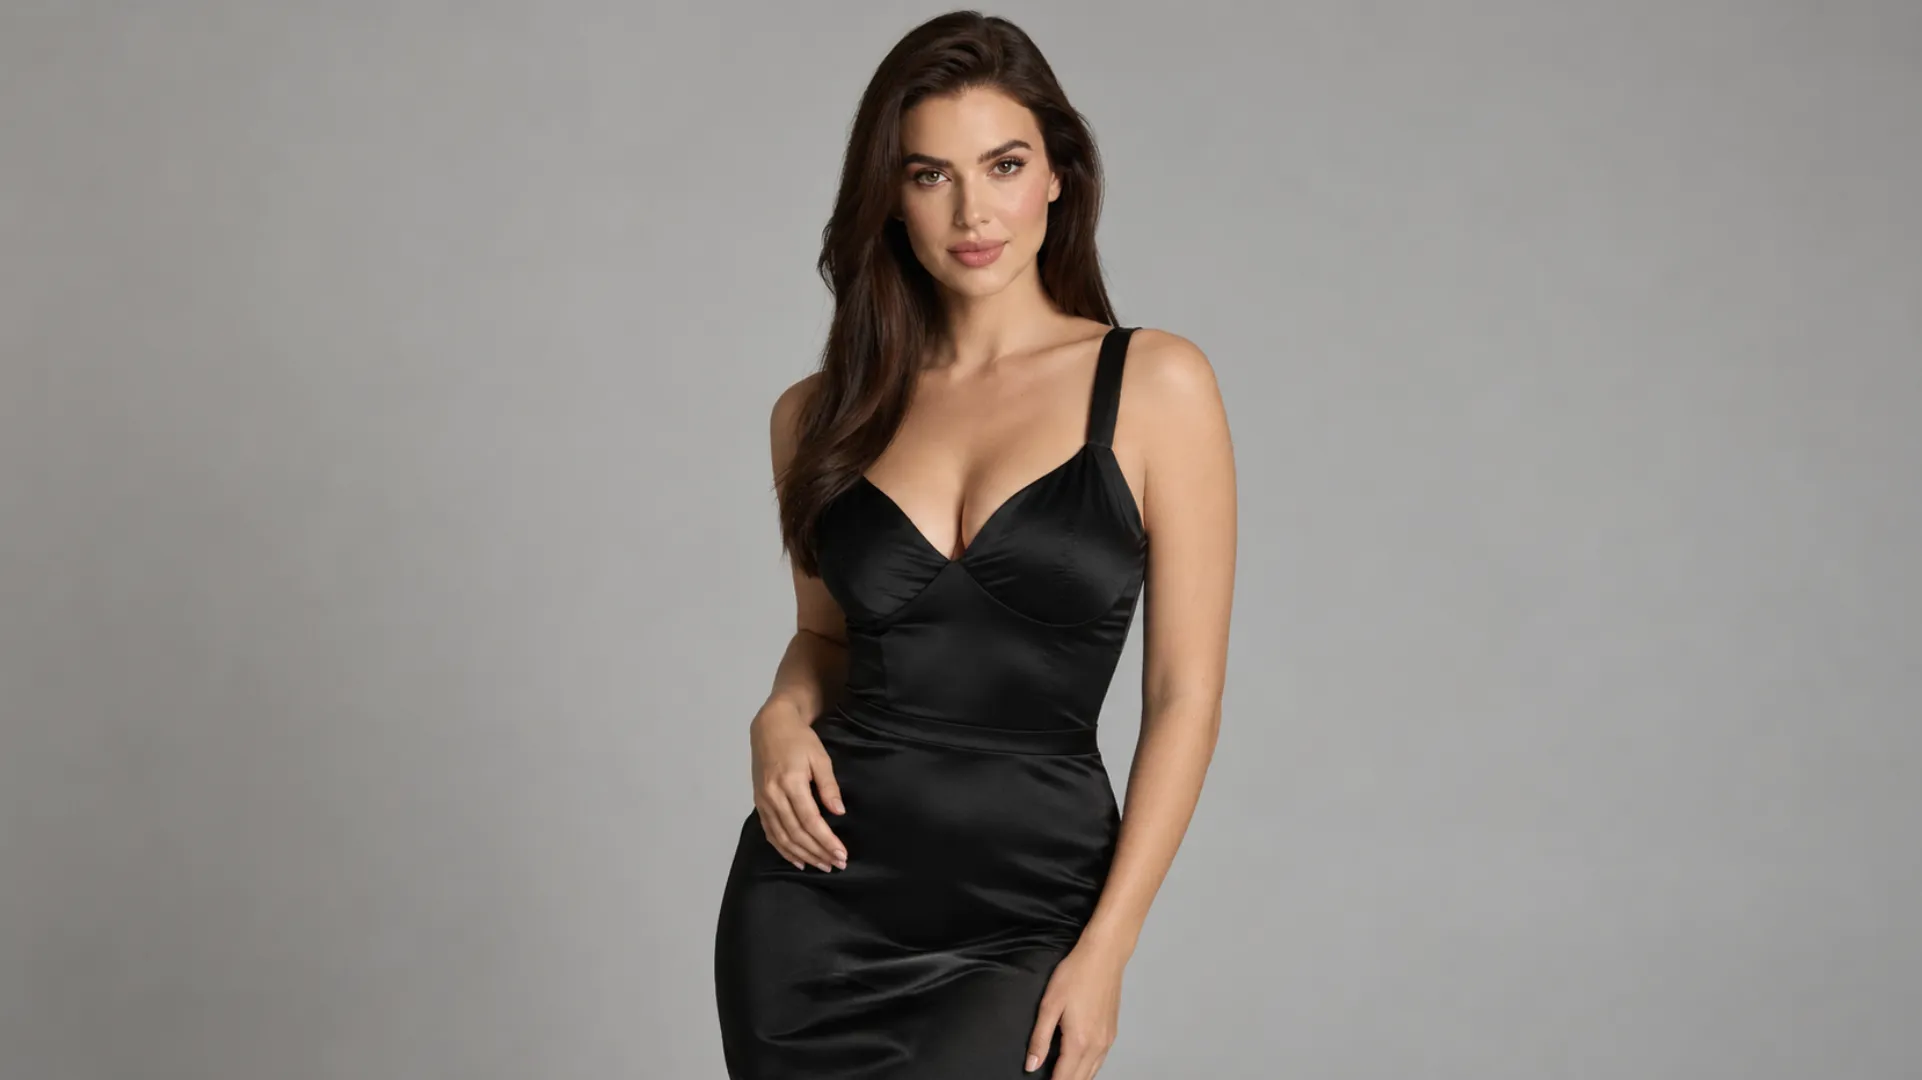 مشهد NSFW
سير عملي لـ MiniMax H3 Ref2VA لفيديوهات الذكاء الاصطناعي NSFW
يجب ألا يزيد سير الإنتاج القابل لإعادة الاستخدام التعقيد إلا بعد استقرار الطبقة السابقة.
الخطوة 1: اعتمد صورة الشخصية
اختر صورة تثبت الهوية واتجاه الجسم والأسلوب والحالة البصرية. إذا لم توجد صورة مناسبة، فأنشئها باستخدام مولّد الفتيات الواقعيات من AINSFW.AI أو مولّد فتيات الأنيمي أو مولّد الصور من العلامات.
لا تتابع لمجرد أن الصورة جذابة. تأكد من أنها توفر معلومات بصرية كافية للفعل الأول المخطط.
الخطوة 2: أنشئ اختبار هوية
أنشئ لقطة قريبة أو متوسطة قصيرة بحركة عينين أو تنفس أو تغير بسيط في التعبير أو دوران صغير للرأس. يحدد ذلك بقاء الشخصية معروفة قبل حركة جسم أكبر.
الخطوة 3: أضف حركة جسم مضبوطة
استخدم مرجع هوية أوسع واطلب تعديلًا واحدًا للكتف أو الجذع أو الخصر أو وضعية الجلوس. أبق الكاميرا ثابتة في أول اختبار حركة.
إذا تغيرت الشخصية أثناء حركة صغيرة، فغالبًا سيجعل مصدر حركة أعقد هذا التغير أوضح.
الخطوة 4: أدخل مرجع الحركة
اربط فيديو قصيرًا بوضعية بداية متوافقة، واذكر أنه يوفر الحركة وتوقيت الكاميرا لا الهوية.
قارن الناتج باختبار الهوية السابق. إذا بدأ الهدف يشبه مؤدية المرجع، فبسّط المصدر أو اجعل تعيين الموضوع أوضح.
الخطوة 5: أضف الكاميرا والصوت
بعد استقرار حركة الجسم، أدخل سلوك كاميرا واحدًا. أضف الصوت أو الأجواء أو الموسيقى بعد عمل المراجع البصرية معًا.
لا تغيّر مصدر الحركة والكاميرا والصوت وبنية الموجّه وإعدادات التوليد في الاختبار نفسه. تكون النتيجة أنفع عندما تفهم سبب نجاحها.
الخطوة 6: أنشئ لقطات فيديو مستقلة
أنشئ مقاطع منفصلة لأدوار إنتاج مختلفة:
- لقطة الهوية: تأطير قريب أو متوسط مع تعبير بسيط.
- لقطة الوضعية: انتقال جسدي أو وضعي مضبوط.
- لقطة حركة أوسع: حركة أكبر يدعمها مرجع أوسع.
- لقطة التفاعل: مقطع مختبر منفصلًا مع اتصال إضافي أو موضوع آخر.
ولّد كل مقطع من مجموعة المراجع المعتمدة بدل استخدام الناتج السابق كمصدر وحيد للمقطع التالي. يقلل ذلك تراكم انجراف الهوية.
إذا كانت ملفات النموذج المحلية وربط المراجع وصيانة ComfyUI تحكمًا أكثر مما يحتاجه المشروع، فاستخدم الصورة المعتمدة مع مولّد تحويل الصور إلى فيديو من AINSFW.AI. إنه المسار الأبسط عند البدء بصورة واحدة دون الحاجة إلى عدة مراجع فيديو أو صوت.
الأسئلة الشائعة عن MiniMax H3 Ref2VA
هل MiniMax H3 Ref2VA هو نفسه MiniMax H3 R2V؟
قد يسمى القالب في وثائق ComfyUI الحالية MiniMax H3 R2V بينما تستخدم المهمة ونقطة التحقق ref2va. يشير الاسمان هنا إلى سير المرجع إلى الصوت والفيديو، لا مسار الإطارات المفتاحية FL2VA.
هل يستطيع Ref2VA استخدام عدة صور للشخصية؟
نعم. يدعم السير الرسمي عدة مراجع صور. استخدم الصور الإضافية لزوايا متوافقة أو معلومات الجسم أو الأسلوب أو البيئة. قد تقلل الصور المختلفة في الهوية أو النسب الاتساق.
لماذا لا يتصل الفيديو المحمّل بمدخل Ref2VA؟
قد يخرج المحمّل كائن VIDEO بينما يتوقع المدخل إطارات مستخرجة. استخدم عقدة Get Video Components الأصلية في ComfyUI عند الحاجة لفصل تسلسل الإطارات والصوت والبيانات الوصفية.
هل يستطيع Ref2VA الجمع بين الصور والفيديو والصوت؟
نعم. صُمم Ref2VA للمراجع المختلطة متعددة الوسائط. اربط صورة أو فيديو واحدًا على الأقل، وسمّ كل مصدر باتساق، وحدد هل يوفر الهوية أو الحركة أو الكاميرا أو صوتًا يعاد استخدامه أو خاصية صوتية.
هل يضمن Ref2VA شخصية NSFW متسقة؟
لا. يوفر Ref2VA معلومات مرجعية أكثر، لكن الاتساق يعتمد على توافق المصادر ومعلومات الجسم الظاهرة وتوافق الوضعية ووضوح الموجّه وتعقيد الحركة والحجب. تظل الاختبارات القصيرة والإضافات المضبوطة ضرورية.