
Respuesta rápida: ¿cómo se usa MiniMax H3 Ref2VA para vídeo NSFW?
Usa el checkpoint específico MiniMax H3 Ref2VA en un flujo R2V compatible de ComfyUI. Empieza con una imagen de personaje aprobada, conéctala como <Picture 1> y define el sujeto recurrente en el prompt. Añade un vídeo de referencia solo cuando necesites un movimiento, patrón de cámara, estructura de montaje o continuación concretos. Conecta el audio por separado cuando deba guiar una voz, música, ritmo o banda sonora reutilizable.
Para vídeo NSFW, el orden de producción más seguro es: primero identidad del personaje, después movimiento corporal sencillo, luego movimiento de cámara y, al final, interacción cercana. Prueba cada añadido con un clip corto antes de introducir otra referencia.
Ref2VA mejora el control basado en referencias, pero no garantiza una identidad ni una anatomía perfectas. Los resultados siguen dependiendo de poses compatibles, límites corporales claros, imágenes coherentes del personaje y un prompt inequívoco.
Si no tienes un personaje inicial estable, créalo y apruébalo con el Generador de imágenes de AINSFW.AI antes de construir el flujo Ref2VA.
 Muestra de personaje NSFW
MiniMax H3 Ref2VA frente a FL2VA: ¿qué flujo debes usar?
MiniMax H3 utiliza checkpoints separados para cada tarea. FL2VA gestiona texto a audio-vídeo y generación condicionada por el primer o último fotograma. Ref2VA gestiona referencia a audio-vídeo mediante imágenes, vídeos, audio o referencias mixtas.
| Tu objetivo | Ruta recomendada |
|---|---|
| Generar una escena desde texto | T2VA con FL2VA |
| Animar un fotograma inicial exacto | I2VA con FL2VA |
| Conectar un fotograma inicial y uno final | FL2VA |
| Conservar un personaje sin forzar la imagen como fotograma cero | Ref2VA |
| Transferir movimiento o comportamiento de cámara | Ref2VA |
| Referenciar voz, banda sonora, ritmo o textura sonora | Ref2VA |
| Editar o continuar una fuente audiovisual existente | Ref2VA |
La diferencia está en el papel del recurso. Una imagen conectada como primer fotograma establece la composición inicial real. Esa misma imagen usada en Ref2VA puede definir rostro, cuerpo, estilo, entorno o pose sin convertirse en el primer fotograma.
Esto importa en los flujos de personajes NSFW. Una sola imagen inicial puede anclar un clip, pero quizá no aporte suficiente información cuando el cuerpo gira, el plano se abre o otro sujeto produce una oclusión temporal. Ref2VA puede usar vistas de identidad adicionales si describen al mismo personaje.
Los dos flujos también emplean pesos de difusión distintos. Cargar pesos FL2VA en un flujo Ref2VA no crea comportamiento de referencia multimodal solo porque los nodos cercanos parezcan compatibles.
Cómo configurar MiniMax H3 Ref2VA en ComfyUI
1. Carga el modelo y el flujo Ref2VA
Actualiza ComfyUI antes de abrir el flujo. Los nodos y plantillas nativos recientes de MiniMax H3 pueden no existir en una instalación antigua.
Abre la biblioteca de plantillas y busca MiniMax H3 R2V, o usa el JSON oficial actual. ComfyUI puede usar “R2V” en el nombre de la plantilla mientras el checkpoint y la tarea usan ref2va. Aquí ambos nombres indican la misma ruta de referencia a vídeo.
La estructura estándar de carpetas de ComfyUI coloca el modelo de difusión Ref2VA en models/diffusion_models, el codificador de texto en models/text_encoders, los VAE de vídeo y audio en models/vae y el LoRA turbo opcional en models/loras.
Confirma que el flujo carga el modelo de difusión Ref2VA y no la versión FL2VA. Usa los archivos indicados por la plantilla actual, porque BF16, INT8, NVFP4 y otras variantes pueden requerir cargadores o configuraciones de memoria diferentes.
Para la primera prueba, usa la ruta normal de generación. El LoRA turbo opcional de cuatro pasos agiliza la iteración, pero la documentación oficial advierte de una posible reducción de la calidad de movimiento y audio.
2. Añade una referencia de personaje aprobada
Empieza con una imagen del personaje, no con una galería completa. El rostro debe verse claro, la zona corporal prevista debe ser visible y la pose debe tener límites legibles.
Para un primer plano hablado puede bastar una referencia nítida de rostro y torso. Para ajustar una pose sentada o un movimiento sensual más amplio, usa una imagen que muestre hombros, torso, cintura, manos y postura inicial. No pidas a un retrato muy recortado información corporal que nunca contenía.
Conecta la imagen a la primera entrada de referencia de imagen. En el prompt se convierte en <Picture 1>. Las imágenes adicionales se numeran en el orden en que se conectan.
La imagen de identidad más sólida debe establecer:
- Forma del rostro y rasgos reconocibles
- Aspecto del cabello y la piel
- Proporciones corporales visibles en el plano objetivo
- Estilo o estado de vestimenta que debe permanecer estable
- Pose inicial y orientación del cuerpo
No empieces conectando varias versiones con rostros, peinados, proporciones o estilos visuales distintos. Más referencias solo ayudan cuando aportan información compatible.
3. Conecta un vídeo de referencia de movimiento
Un vídeo de referencia puede aportar movimiento corporal, comportamiento de cámara, ritmo de montaje, una escena existente que modificar o un punto desde el que continuar. El prompt debe especificar la relación deseada.
Algunos cargadores de vídeo de ComfyUI devuelven un objeto VIDEO, mientras que la entrada de referencia de MiniMax H3 espera una secuencia de imágenes extraída. Si los puertos no conectan, usa el nodo nativo Get Video Components para exponer fotogramas, audio, frecuencia de imagen y componentes relacionados. Conecta la secuencia a la entrada de vídeo de referencia.
Si también necesitas el sonido original, conecta el audio extraído por separado. No supongas que cargar un vídeo asigna automáticamente su audio como referencia <Audio N> utilizable.
Para transferir movimiento, elige una fuente cuya postura inicial se parezca a la del personaje objetivo. Es más fácil conciliar un personaje sentado con una fuente sentada que un retrato cerrado con un giro inmediato de cuerpo entero de pie.
El movimiento también debe seguir siendo legible. Una fuerte superposición corporal, manos ocultas tras el torso, pelo largo cubriendo articulaciones o dos intérpretes cruzándose pueden obligar al modelo a reconstruir información que ninguna fuente muestra claramente.
Indica que el vídeo aporta movimiento y no identidad:
<Subject 1> toma su identidad y apariencia de <Picture 1>.
<Video 1> aporta solo el ajuste lento de la postura sentada y el ritmo de cámara.
La intérprete de <Video 1> no se conserva en el vídeo objetivo.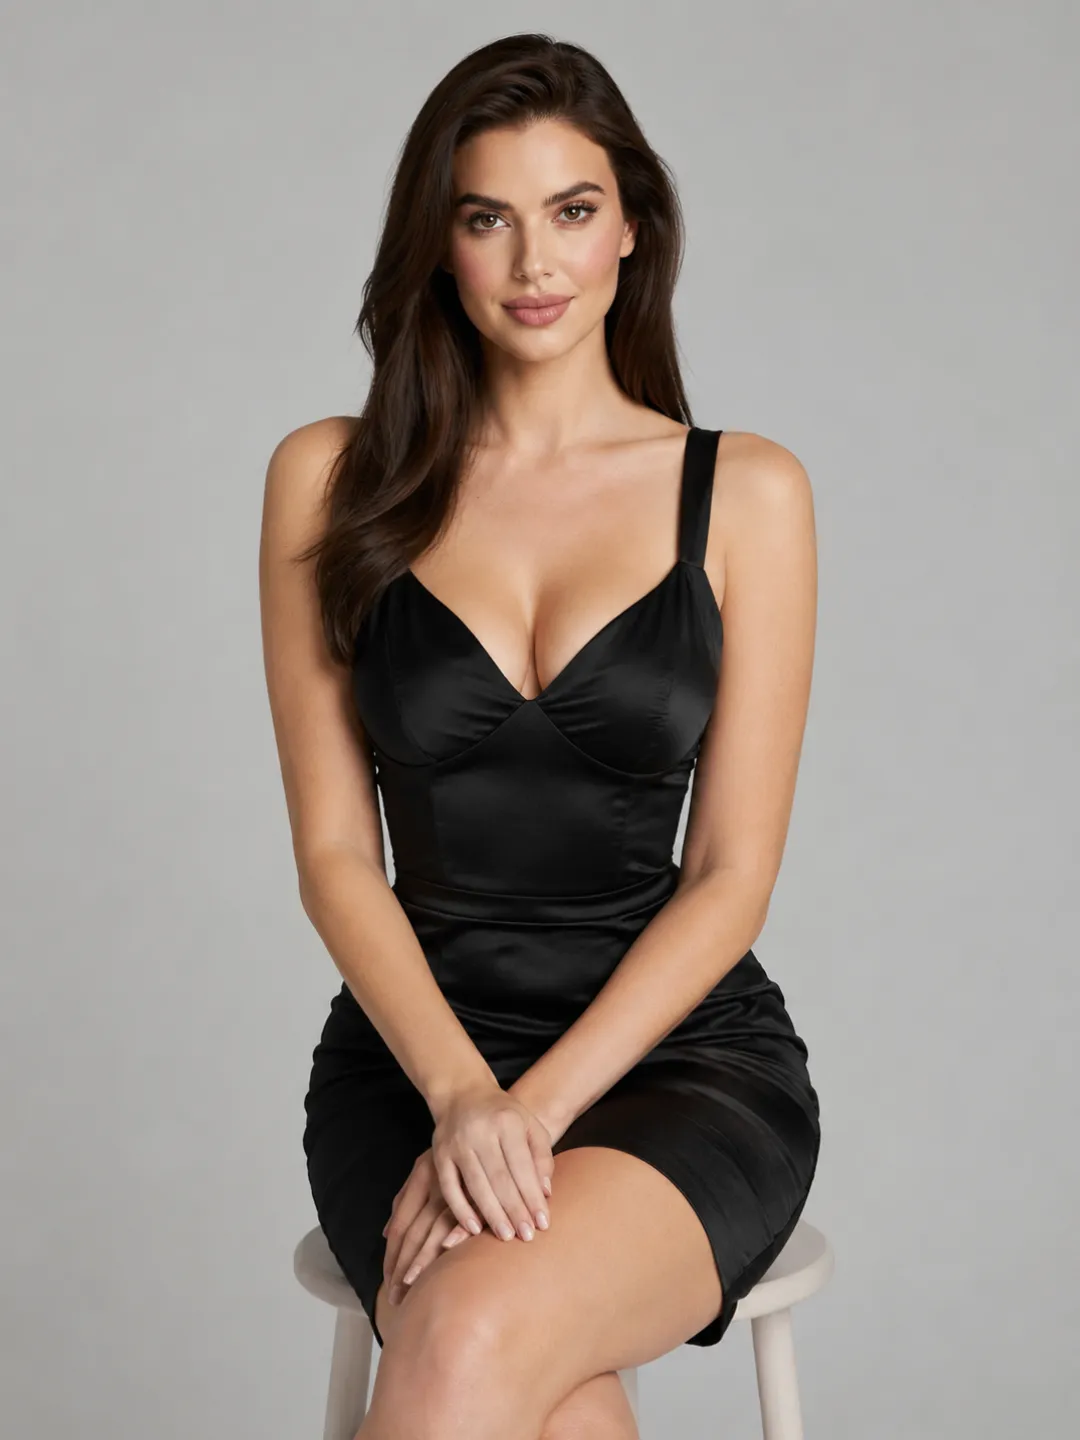 Referencia del personaje
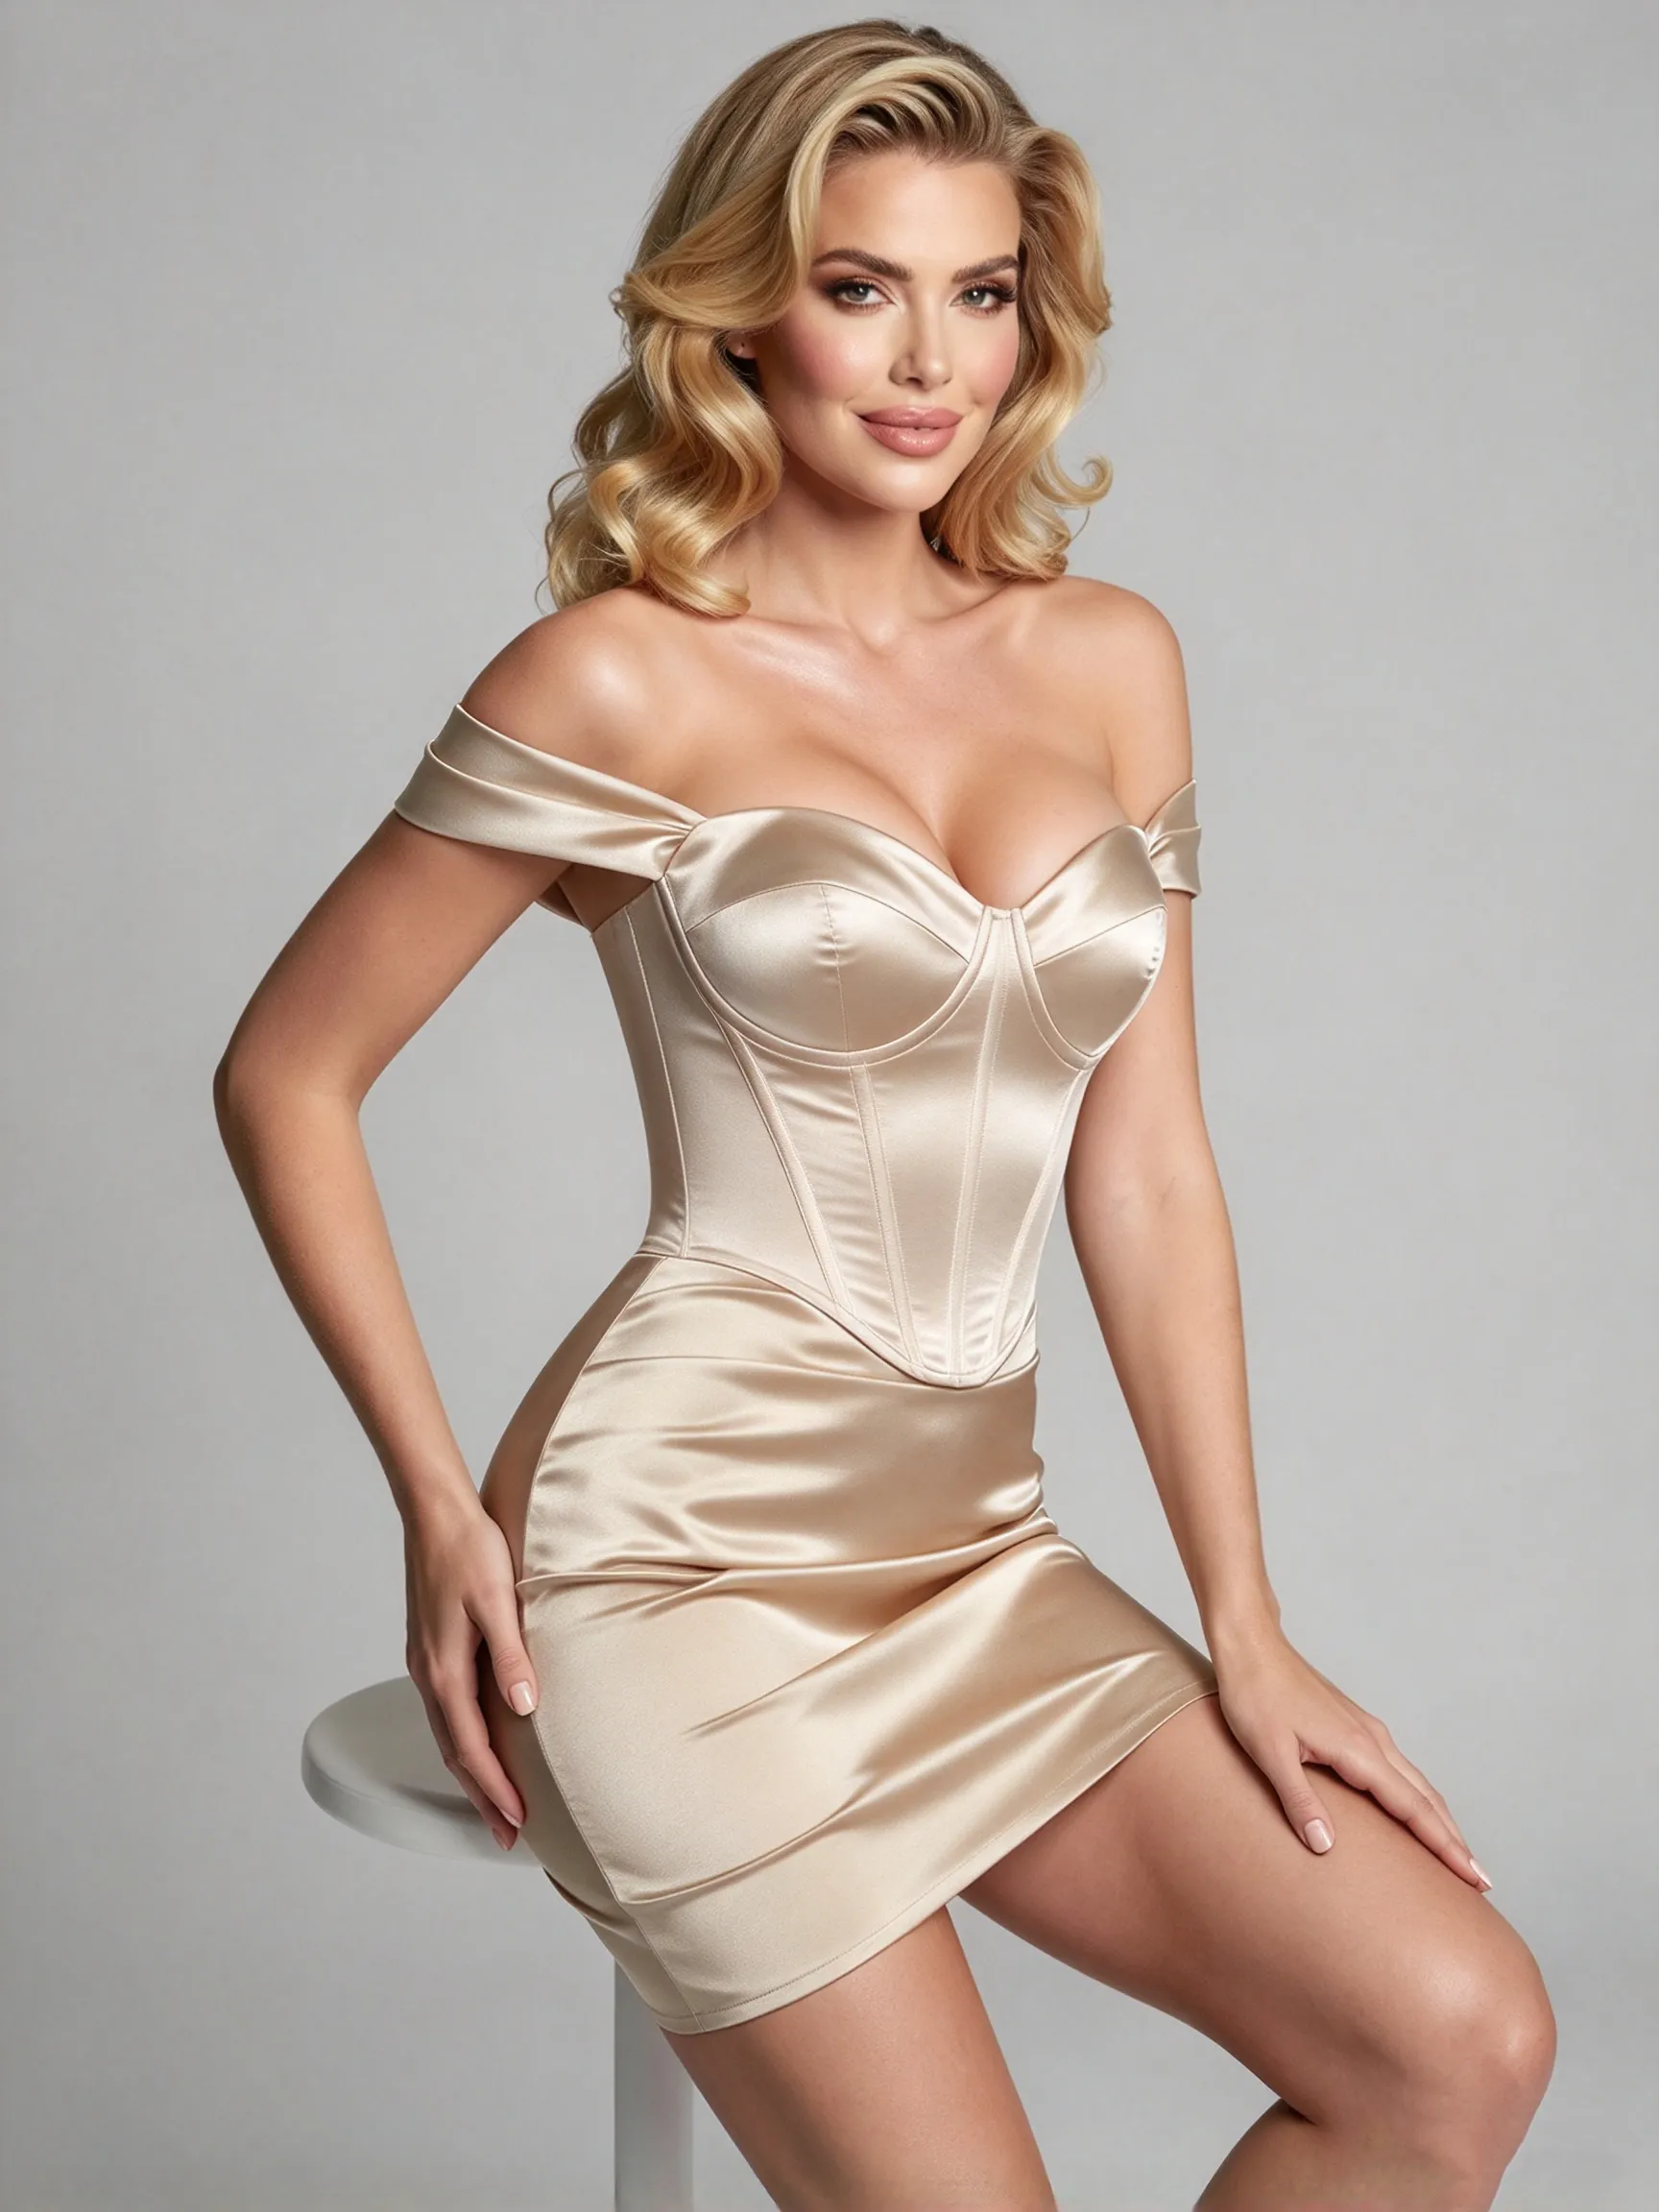 Referencia de movimiento
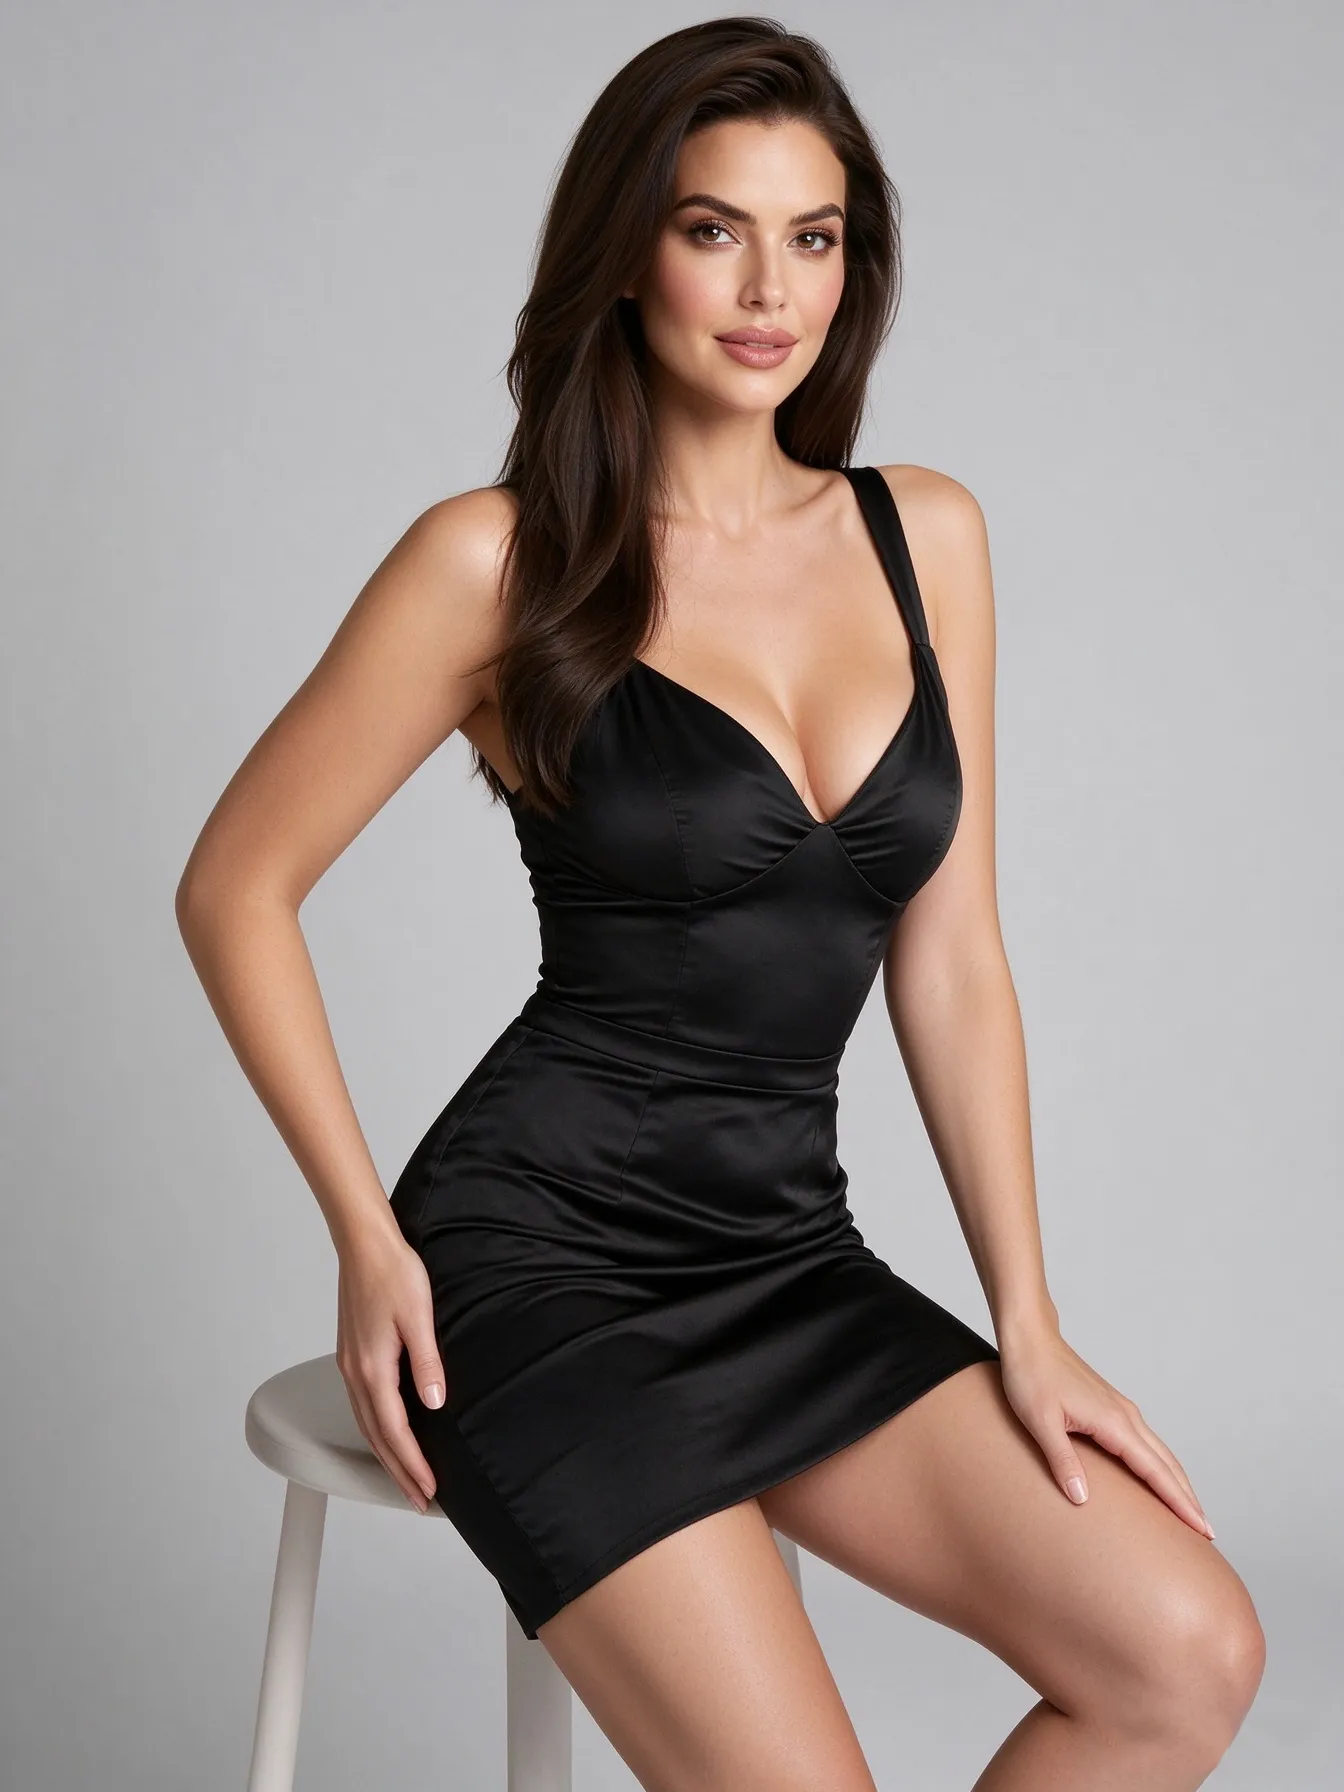 Resultado generado
4. Añade audio solo cuando tenga una función clara
Ref2VA puede usar audio extraído de un vídeo de referencia o cargado como archivo independiente. Según las reglas oficiales actuales, el audio no puede ser el único medio de referencia; debe acompañar a una imagen o un vídeo.
Decide si la fuente debe aportar:
- Una referencia de timbre de voz
- Una referencia de interpretación o emoción
- Diálogo o letra reutilizados
- Música de fondo reutilizada
- Una referencia de ritmo o estilo musical
- Una referencia de sonido ambiental
Referenciar una voz no equivale a copiar su señal original. Si el personaje debe decir un diálogo nuevo con una calidad vocal similar, define la fuente como referencia de timbre y escribe el diálogo nuevo en el prompt.
Las etiquetas de audio se numeran independientemente de las de vídeo. <Video 1> y <Audio 1> no se entienden automáticamente como partes del mismo archivo salvo que el prompt describa su relación.
Usa solo referencias de rostro, vídeo y voz propias o autorizadas. Ref2VA no debe utilizarse para suplantar a una persona identificable sin permiso.
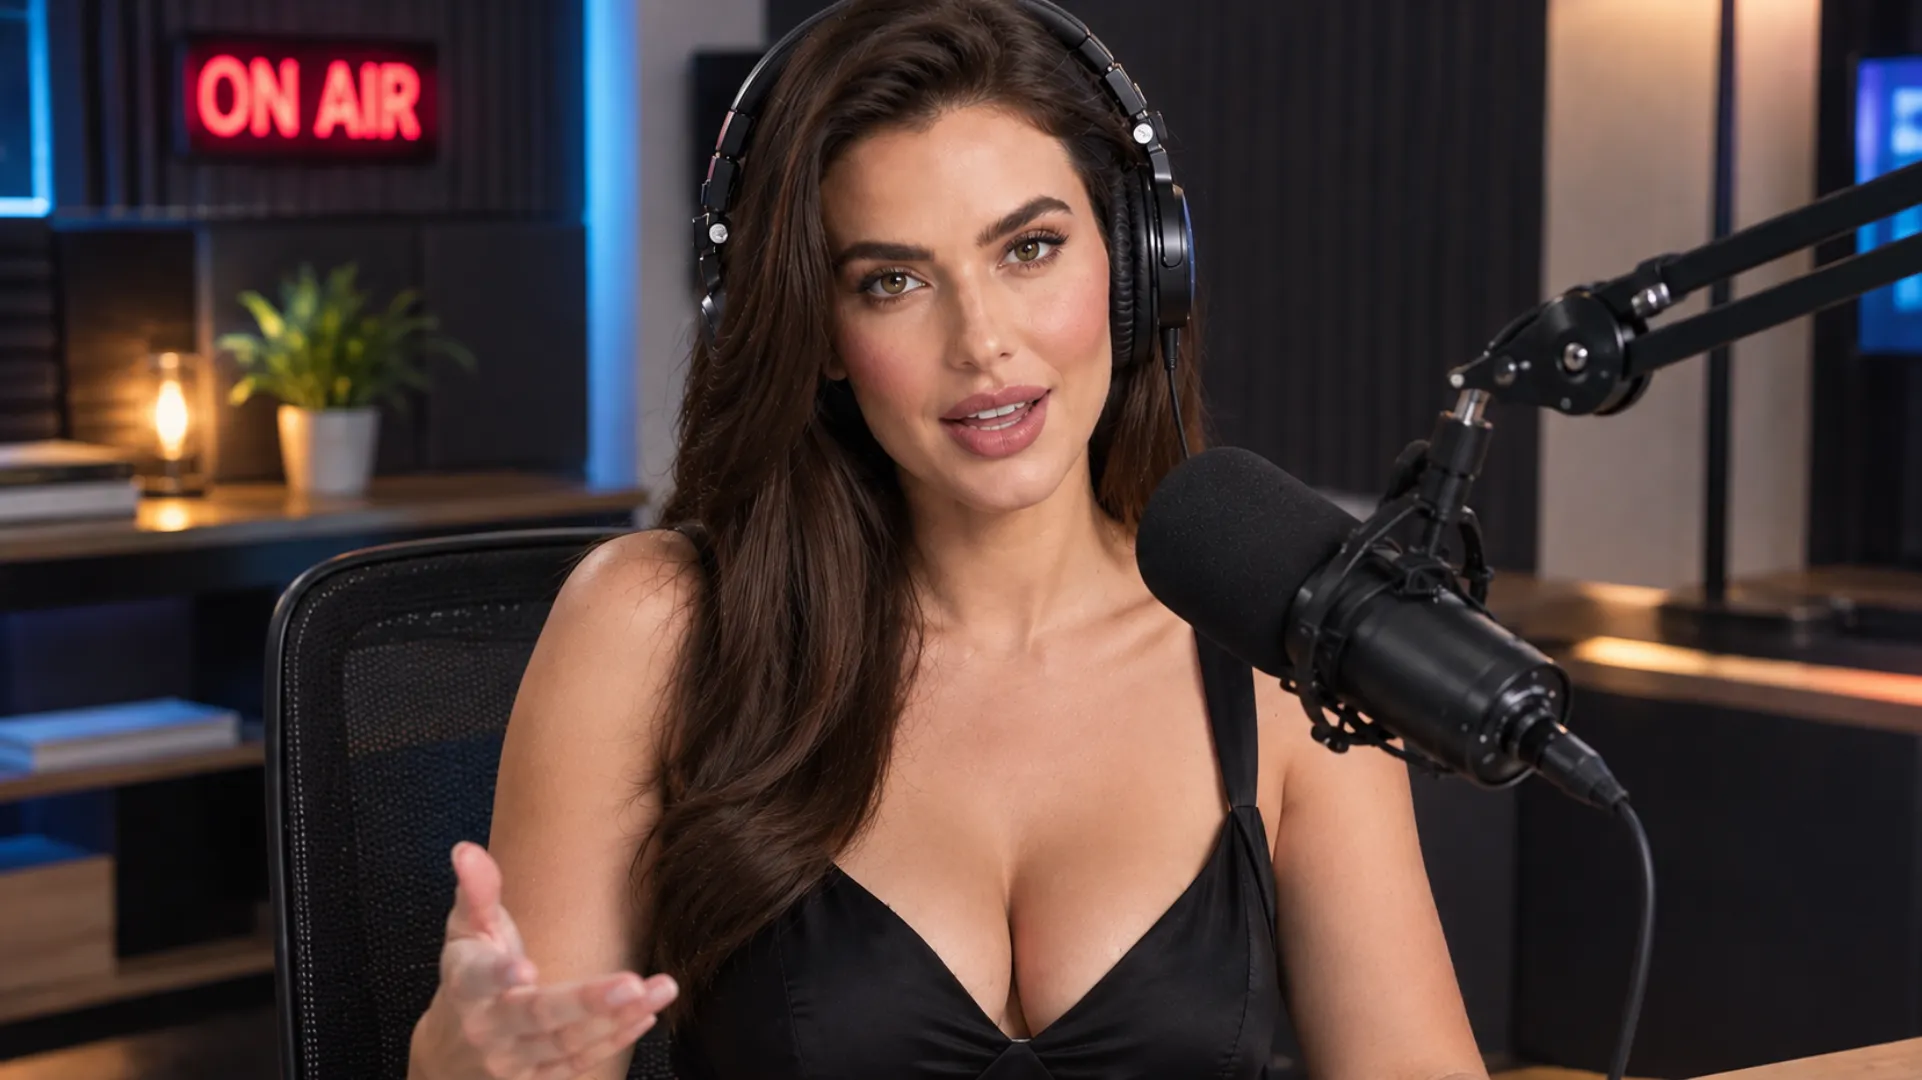 Escena de referencia de audio
5. Asigna las referencias de forma coherente
Nombra cada entrada con la misma etiqueta en todo el prompt:
<Picture 1> define la apariencia de <Subject 1>.
<Picture 2> aporta una vista más amplia del mismo personaje.
<Video 1> aporta el movimiento corporal y el tiempo de cámara.
<Audio 1> aporta el timbre de voz de <Subject 1>.
No menciones un número de imagen, vídeo o audio que no esté conectado. No cambies después el significado de <Picture 1>.
El flujo admite actualmente varias imágenes, vídeos y pistas de audio, pero la capacidad máxima no es una configuración inicial recomendable. Empieza con una imagen y una fuente de movimiento. Añade otra referencia solo cuando aporte información que falta.
6. Ejecuta un clip corto de validación
La primera generación debe contener:
- Un personaje
- Una acción principal
- Un plano
- Una cámara fija o contenida
- Un entorno sencillo
- Ningún diálogo ni música innecesarios
Comprueba el personaje antes de aumentar la complejidad. Rostro, proporciones, estilo, cobertura corporal visible y dirección de la pose deben mantenerse coherentes desde la apertura hasta el movimiento principal.
Cuando funcione el clip básico, añade una variable cada vez: una segunda vista del personaje, un vídeo de referencia, movimiento de cámara, audio u otra persona. Así podrás identificar qué fuente nueva cambió el resultado.
Cómo mantener coherente un personaje NSFW entre referencias
Usa distintas vistas del mismo personaje
Un conjunto útil puede incluir una vista clara del rostro, un plano medio y una vista corporal más amplia. Las imágenes deben aportar información distinta y conservar la misma identidad.
El rostro, el cabello, la piel, las proporciones y los detalles de estilo distintivos deben coincidir. Si una imagen cambia la estructura facial o el estilo visual, el modelo recibe dos definiciones de personaje enfrentadas.
Las referencias también deben coincidir con el estado visual del plano objetivo. Si una imagen muestra otra ropa o un nivel de cobertura muy distinto, decide cuál debe conservar el objetivo y elimina la fuente conflictiva.
Usar juntas
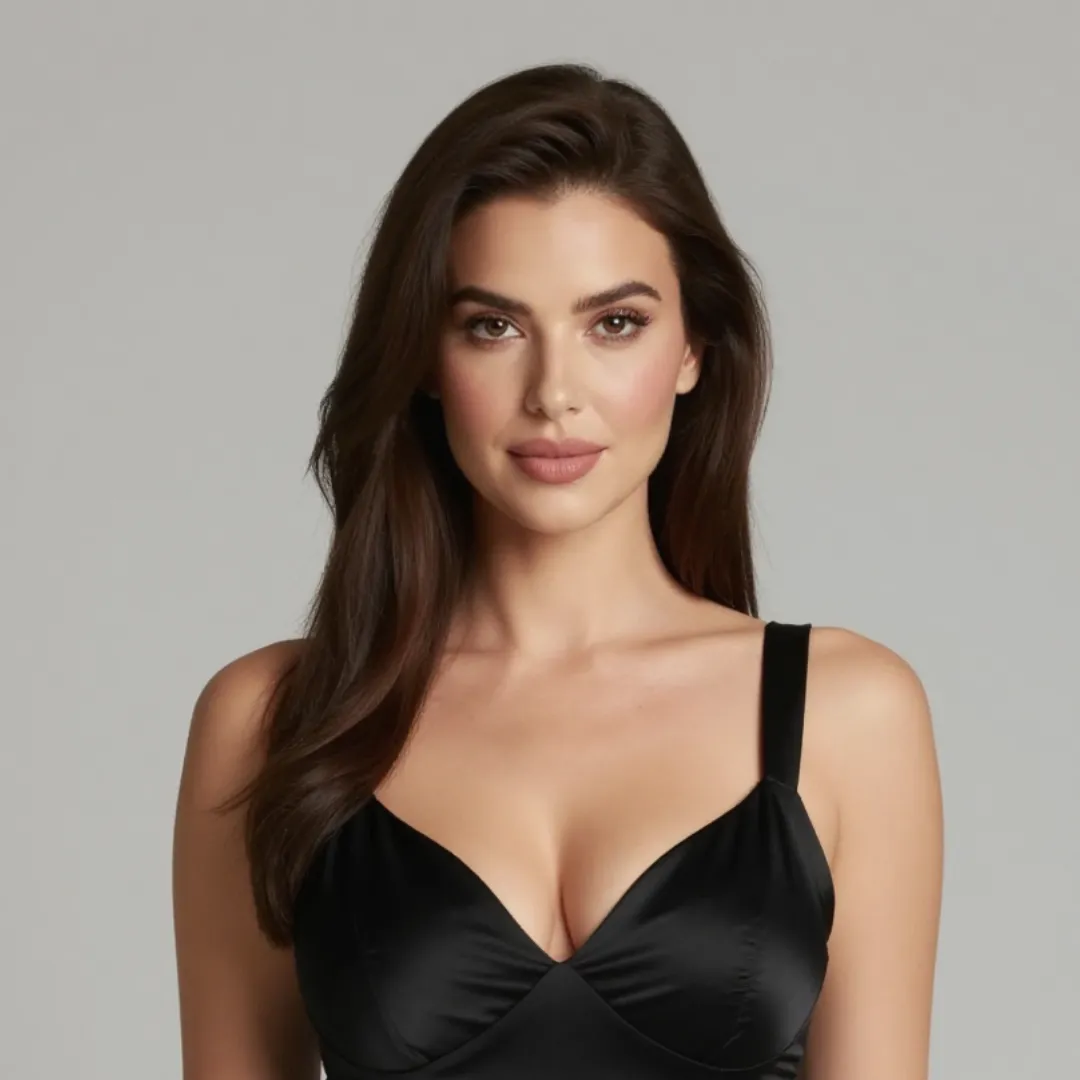
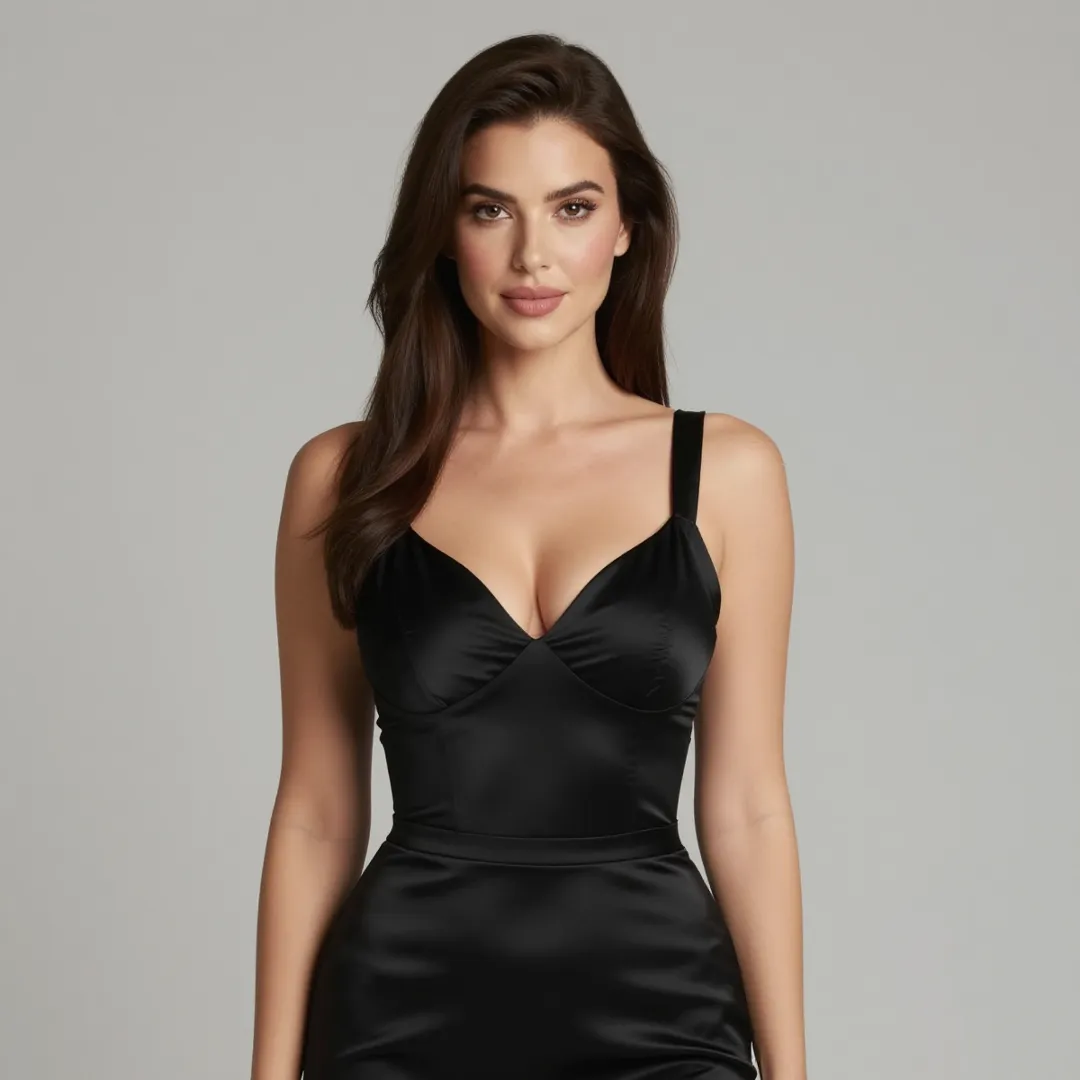
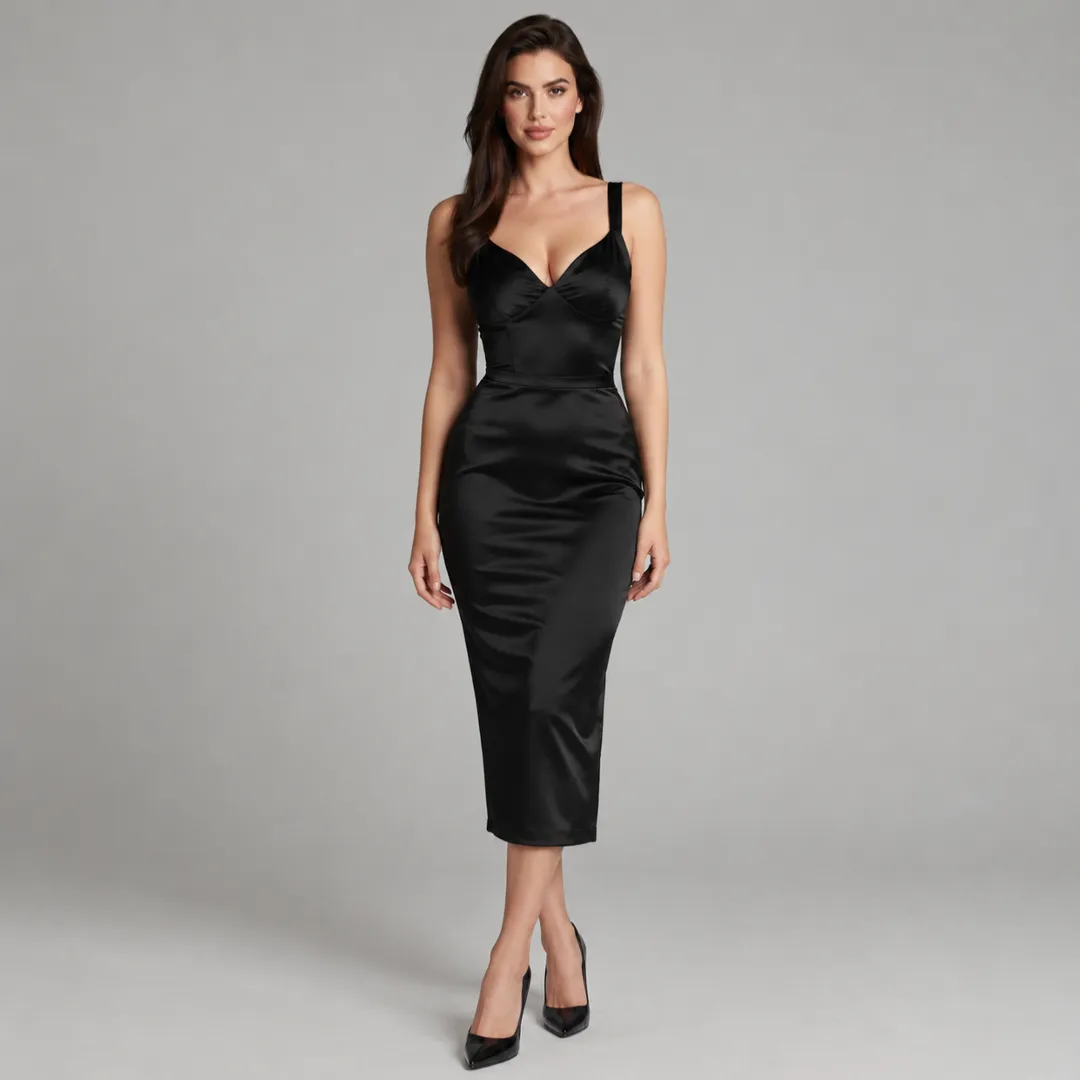
No mezclar
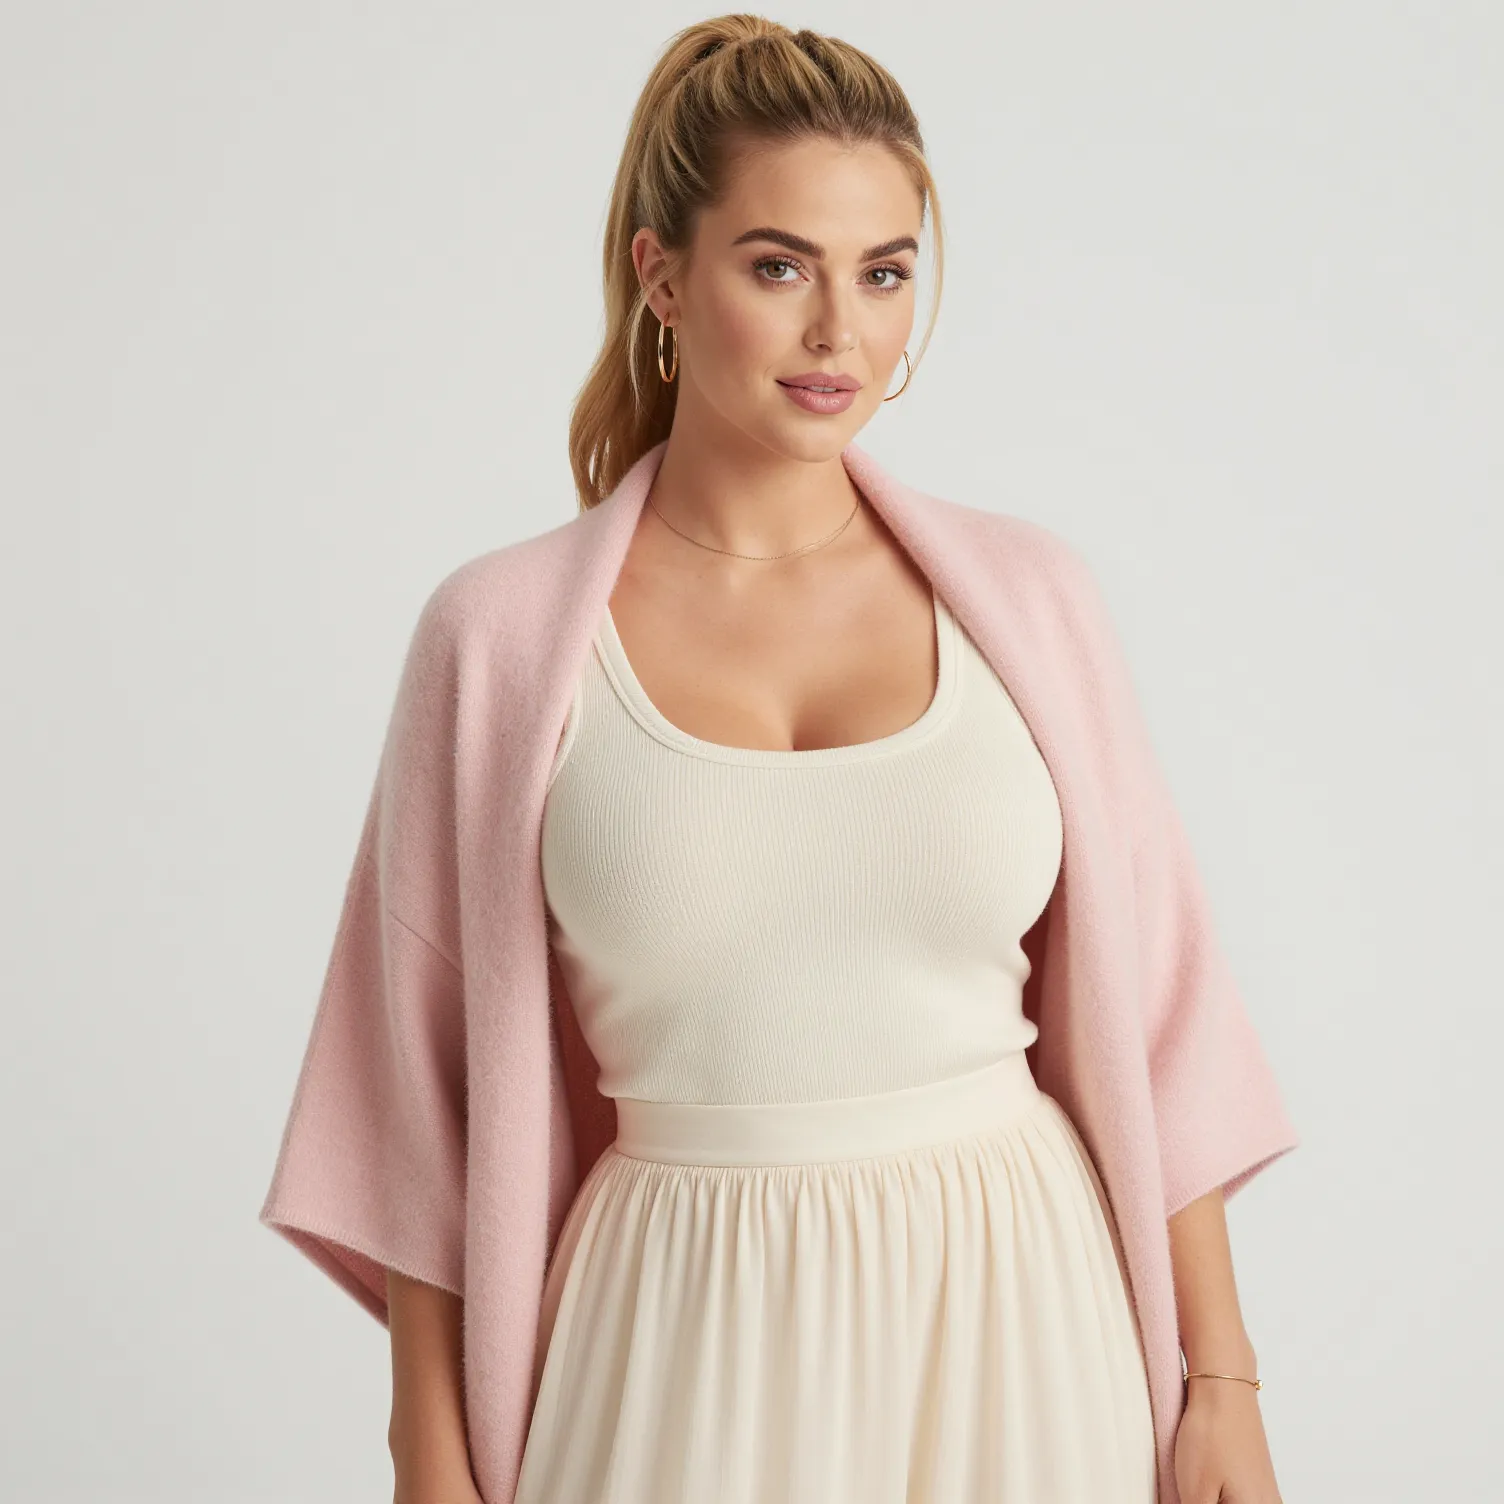
Haz coincidir la imagen de referencia con el movimiento
Elige una imagen de identidad que ya muestre la zona corporal implicada. Si el movimiento cruza la cintura, cambia una postura sentada o coloca una mano sobre el torso, esas zonas deben verse claras y estructuradas en la fuente.
La dificultad aumenta cuando el modelo debe revelar anatomía oculta, separar extremidades superpuestas o mantener varios puntos de contacto. Por eso una pose visualmente sencilla puede ser mejor referencia de identidad que una imagen más dramática.
Evita que la fuente de movimiento sustituya al personaje
Un vídeo de movimiento puede contener una intérprete cuyo rostro, cuerpo, ropa o entorno sea visualmente más fuerte que la imagen de identidad. El modelo puede conservar más de esa fuente de lo previsto.
Define el sujeto objetivo antes de describir el movimiento. Indica expresamente que no se conserva la intérprete de referencia. Si la identidad sigue debilitándose, elige un clip donde el rostro de origen sea menos prominente o la pose sea más compatible.
Prueba la interacción cercana por separado
La interacción entre dos personas añade otra identidad, más extremidades, oclusión temporal y varios puntos de contacto móviles. No la uses como primera prueba de un personaje nuevo.
Valida primero al personaje principal a solas y añade después el segundo sujeto en un plano corto y controlado. Mantén ambos cuerpos separados visualmente cuando sea posible y evita cambiar a la vez varias manos, rostros y movimientos de cámara.
Para una secuencia más larga, crea clips separados para la introducción, el cambio de pose, la interacción cercana y el plano final. Reutiliza las referencias de identidad aprobadas en lugar de exigir una sola generación para todas las transiciones.
Cómo escribir prompts Ref2VA coherentes para personaje y movimiento NSFW
Un prompt Ref2VA debe explicar el vídeo objetivo y su relación con las fuentes. Repetir adjetivos de apariencia no sustituye una asignación clara de referencias.
El formato de prompt de referencia completa de MiniMax organiza una solicitud Ref2VA en seis secciones:
subject_definitions:
<Subject 1> es la mujer ficticia adulta cuya identidad facial, pelo largo oscuro, proporciones corporales y estilo de satén negro proceden de <Picture 1>.
<Picture 2> ofrece una vista más amplia del mismo personaje y confirma sus proporciones y postura inicial.
<Video 1> aporta un ajuste lento de la pose sentada y un avance de cámara contenido.
<Audio 1> es la referencia de timbre vocal de <Subject 1> (S1).

summary:
[generación con referencia + referencia de audio]
El objetivo es un vídeo de estudio privado en un solo plano de <Subject 1>. Su identidad y estilo siguen <Picture 1> y <Picture 2>. Su movimiento y tiempo de cámara siguen <Video 1>. Su timbre vocal toma como referencia <Audio 1>.

retention_analysis:
<Subject 1>: fully_preserved - conservar rostro, pelo, proporciones, estilo de satén y estado visual general.
<Video 1>: reference - transferir el cambio de pose y el ritmo de cámara sin conservar la intérprete ni el entorno originales.
<Audio 1>: reference - guiar el timbre vocal sin copiar la grabación.

detailed_description:
El vídeo usa iluminación fotográfica realista en un estudio privado y tranquilo.
[Shot 1] <Subject 1> está sentada en un plano medio de tres cuartos. Siguiendo el movimiento controlado de <Video 1>, desplaza lentamente el peso, gira un hombro hacia la cámara y se asienta en la nueva pose. La cámara realiza un único avance contenido sin cambiar el ángulo. <Subject 1> (S1), con la calidad vocal tranquila referenciada en <Audio 1>, dice: <d>[Español] Quédate aquí un momento.</d>

overall_soundscape:
Tono de sala silencioso, movimiento sutil de tela y la interpretación vocal referenciada.

non_diegetic_music:
Sin música de fondo.
Este prompt define la identidad una vez y dedica el resto al movimiento, la cámara y el sonido. Evita repetir la descripción del rostro y el cuerpo en cada campo.
Si el resultado necesita un plano continuo, no añadas varias instrucciones de cámara inconexas. Si una segunda acción exige nueva pose, encuadre o patrón de contacto, quizá merezca un clip separado.
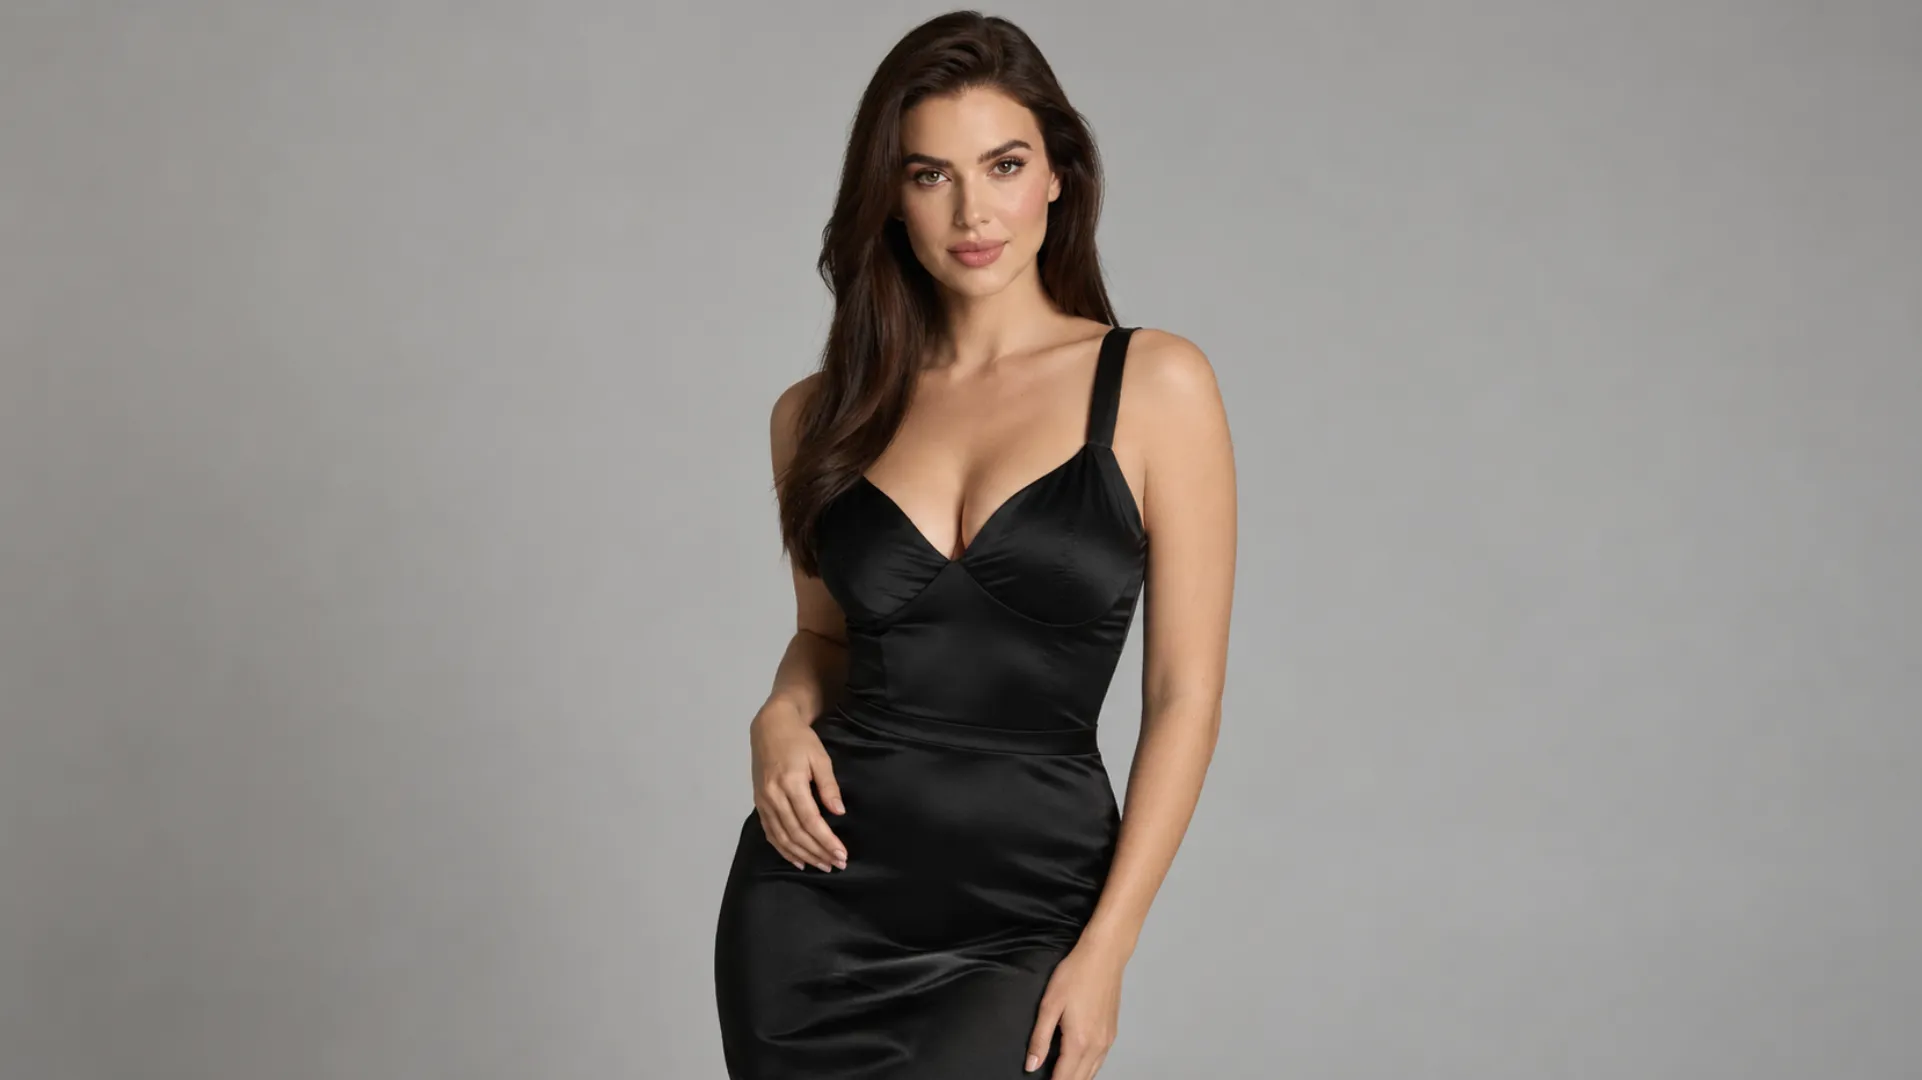 Escena NSFW
Flujo práctico de MiniMax H3 Ref2VA para vídeos NSFW con IA
Un flujo de producción reutilizable solo debe aumentar la complejidad cuando la capa anterior permanezca estable.
Paso 1: aprueba la imagen del personaje
Elige una imagen que establezca identidad, orientación corporal, estilo y estado visual. Si no existe una adecuada, créala con el Generador de chica real de AINSFW.AI, el Generador de chica anime o Imágenes desde etiquetas.
No continúes solo porque la imagen sea atractiva. Confirma que aporta suficiente información visual para la primera acción prevista.
Paso 2: crea una prueba de identidad
Genera un plano corto, cercano o medio, con movimiento de ojos, respiración, un leve cambio de expresión o un pequeño giro de cabeza. Así sabrás si el personaje sigue siendo reconocible antes de introducir movimiento corporal mayor.
Paso 3: añade movimiento corporal controlado
Usa una referencia de identidad más amplia y solicita un solo ajuste de hombro, torso, cintura o postura sentada. Mantén la cámara fija en la primera prueba de movimiento corporal.
Si el personaje cambia durante un movimiento pequeño, una fuente más compleja suele hacer más visible ese cambio.
Paso 4: introduce la referencia de movimiento
Conecta un vídeo corto con una pose inicial compatible. Indica que aporta movimiento y tiempo de cámara, no identidad.
Compara el resultado con la prueba de identidad anterior. Si el objetivo empieza a parecerse a la intérprete de referencia, simplifica el vídeo fuente o aclara la asignación del sujeto.
Paso 5: añade cámara y audio
Cuando el movimiento corporal sea estable, introduce un comportamiento de cámara. Añade voz, ambiente o música después de que las referencias visuales funcionen juntas.
No cambies en la misma prueba la fuente de movimiento, cámara, audio, estructura del prompt y ajustes de generación. Un resultado satisfactorio vale más cuando su causa es comprensible.
Paso 6: crea planos de vídeo independientes
Crea clips separados para distintas funciones de producción:
- Plano de identidad: encuadre cercano o medio con expresión sutil.
- Plano de pose: una transición corporal o postural controlada.
- Plano de movimiento amplio: un movimiento mayor respaldado por una referencia más abierta.
- Plano de interacción: un clip probado por separado con contacto adicional u otro sujeto.
Genera cada clip desde el conjunto aprobado en vez de usar el resultado anterior como única fuente del siguiente. Esto reduce la deriva acumulada de identidad.
Si los modelos locales, la asignación de referencias y el mantenimiento de ComfyUI ofrecen más control del necesario, usa la imagen aprobada con el Generador de imagen a vídeo de AINSFW.AI. Es la ruta más simple cuando se parte de una imagen y no se necesitan varias referencias de vídeo o audio.
Preguntas frecuentes sobre MiniMax H3 Ref2VA
¿MiniMax H3 Ref2VA es lo mismo que MiniMax H3 R2V?
En la documentación actual de ComfyUI, la plantilla puede llamarse MiniMax H3 R2V, mientras la tarea y el checkpoint usan ref2va. Aquí ambos nombres se refieren al flujo de referencia a audio-vídeo, no a la ruta de fotogramas clave FL2VA.
¿Puede Ref2VA usar varias imágenes del personaje?
Sí. El flujo oficial actual admite varias referencias de imagen. Usa imágenes adicionales para aportar ángulos compatibles, información corporal, estilo o detalles de entorno. Las imágenes que discrepan en identidad o proporciones pueden reducir la coherencia.
¿Por qué un vídeo cargado no se conecta a la entrada Ref2VA?
El cargador puede producir un objeto VIDEO mientras la entrada espera fotogramas extraídos. Usa el nodo nativo Get Video Components de ComfyUI cuando sea necesario para separar la secuencia, el audio y los metadatos.
¿Puede Ref2VA combinar imágenes, vídeo y audio?
Sí. Ref2VA está diseñado para referencias multimodales mixtas. Conecta al menos una imagen o vídeo, etiqueta cada fuente de forma coherente e indica si aporta identidad, movimiento, cámara, audio reutilizable o una característica vocal.
¿Garantiza Ref2VA un personaje NSFW coherente?
No. Ref2VA aporta más información de referencia, pero la coherencia sigue dependiendo de fuentes compatibles, información corporal visible, compatibilidad de pose, claridad del prompt, complejidad del movimiento y oclusión. Siguen siendo necesarias pruebas cortas y adiciones controladas.