
クイック回答:MiniMax H3 Ref2VAをNSFW動画に使う方法
互換性のあるComfyUI R2Vワークフローで専用のMiniMax H3 Ref2VAチェックポイントを使います。承認済みのキャラクター画像1枚から始め、<Picture 1>として接続し、プロンプトで継続する被写体を定義します。特定の動き、カメラパターン、編集構成、続きが必要な場合だけ参照動画を追加します。声、音楽、リズム、再利用するサウンドトラックを導く場合は音声を別に接続します。
NSFW動画では、キャラクターの同一性、単純な身体動作、カメラ動作、接近した相互作用の順に制作するのが最も安全です。別の参照を加える前に、各追加要素を短いクリップで試してください。
Ref2VAは参照ベースの制御を改善しますが、完全な同一性や解剖学的正確さを保証しません。結果は、互換性のあるポーズ、明確な身体境界、一貫した画像、曖昧さのないプロンプトに依存します。
安定した開始キャラクターがない場合は、Ref2VAワークフローを組む前にAINSFW.AI画像ジェネレーターで作成して承認します。
 NSFWキャラクター例
MiniMax H3 Ref2VAとFL2VA:どちらのワークフローを使うべきか
MiniMax H3はタスク別にチェックポイントが分かれています。FL2VAはテキストから音声動画、および先頭・末尾フレーム条件付き生成を扱います。Ref2VAは画像、動画、音声、混合参照による参照から音声動画を扱います。
| 目的 | 推奨ルート |
|---|---|
| テキストからシーンを生成 | FL2VAのT2VA |
| 正確な開始フレームをアニメーション化 | FL2VAのI2VA |
| 開始フレームと終了フレームを接続 | FL2VA |
| 画像を0フレームに固定せずキャラクターを維持 | Ref2VA |
| 動きやカメラ挙動を転写 | Ref2VA |
| 声、サウンドトラック、リズム、音の質感を参照 | Ref2VA |
| 既存の音声動画ソースを編集・継続 | Ref2VA |
違いは素材の役割です。先頭フレームとして接続した画像は実際の開始構図を決めます。同じ画像をRef2VAで使う場合は、先頭フレームにならずに顔、身体、スタイル、環境、ポーズを定義できます。
これはNSFWキャラクターのワークフローで重要です。開始画像1枚でクリップを固定できても、身体の回転、ワイド化、別の被写体による一時的な遮蔽では情報が不足することがあります。同じキャラクターを示す限り、Ref2VAは追加の同一性ビューを使えます。
2つのワークフローは拡散重みも異なります。周囲のノードが互換に見えても、Ref2VAワークフローへFL2VA重みを読み込むだけではマルチモーダル参照動作になりません。
ComfyUIでMiniMax H3 Ref2VAを設定する方法
1. Ref2VAモデルとワークフローを読み込む
ワークフローを開く前にComfyUIを更新してください。古い環境には、最近のMiniMax H3ネイティブノードやテンプレートがない場合があります。
テンプレートライブラリでMiniMax H3 R2Vを検索するか、現在の公式ワークフローJSONを使います。テンプレート名は「R2V」でも、チェックポイントとタスクはref2vaと表記されることがあります。ここでは同じ参照動画ルートを指します。
標準のComfyUIフォルダー構成では、Ref2VA拡散モデルをmodels/diffusion_models、テキストエンコーダーをmodels/text_encoders、動画・音声VAEをmodels/vae、任意のturbo LoRAをmodels/lorasに置きます。
ワークフローがFL2VA版ではなくRef2VA拡散モデルを読み込むことを確認します。BF16、INT8、NVFP4などはローダーやメモリ設定が異なる場合があるため、現在のテンプレートが指定するファイルを使います。
最初のテストは通常の生成経路を使います。任意の4ステップturbo LoRAは反復を速めますが、公式文書では動きと音声品質が低下する可能性が示されています。
2. 承認済みキャラクター参照を1枚追加する
完全なギャラリーではなく、1枚のキャラクター画像から始めます。顔が明瞭で、対象となる身体部位が見え、ポーズの境界が読み取れる必要があります。
会話するクローズアップなら、鮮明な顔と上半身の参照で足りる場合があります。座位調整や広い官能的動作では、肩、胴、腰、手、開始姿勢が見える画像を使います。強く切り抜いた肖像に、含まれていない身体情報を求めないでください。
画像を最初の画像参照入力へ接続します。プロンプトでは<Picture 1>になります。追加画像は接続順に番号が付きます。
最も強い同一性画像で、次を決めます:
- 顔の形と識別できる特徴
- 髪と肌の外観
- 対象ショットで見える身体比率
- 維持するスタイルや着衣状態
- 開始ポーズと身体の向き
異なる顔、髪型、比率、画風の複数版を最初から接続しないでください。参照は互換性のある情報を追加するときだけ役立ちます。
3. モーション参照動画を接続する
参照動画は身体動作、カメラ挙動、編集リズム、変更する既存シーン、継続地点を提供できます。プロンプトで意図する関係を明示する必要があります。
一部のComfyUI動画ローダーはVIDEOオブジェクトを返しますが、MiniMax H3参照入力は抽出済み画像列を要求します。ポートが接続できない場合は、ネイティブのGet Video Componentsノードでフレーム、音声、フレームレートなどを展開し、フレーム列を参照動画入力へ接続します。
元のサウンドトラックも必要なら、抽出音声を別に接続します。動画を読み込むだけで音声が使用可能な<Audio N>参照になるとは限りません。
モーション転写では、開始姿勢が対象キャラクターに似たソースを選びます。座ったキャラクターと座った動作ソースは、顔のクローズアップから直ちに全身の立ち回転へ移る組み合わせより調整しやすいです。
動きは視覚的にも読み取れる必要があります。身体の大きな重なり、胴の後ろの手、関節を覆う長い髪、交差する2人の演者は、どのソースにも明確でない情報の再構築をモデルに強います。
動画は同一性ではなく動きを提供すると明記します:
<Subject 1>は<Picture 1>から同一性と外見を取得する。
<Video 1>はゆっくりした座位調整とカメラのリズムだけを提供する。
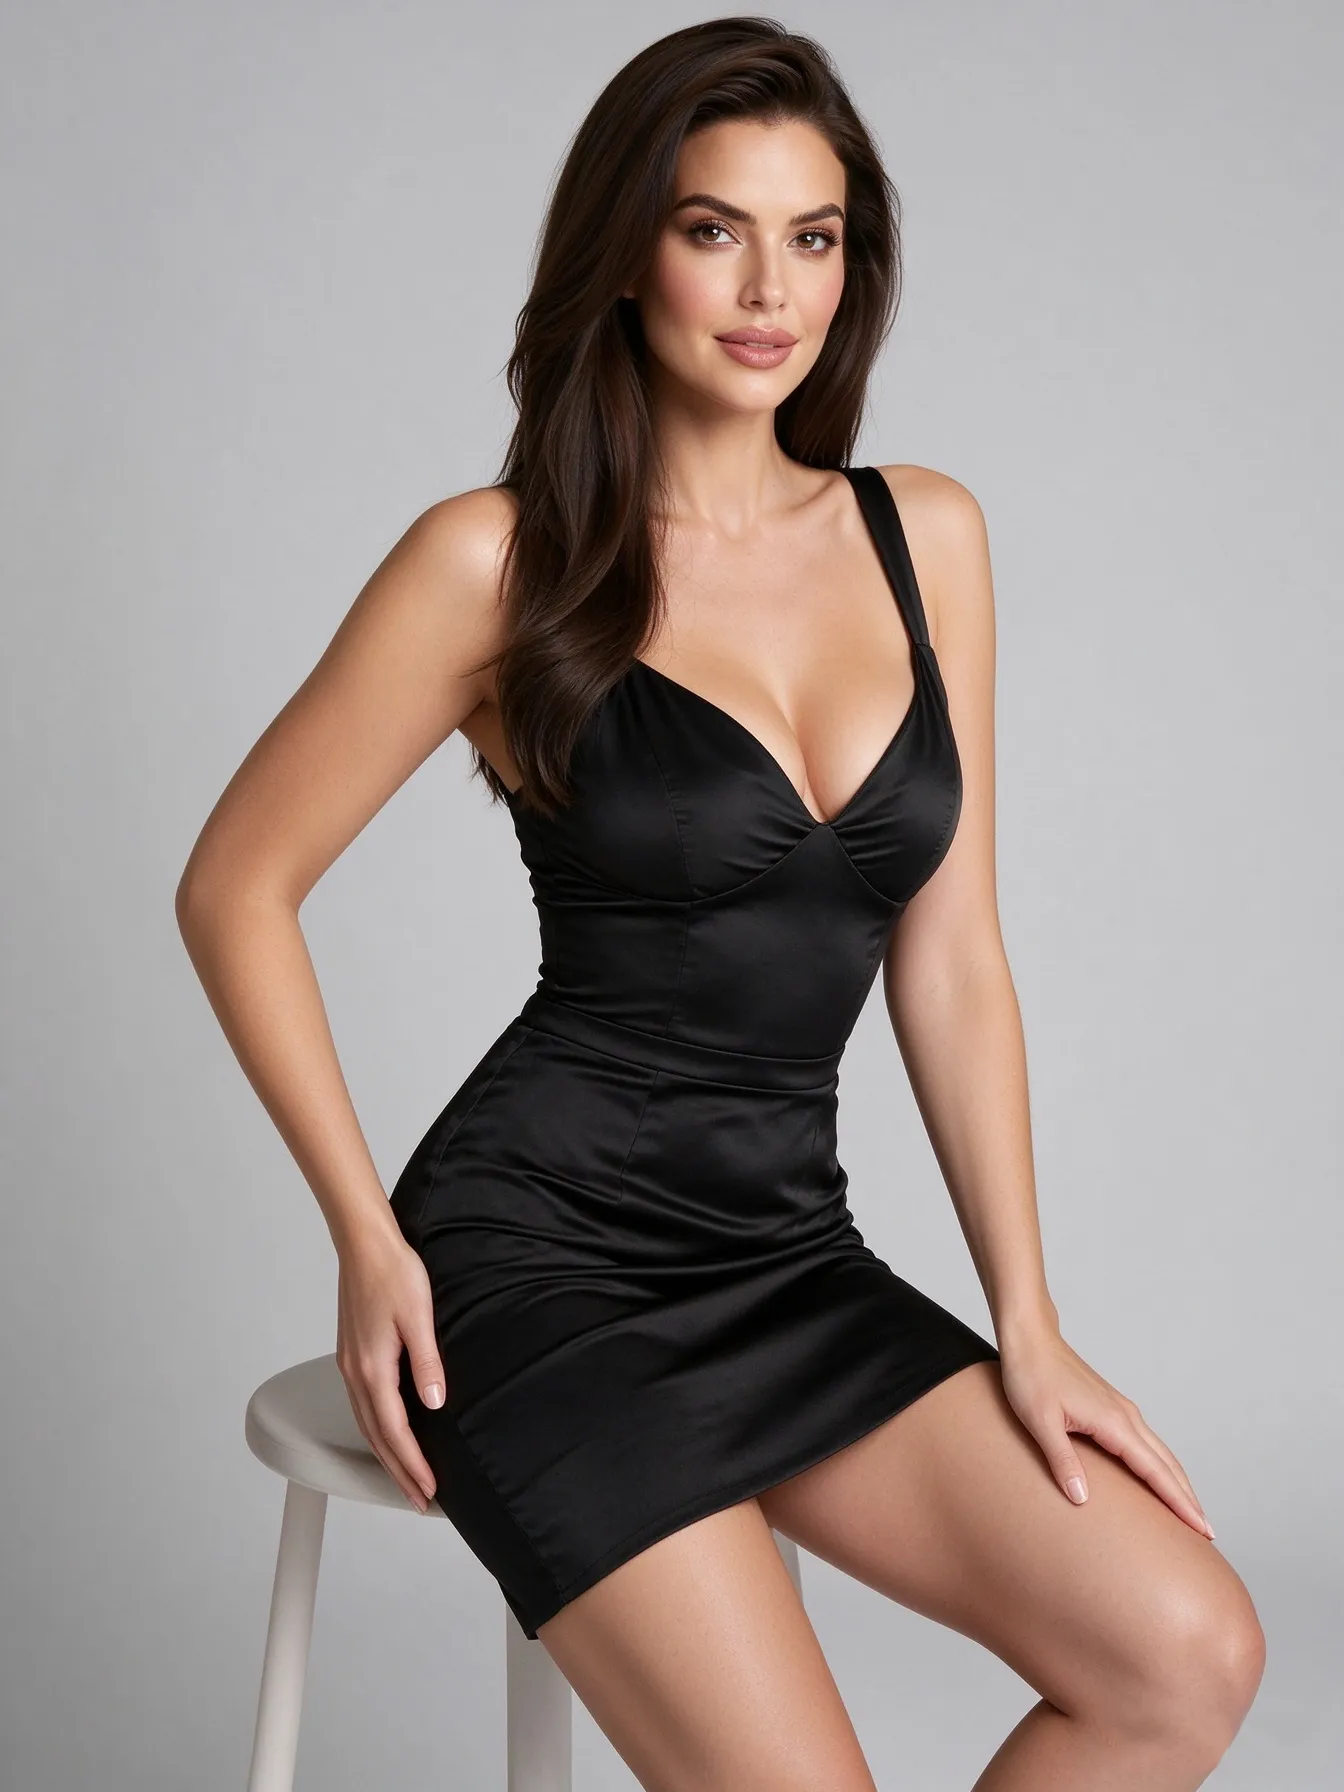
<Video 1>の演者は対象動画に保持しない。 キャラクター参照
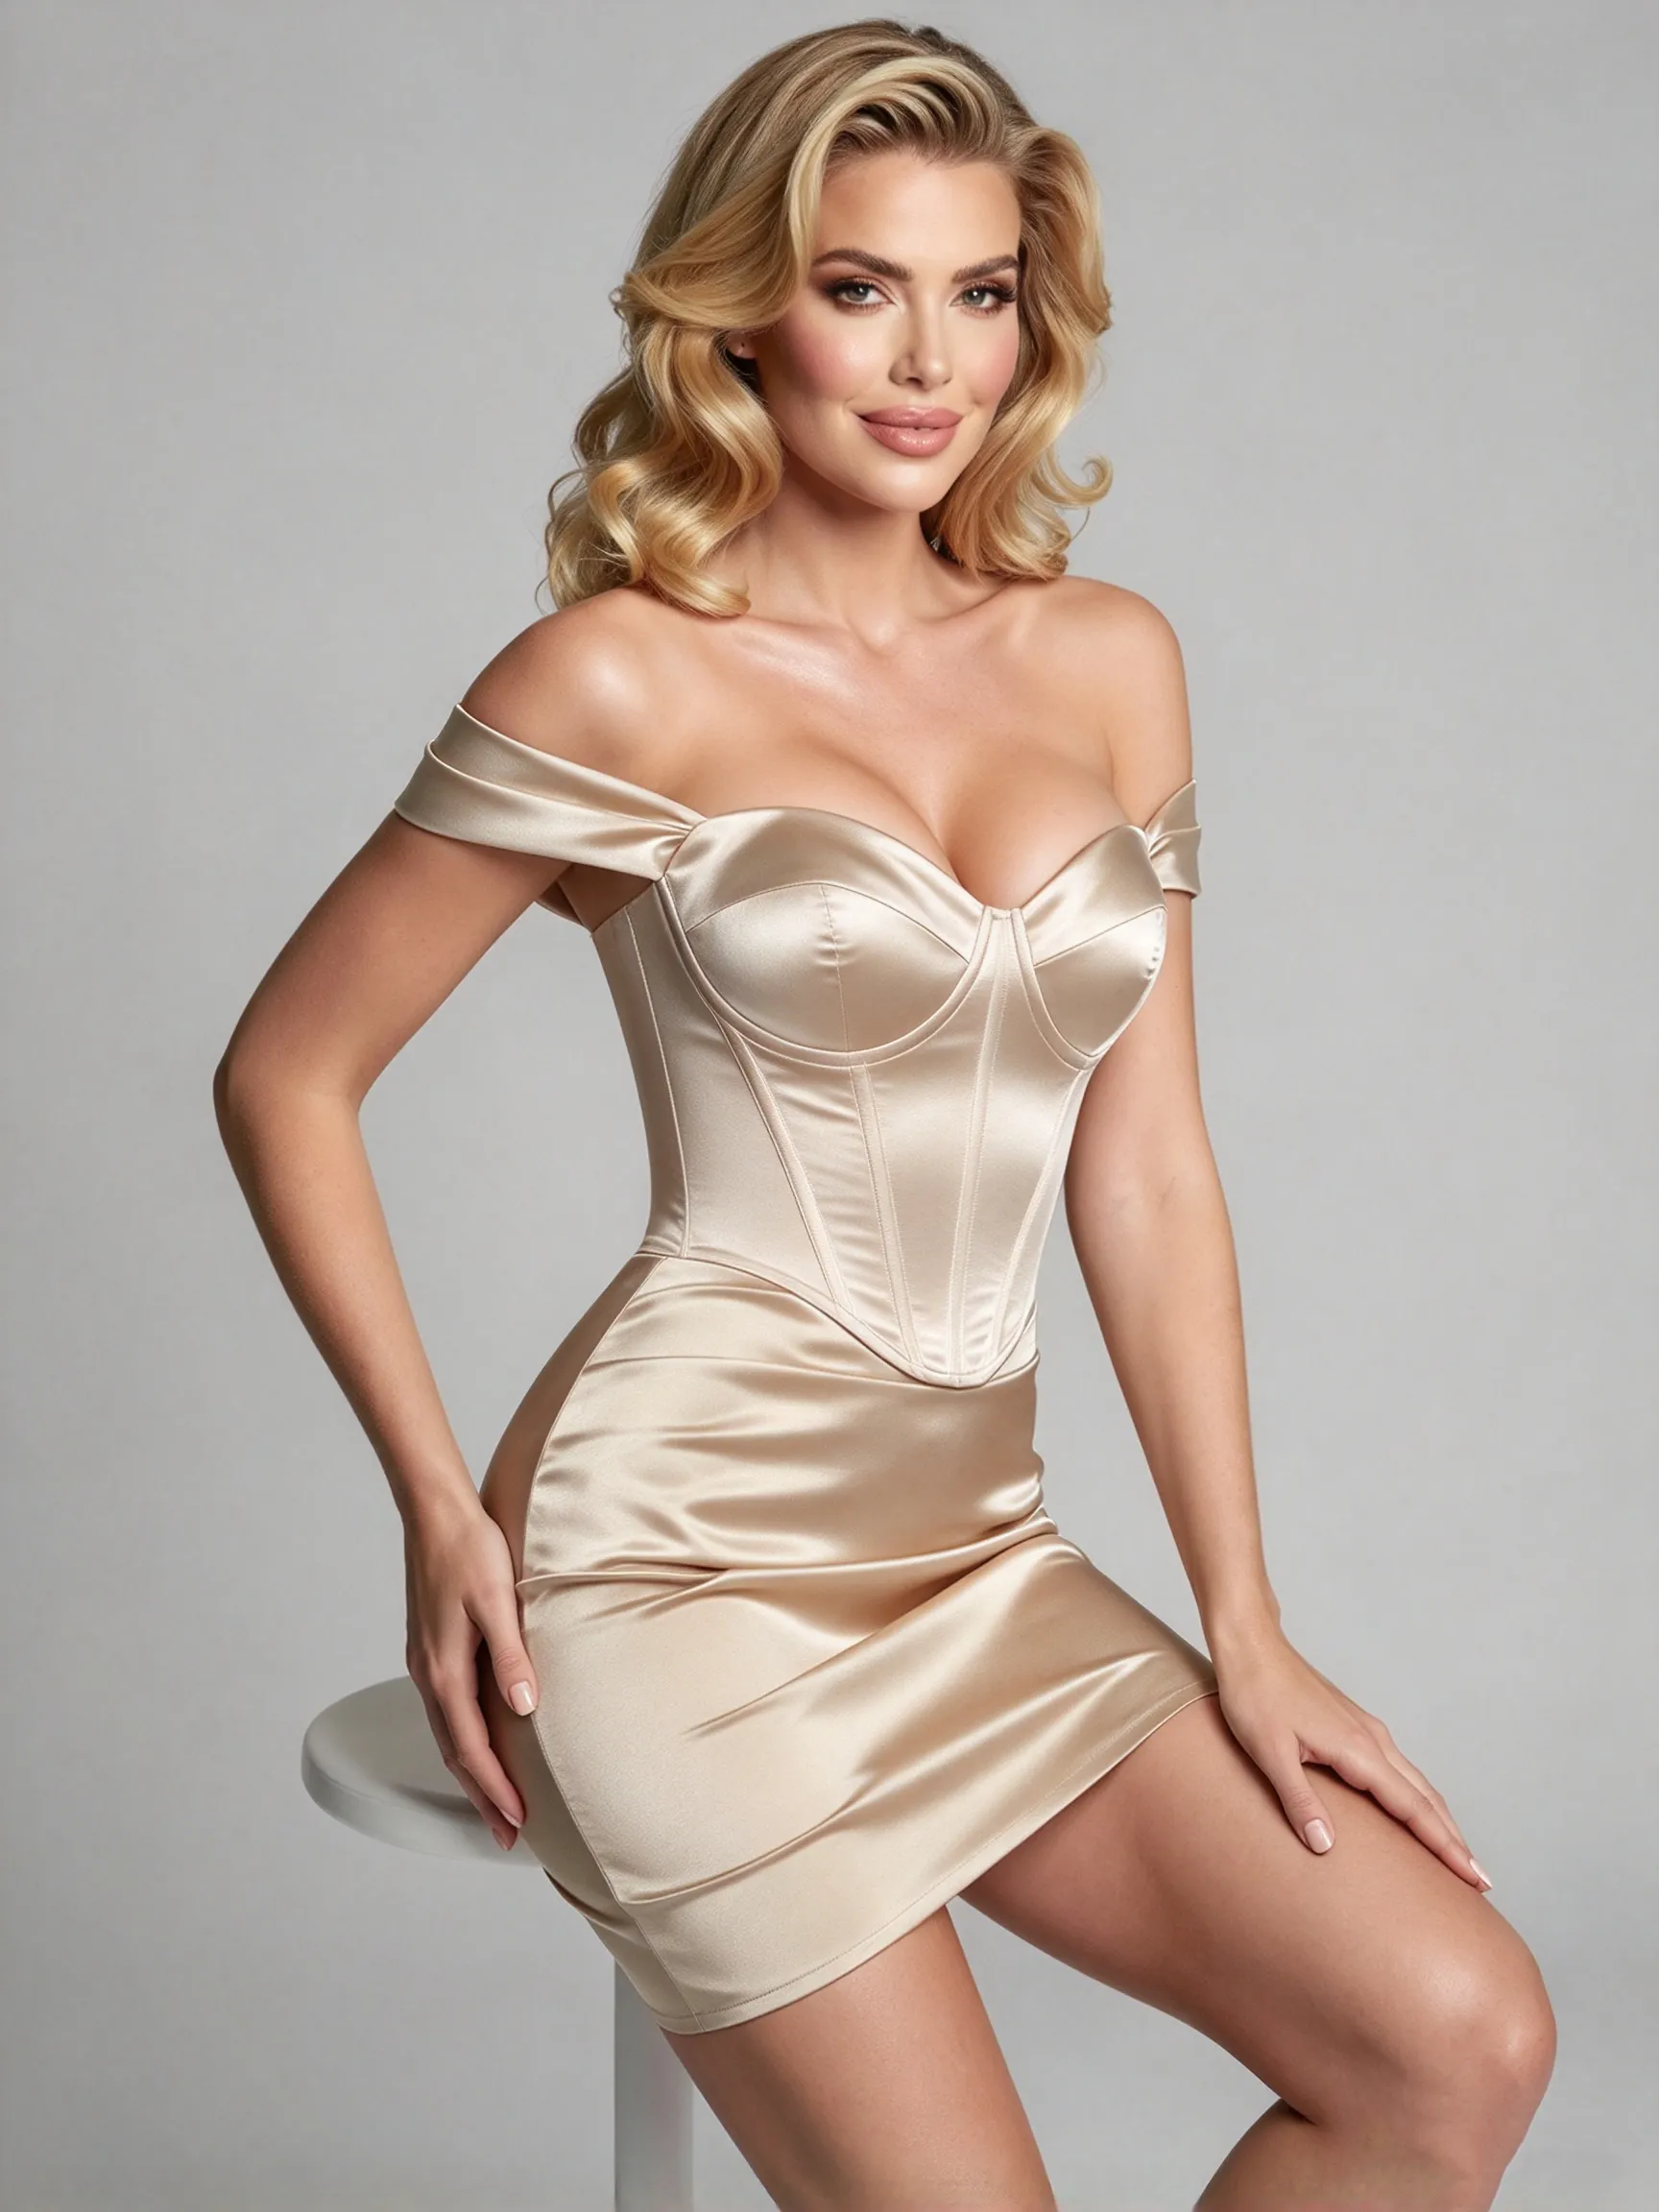 モーション参照
 生成結果
4. 明確な役割がある場合だけ音声を追加する
Ref2VAは参照動画から抽出した音声、または別ファイルの音声を使えます。現在の公式入力ルールでは、音声だけを参照媒体にできず、画像か動画を伴う必要があります。
ソースの役割を次から決めます:
- 声質の参照
- 話し方や感情の参照
- 再利用する台詞や歌詞
- 再利用する背景音楽
- リズムや音楽スタイルの参照
- 環境音の参照
声の参照は元の信号をコピーすることではありません。似た声質で新しい台詞を話す場合は、声質参照として定義し、新しい台詞をプロンプトに書きます。
音声ラベルは動画ラベルとは別に番号付けされます。プロンプトで関係を示さない限り、<Video 1>と<Audio 1>が同じファイルの一部とは自動的に理解されません。
自分が所有するか許諾された顔、動画、声の参照だけを使ってください。識別可能な人物を無断でなりすますためにRef2VAを使ってはいけません。
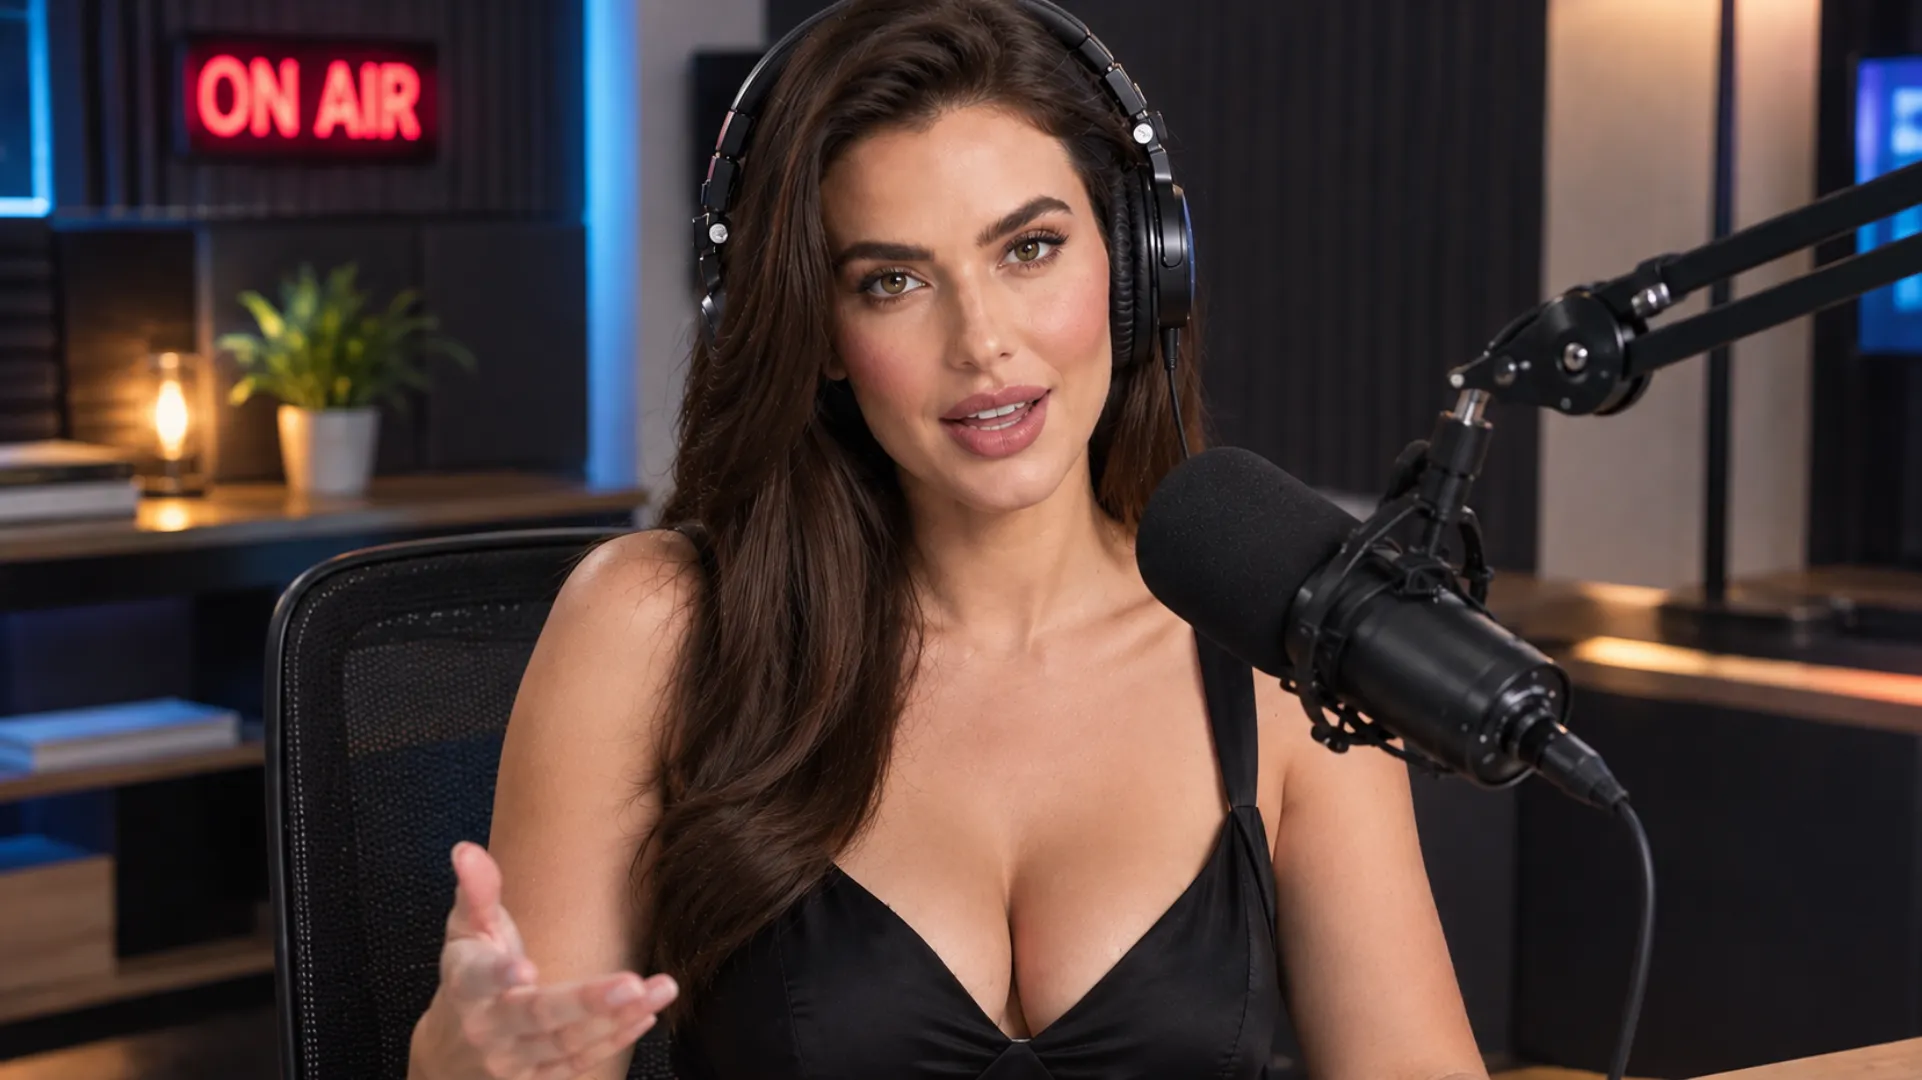 音声参照シーン
5. 参照を一貫して割り当てる
プロンプト全体で各入力に同じラベルを使います:
<Picture 1>は<Subject 1>の外見を定義する。
<Picture 2>は同じキャラクターの広いビューを提供する。
<Video 1>は身体動作とカメラタイミングを提供する。
<Audio 1>は<Subject 1>の声質を提供する。
接続していない画像、動画、音声番号を記載しないでください。途中で<Picture 1>の意味を変えないでください。
現在のワークフローは複数の画像、動画、音声を扱えますが、最大容量は推奨開始構成ではありません。画像1枚と動作ソース1つから始め、不足情報を追加する場合だけ参照を増やします。
6. 短い検証クリップを実行する
最初の生成には次を含めます:
- キャラクター1人
- 主要動作1つ
- ショット1つ
- 固定または控えめなカメラ
- 単純な環境
- 不要な台詞や音楽なし
複雑さを増す前にキャラクターを確認します。顔、身体比率、スタイル、見える身体被覆、ポーズ方向が開始から主要動作まで一貫している必要があります。
基本クリップが機能したら、2つ目のビュー、参照動画、カメラ動作、音声、別の人物など、変数を1つずつ追加します。これで結果を変えたソースを特定できます。
参照間でNSFWキャラクターの一貫性を保つ方法
同じキャラクターの異なるビューを使う
有用な参照セットには、明瞭な顔、ミディアムショット、広い身体ビューを含められます。異なる情報を提供しながら同じ同一性を維持する必要があります。
顔、髪、肌、身体比率、特徴的なスタイルは一致させます。1枚が顔構造や画風を変えると、モデルは競合する2つの定義を受け取ります。
参照は対象ショットの視覚状態でも一致させます。衣装や身体被覆が大きく異なる場合は、対象が維持する状態を決め、競合するソースを除きます。
併用
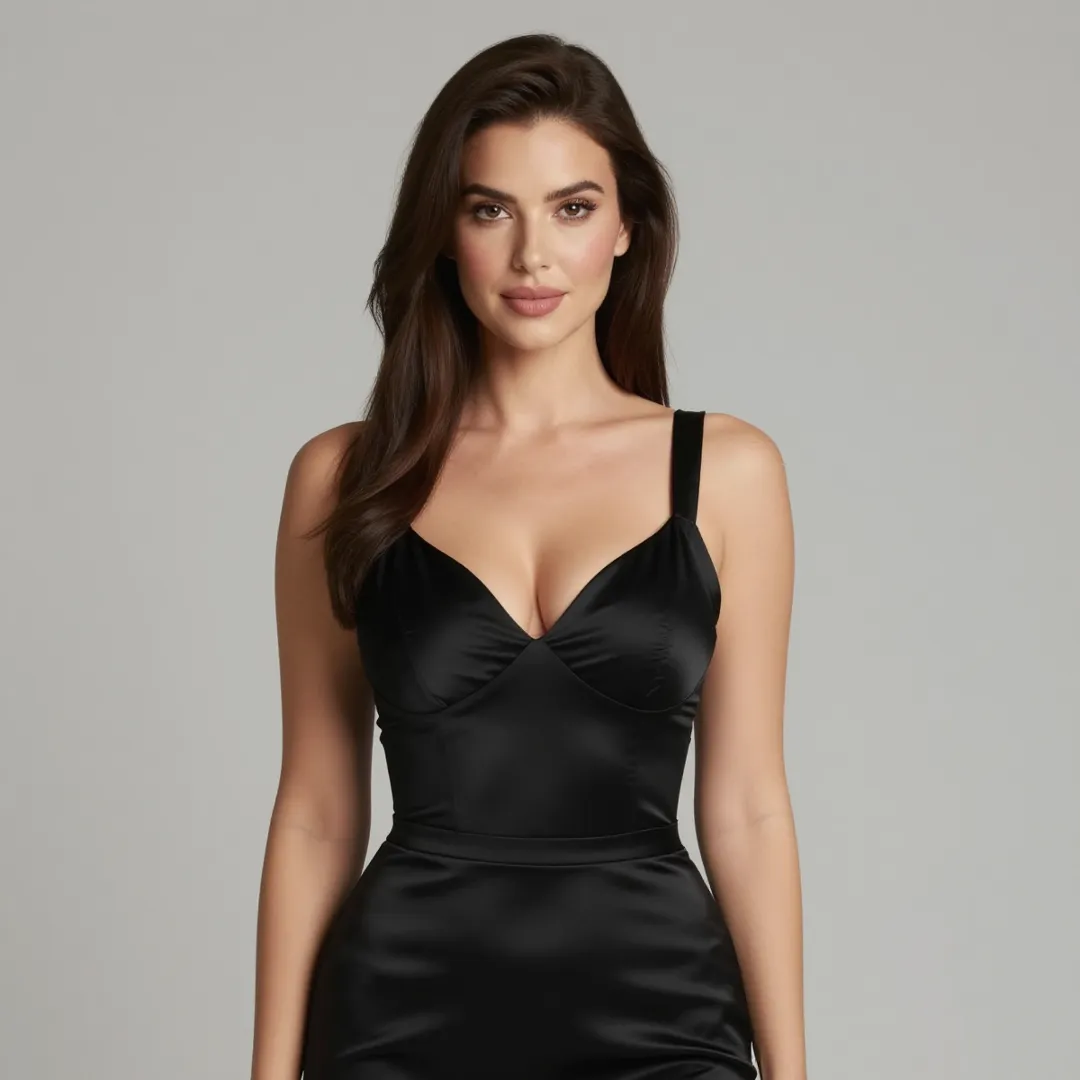
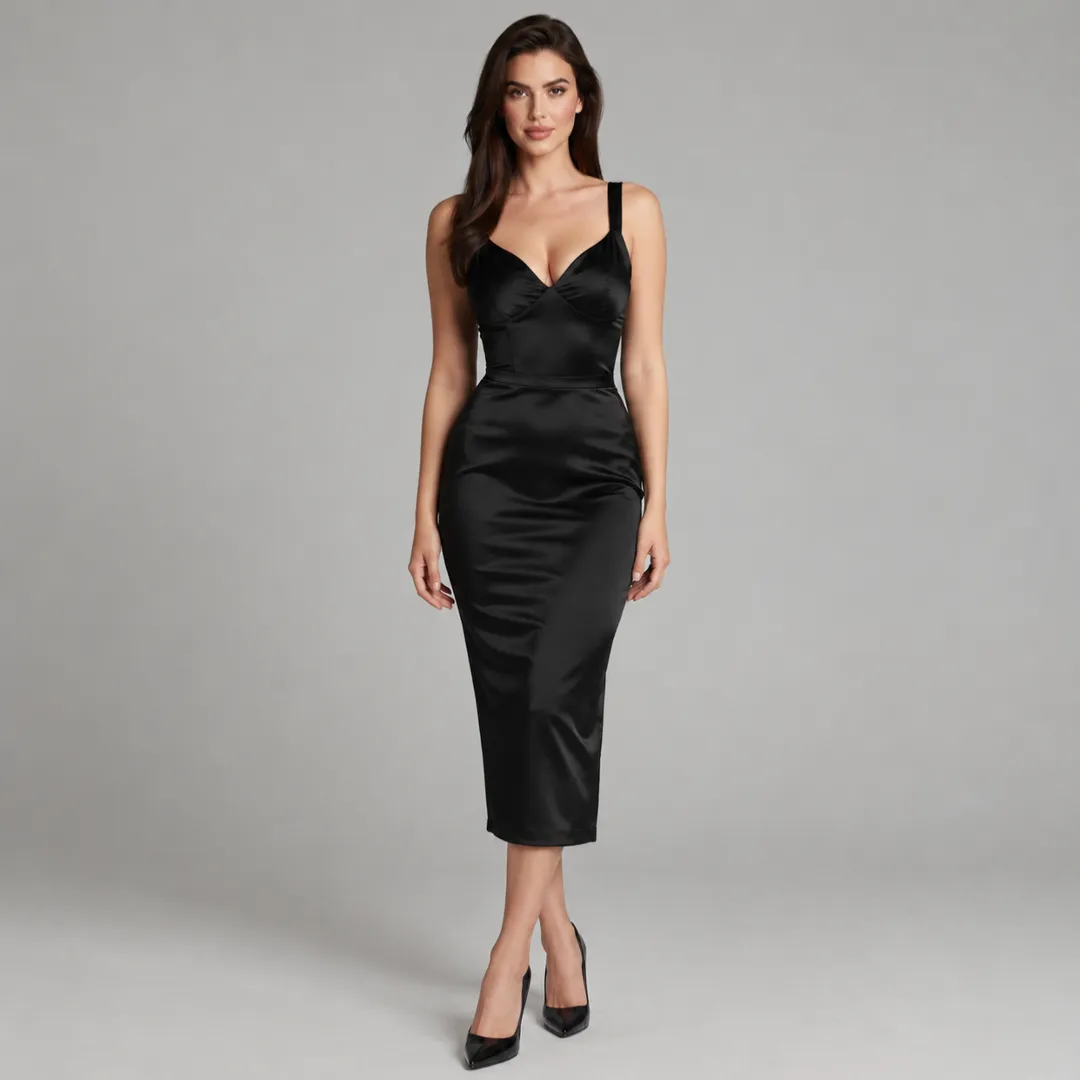
混在不可
参照画像を動きに合わせる
動作に関わる部位がすでに見える同一性画像を選びます。動きが腰をまたぐ、座位を変える、手を胴に置く場合、その領域が明瞭で構造的に見える必要があります。
見えない解剖を露出させる、重なった手足を分ける、複数の接触点を保つ必要があるほど難しくなります。視覚的に単純なポーズが、劇的な画像より良い参照になる理由です。
モーションソースにキャラクターを置換させない
モーション参照動画の演者は、顔、身体、衣装、環境が同一性画像より視覚的に強い場合があります。モデルが意図以上にそのソースを残す可能性があります。
動きを説明する前に対象を定義し、参照演者を維持しないと明記します。それでも同一性が弱まるなら、元の顔が目立たない、またはポーズがより互換なクリップを選びます。
接近した相互作用は別にテストする
2人の相互作用は別の同一性、手足、一時的な遮蔽、複数の動く接触点を追加します。新キャラクターの最初のテストには使わないでください。
まず主要キャラクター単独を検証し、次に短く制御したショットで2人目を追加します。可能なら身体を視覚的に分離し、複数の手、顔、カメラ動作を同時に変えないでください。
長いシーケンスでは、導入、ポーズ変更、接近相互作用、最終ショットを別クリップにします。1回の生成に全移行を強いるのではなく、承認済み参照を再利用します。
NSFWキャラクターと動きを一貫させるRef2VAプロンプト
Ref2VAプロンプトは、対象動画とソースとの関係を説明する必要があります。外見の形容詞を繰り返しても、明確な参照割り当ての代わりにはなりません。
MiniMaxの完全参照プロンプト形式は、Ref2VAリクエストを6つのセクションに整理します:
subject_definitions:
<Subject 1>は、顔の同一性、長い黒髪、身体比率、黒いサテンのスタイルを<Picture 1>から得る架空の成人女性である。
<Picture 2>は同じキャラクターの広いビューを提供し、身体比率と開始姿勢を確認する。
<Video 1>はゆっくりした座位調整と控えめなカメラ前進を提供する。
<Audio 1>は<Subject 1>(S1)の声質参照である。

summary:
[参照生成 + 音声参照]
対象は<Subject 1>を撮るプライベートスタジオの1ショット動画。同一性とスタイルは<Picture 1>と<Picture 2>、動きとカメラタイミングは<Video 1>、声質は<Audio 1>を参照する。

retention_analysis:
<Subject 1>: fully_preserved - 顔、髪、身体比率、サテンのスタイル、全体の視覚状態を維持する。
<Video 1>: reference - 元の演者や環境を残さず、ポーズ変更とカメラリズムを転写する。
<Audio 1>: reference - 録音をコピーせず声質を導く。

detailed_description:
静かなプライベートスタジオで写実的な撮影照明を使う。
[Shot 1] <Subject 1>は3/4方向のミディアムショットで座る。<Video 1>の制御した動きに従い、ゆっくり重心を移し、片方の肩をカメラへ向け、新しいポーズに落ち着く。カメラは角度を変えず、控えめに一度前進する。<Audio 1>の穏やかな声質を参照した<Subject 1>(S1)は、<d>[日本語] 少しここにいて。</d>と言う。

overall_soundscape:
静かな室内音、わずかな布の動き、参照した話し方。

non_diegetic_music:
背景音楽なし。
このプロンプトは同一性を一度定義し、残りを動き、カメラ、音に使います。各フィールドで顔と身体の説明を繰り返さないでください。
連続する1ショットが必要なら、無関係なカメラ指示を複数追加しません。別のポーズ、構図、接触が必要な第2動作は、別クリップにする価値があります。
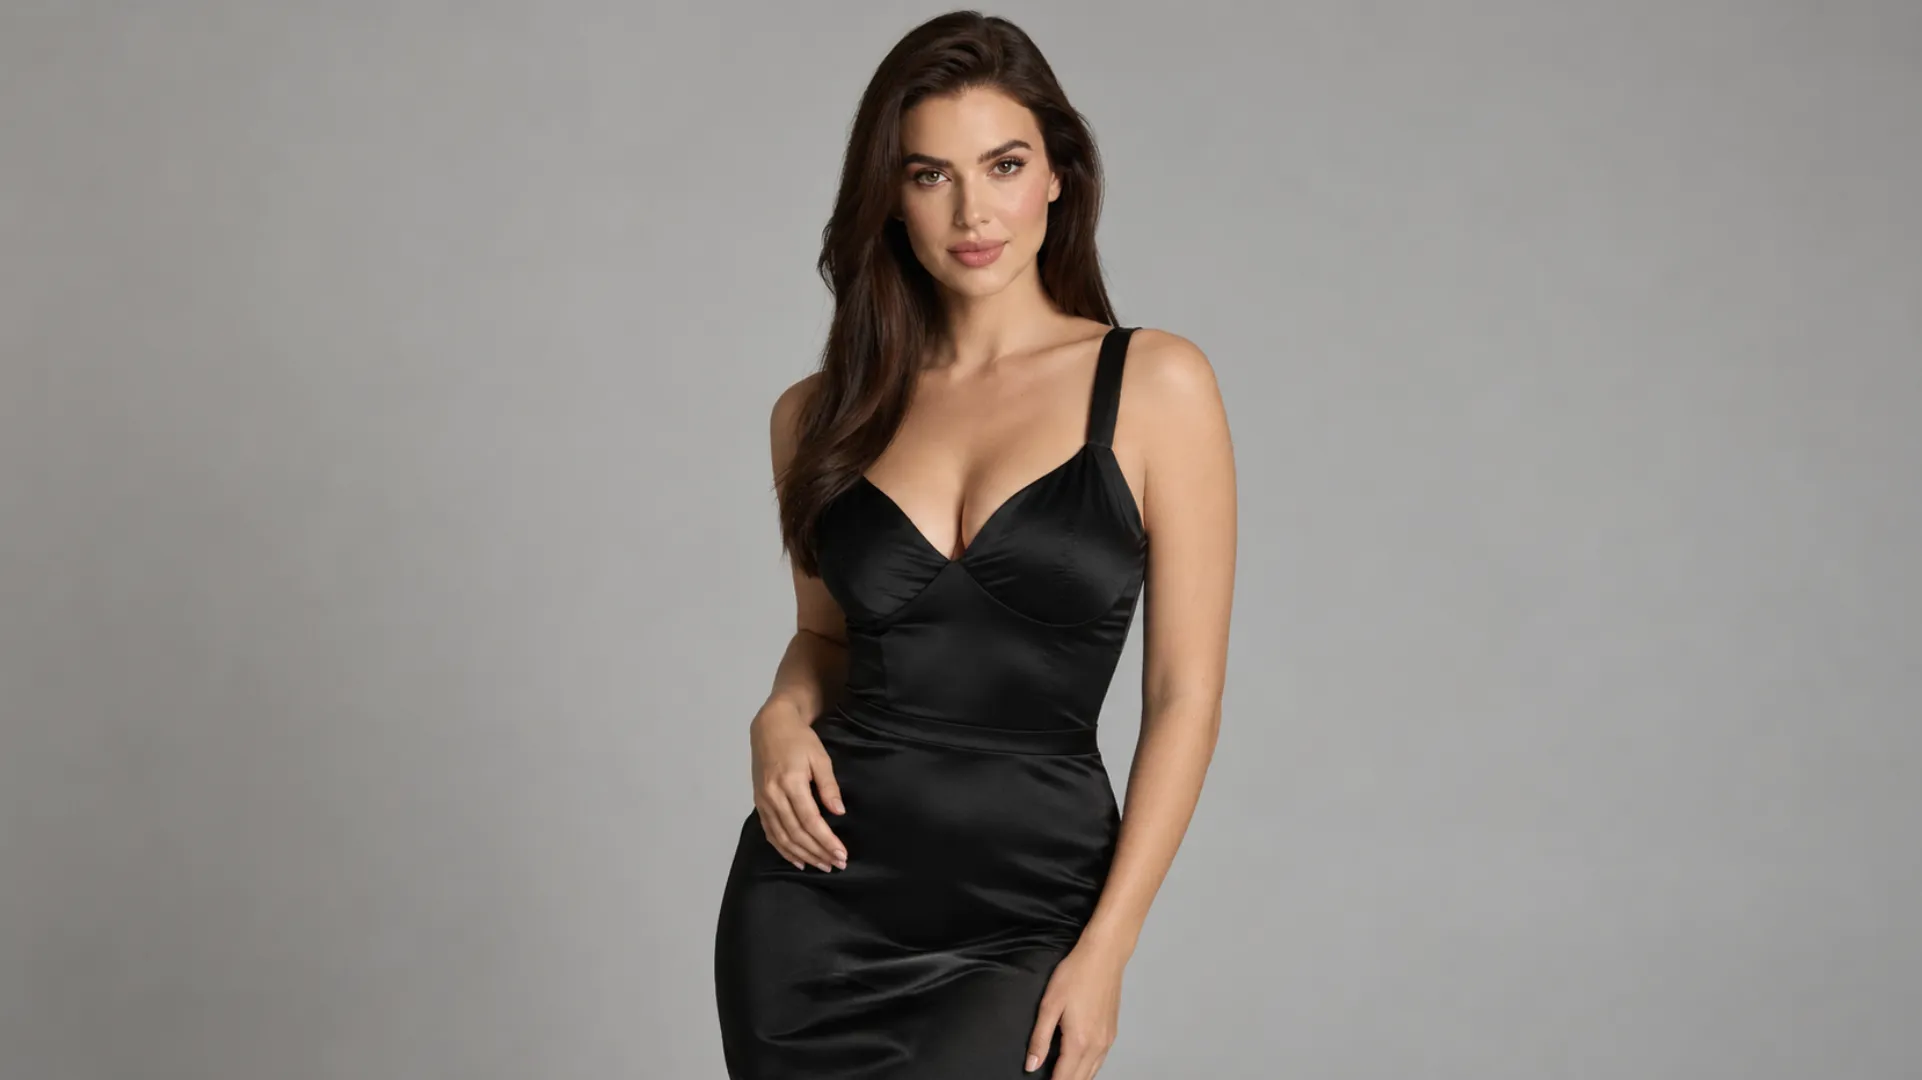 NSFWシーン
NSFW AI動画向けの実用的なMiniMax H3 Ref2VAワークフロー
再利用可能な制作フローでは、前の層が安定してから複雑さを増やします。
ステップ1:キャラクター画像を承認する
同一性、身体方向、スタイル、視覚状態を決める画像を選びます。適切な画像がなければ、AINSFW.AIリアルガール生成、アニメガール生成、タグから画像生成で作ります。
魅力的という理由だけで進めず、最初の予定動作に十分な視覚情報があることを確認します。
ステップ2:同一性テストを作る
目の動き、呼吸、わずかな表情変化、小さな頭の回転を含む短いクローズまたはミディアムショットを生成し、大きな身体動作の前に識別可能か確認します。
ステップ3:制御した身体動作を加える
広めの同一性参照を使い、肩、胴、腰、座位の調整を1つだけ指定します。最初の身体動作テストではカメラを固定します。
小さな動きでキャラクターが変わるなら、複雑なモーションソースは通常その変化をさらに目立たせます。
ステップ4:モーション参照を導入する
開始ポーズが互換な短い動画を接続し、同一性ではなく動きとカメラタイミングを提供すると記述します。
前の同一性テストと比較します。対象が参照演者に似始めたら、ソース動画を単純化するか、被写体割り当てを明確にします。
ステップ5:カメラと音声を加える
身体動作が安定したら、カメラ挙動を1つ導入します。視覚参照が協調してから声、環境音、音楽を追加します。
動作ソース、カメラ、音声、プロンプト構造、生成設定を同じテストで変えないでください。原因が理解できる成功結果の方が価値があります。
ステップ6:独立した動画ショットを作る
制作上の役割ごとに別クリップを作ります:
- 同一性ショット:微妙な表情を含むクローズまたはミディアム構図。
- ポーズショット:制御した身体または姿勢の移行。
- ワイドモーションショット:広い参照で支える大きな動き。
- 相互作用ショット:追加の接触や別の被写体を含む、個別テスト済みクリップ。
前の生成結果だけを次のソースにせず、各クリップを承認済み参照セットから生成します。累積する同一性ドリフトを減らせます。
ローカルモデル、参照割り当て、ComfyUI保守が必要以上に複雑なら、承認画像をAINSFW.AI画像から動画ジェネレーターで使います。1枚の画像から始め、複数の動画・音声参照が不要な場合の簡単な経路です。
MiniMax H3 Ref2VA FAQ
MiniMax H3 Ref2VAとMiniMax H3 R2Vは同じですか?
現在のComfyUI文書ではテンプレートがMiniMax H3 R2V、タスクとチェックポイントがref2vaの場合があります。ここではどちらもFL2VAキーフレーム経路ではなく、参照から音声動画のワークフローを指します。
Ref2VAは複数のキャラクター画像を使えますか?
はい。現在の公式ワークフローは複数の画像参照をサポートします。互換性のある角度、身体情報、スタイル、環境詳細を補うために使います。同一性や比率が異なる画像は一貫性を下げることがあります。
読み込んだ動画をRef2VA入力へ接続できないのはなぜですか?
ローダーがVIDEOオブジェクトを出力し、入力が抽出フレームを要求している場合があります。必要に応じてComfyUIのネイティブGet Video Componentsノードでフレーム列、音声、メタデータを分離します。
Ref2VAは画像、動画、音声を組み合わせられますか?
はい。Ref2VAは混合マルチモーダル参照向けです。少なくとも画像か動画を1つ接続し、各ソースに一貫したラベルを付け、同一性、動き、カメラ、再利用音声、声質のどれを提供するか示します。
Ref2VAは一貫したNSFWキャラクターを保証しますか?
いいえ。Ref2VAは参照情報を増やしますが、一貫性はソースの整合、見える身体情報、ポーズ互換性、プロンプトの明確さ、動きの複雑さ、遮蔽に依存します。短いテストと制御した追加が必要です。