
Краткий ответ: как использовать MiniMax H3 Ref2VA для NSFW-видео?
Используйте специальный checkpoint MiniMax H3 Ref2VA в совместимом процессе ComfyUI R2V. Начните с одного одобренного изображения, подключите его как <Picture 1> и задайте повторяющийся субъект в промпте. Добавляйте референсное видео только для конкретного движения, схемы камеры, монтажа или продолжения. Аудио подключайте отдельно, если оно должно направлять голос, музыку, ритм или повторно используемый саундтрек.
Для NSFW-видео безопаснее сначала проверить идентичность персонажа, затем простое движение тела, потом камеру и лишь после этого тесное взаимодействие. Каждое дополнение проверяйте коротким клипом до добавления следующего референса.
Ref2VA улучшает контроль по референсам, но не гарантирует идеальную идентичность или анатомию. Результат всё ещё зависит от совместимых поз, ясных границ тела, согласованных изображений и однозначного промпта.
Если стабильного исходного персонажа нет, создайте и утвердите его в Генераторе изображений AINSFW.AI до сборки Ref2VA-процесса.
 Пример NSFW-персонажа
MiniMax H3 Ref2VA или FL2VA: какой процесс выбрать?
MiniMax H3 использует отдельные checkpoints для разных задач. FL2VA обрабатывает текст-в-аудиовидео и генерацию по первому или последнему кадру. Ref2VA обрабатывает референс-в-аудиовидео с изображениями, видео, аудио или смешанными источниками.
| Ваша цель | Рекомендуемый маршрут |
|---|---|
| Создать сцену из текста | T2VA с FL2VA |
| Анимировать точный начальный кадр | I2VA с FL2VA |
| Связать начальный и конечный кадры | FL2VA |
| Сохранить персонажа, не делая изображение нулевым кадром | Ref2VA |
| Передать движение или работу камеры | Ref2VA |
| Референс голоса, саундтрека, ритма или звуковой фактуры | Ref2VA |
| Изменить или продолжить существующий аудиовизуальный источник | Ref2VA |
Разница в роли ресурса. Изображение, подключённое как первый кадр, задаёт реальную начальную композицию. То же изображение в Ref2VA может определять лицо, тело, стиль, окружение или позу, не становясь первым кадром.
Это важно для NSFW-персонажей. Одно начальное изображение может закрепить клип, но дать мало информации при повороте тела, расширении плана или временном перекрытии другим субъектом. Ref2VA может использовать дополнительные виды идентичности, если они показывают того же персонажа.
Процессы также используют разные веса диффузии. Загрузка весов FL2VA в Ref2VA не создаёт мультимодальное поведение лишь потому, что соседние узлы выглядят совместимыми.
Как настроить MiniMax H3 Ref2VA в ComfyUI
1. Загрузите модель и процесс Ref2VA
Обновите ComfyUI перед открытием процесса. В старой установке могут отсутствовать новые штатные узлы и шаблоны MiniMax H3.
Откройте библиотеку шаблонов и найдите MiniMax H3 R2V либо используйте актуальный официальный JSON. В имени шаблона может быть «R2V», а в checkpoint и задаче — ref2va. Здесь это один маршрут референс-в-видео.
Стандартная структура ComfyUI размещает модель диффузии Ref2VA в models/diffusion_models, текстовый энкодер в models/text_encoders, видео- и аудио-VAE в models/vae, а необязательную turbo LoRA в models/loras.
Убедитесь, что процесс загружает Ref2VA, а не FL2VA. Используйте файлы из текущего шаблона: BF16, INT8, NVFP4 и другие варианты могут требовать иных загрузчиков или настроек памяти.
Для первого теста используйте обычный путь генерации. Необязательная четырёхшаговая turbo LoRA ускоряет итерации, но официальная документация предупреждает о возможном снижении качества движения и аудио.
2. Добавьте один одобренный референс персонажа
Начните с одного изображения, а не с целой галереи. Лицо должно быть чётким, нужная часть тела — видимой, а границы позы — читаемыми.
Для говорящего крупного плана может хватить чёткого лица и верхней части тела. Для смены сидячей позы или более широкого чувственного движения используйте изображение с плечами, торсом, талией, руками и начальной позой. Не требуйте от тесно обрезанного портрета отсутствующей информации о теле.
Подключите изображение к первому входу референса картинки. В промпте оно станет <Picture 1>. Дополнительные изображения нумеруются в порядке подключения.
Самое сильное изображение идентичности должно задавать:
- Форму лица и узнаваемые черты
- Внешний вид волос и кожи
- Пропорции тела, видимые в целевом кадре
- Стиль или состояние одежды, которое нужно сохранить
- Начальную позу и направление тела
Не подключайте сразу версии с разными лицами, причёсками, пропорциями или стилями. Дополнительные референсы полезны только при совместимой информации.
3. Подключите видео-референс движения
Видео может задавать движение тела, работу камеры, ритм монтажа, изменяемую сцену или точку продолжения. Промпт должен явно описывать нужную связь.
Некоторые загрузчики ComfyUI возвращают объект VIDEO, а вход MiniMax H3 ожидает последовательность извлечённых изображений. Если порты не соединяются, используйте штатный узел Get Video Components, чтобы получить кадры, аудио, частоту и другие компоненты. Подключите кадры ко входу референсного видео.
Если нужен исходный саундтрек, подключите извлечённое аудио отдельно. Загрузка видео не делает его звук автоматически доступным референсом <Audio N>.
Для переноса движения выбирайте источник с похожей начальной позой. Сидящего персонажа легче согласовать с сидячим движением, чем тесный портрет с мгновенным поворотом стоящей фигуры в полный рост.
Движение должно оставаться читаемым. Сильные перекрытия тел, руки за торсом, волосы поверх суставов или пересекающиеся исполнители заставляют модель восстанавливать информацию, которой нет ни в одном источнике.
Укажите, что видео передаёт движение, а не идентичность:
<Subject 1> получает идентичность и внешность из <Picture 1>.
<Video 1> даёт только медленную смену сидячей позы и ритм камеры.
Исполнитель из <Video 1> не сохраняется в целевом видео. Референс персонажа
 Референс движения
 Сгенерированный результат
4. Добавляйте аудио только с ясной ролью
Ref2VA может использовать аудио из референсного видео или отдельного файла. По текущим официальным правилам аудио не может быть единственным референсом; оно должно сопровождать изображение или видео.
Определите роль источника:
- Референс тембра голоса
- Референс подачи или эмоции
- Повторно используемый диалог или текст песни
- Повторно используемая фоновая музыка
- Референс ритма или музыкального стиля
- Референс окружающего звука
Референс голоса не равен копированию сигнала. Если персонаж должен произнести новый текст похожим голосом, определите источник как референс тембра и напишите новый диалог в промпте.
Метки аудио нумеруются отдельно от видео. <Video 1> и <Audio 1> не считаются частями одного файла, если промпт не объясняет их связь.
Используйте только свои или разрешённые референсы лица, видео и голоса. Ref2VA нельзя применять для выдачи себя за узнаваемого человека без согласия.
 Сцена аудиореференса
5. Сопоставляйте референсы последовательно
Используйте одну и ту же метку для каждого входа во всём промпте:
<Picture 1> определяет внешность <Subject 1>.
<Picture 2> даёт более широкий вид того же персонажа.
<Video 1> даёт движение тела и тайминг камеры.
<Audio 1> даёт тембр голоса <Subject 1>.
Не упоминайте неподключённые номера изображений, видео или аудио. Не меняйте затем смысл <Picture 1>.
Процесс поддерживает несколько изображений, видео и аудиоклипов, но максимальная ёмкость — не лучшая начальная конфигурация. Начните с одного изображения и одного движения. Добавляйте референс только ради недостающей информации.
6. Запустите короткий проверочный клип
Первая генерация должна содержать:
- Одного персонажа
- Одно основное действие
- Один план
- Неподвижную или сдержанную камеру
- Простое окружение
- Без лишнего диалога и музыки
Проверьте персонажа до усложнения. Лицо, пропорции, стиль, видимое покрытие тела и направление позы должны оставаться согласованными от начала до основного движения.
Когда базовый клип работает, добавляйте по одной переменной: второй вид, референсное видео, движение камеры, аудио или другого человека. Так можно определить источник изменения результата.
Как сохранить NSFW-персонажа между референсами
Используйте разные виды одного персонажа
Полезный набор может включать чёткое лицо, средний план и более широкий вид тела. Изображения должны давать разную информацию, сохраняя одну идентичность.
Лицо, волосы, кожа, пропорции и отличительные детали стиля должны совпадать. Изменение структуры лица или стиля даёт модели две конкурирующие версии персонажа.
Референсы должны совпадать и по визуальному состоянию цели. Если одежда или степень покрытия заметно различаются, выберите нужное состояние и удалите конфликтующий источник.
Использовать вместе
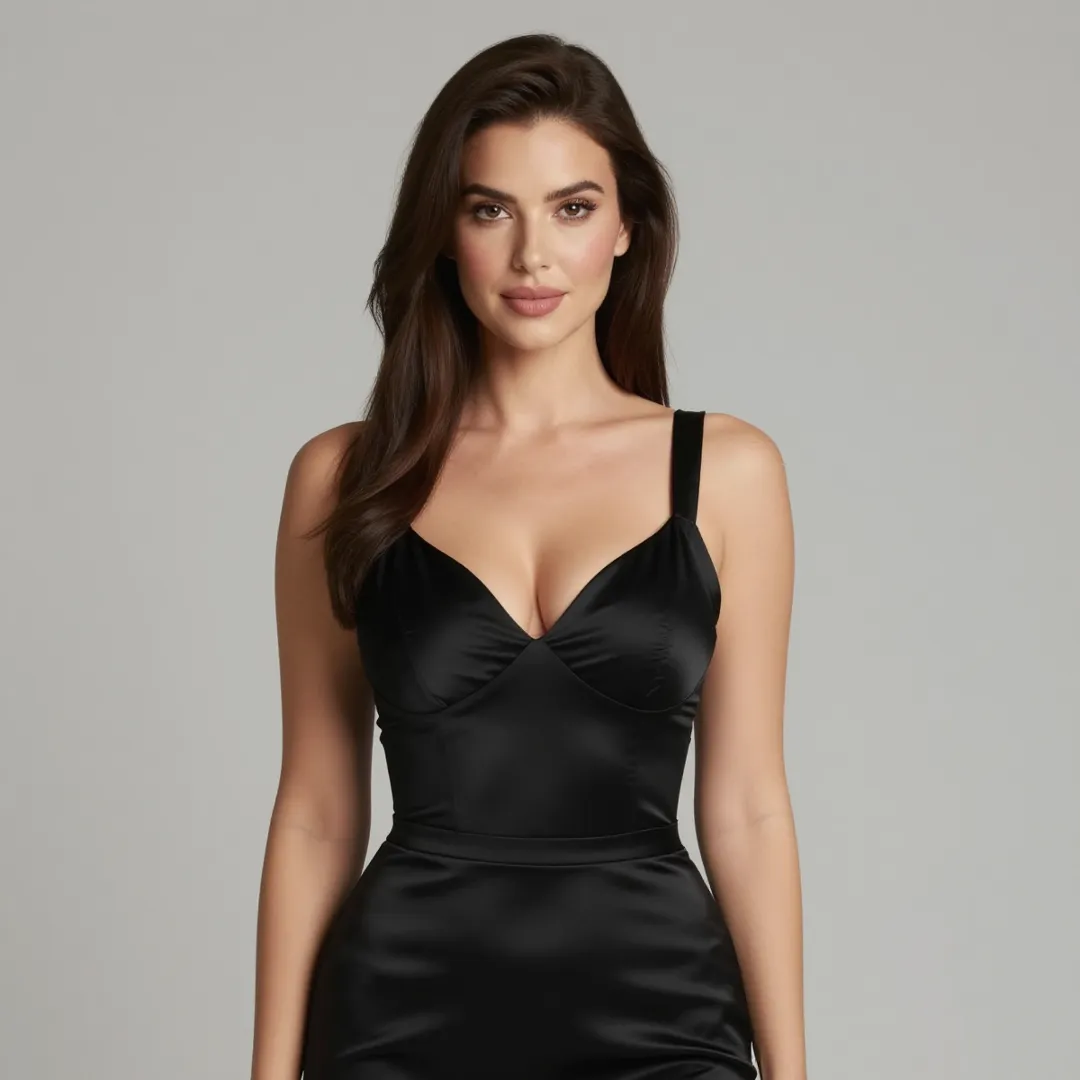
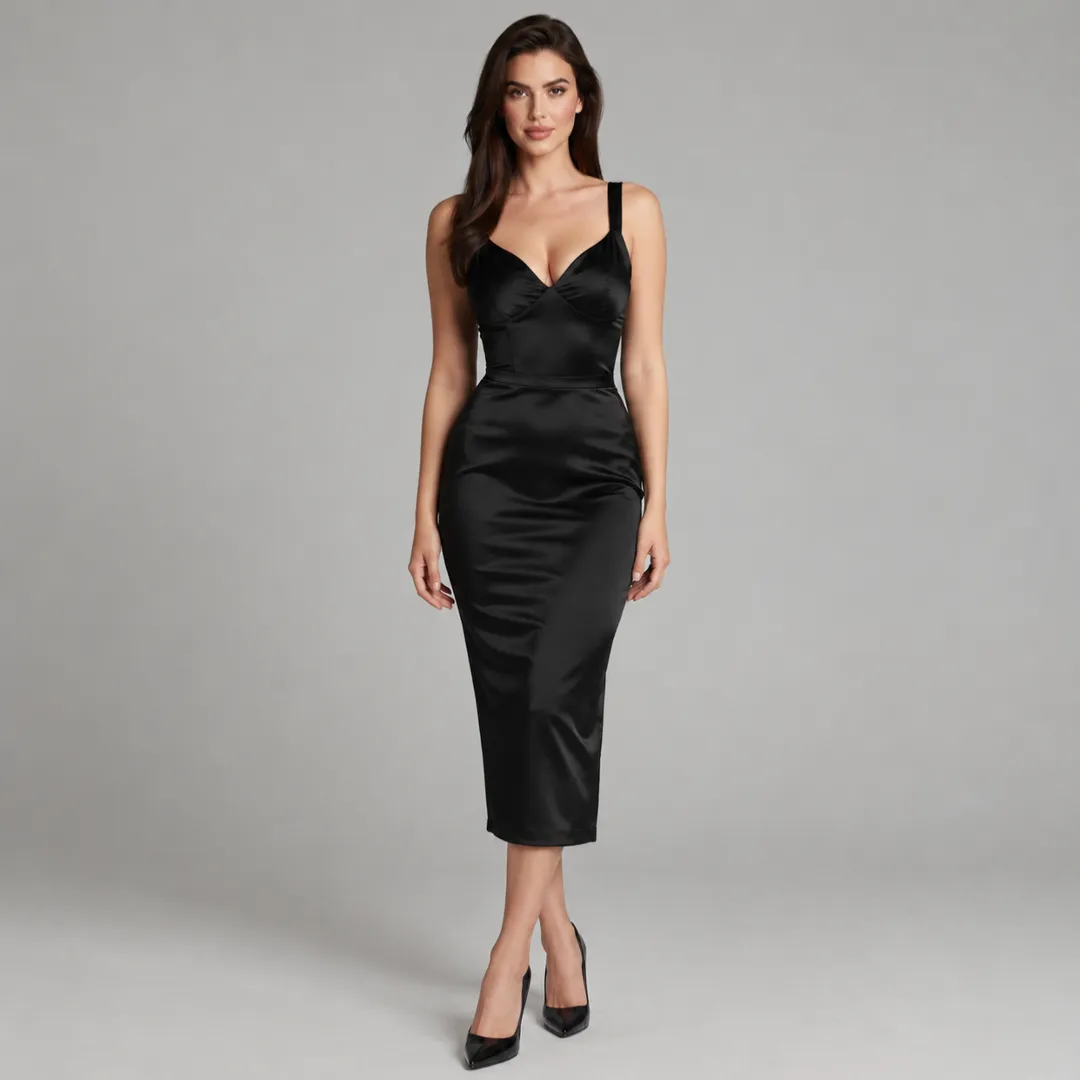
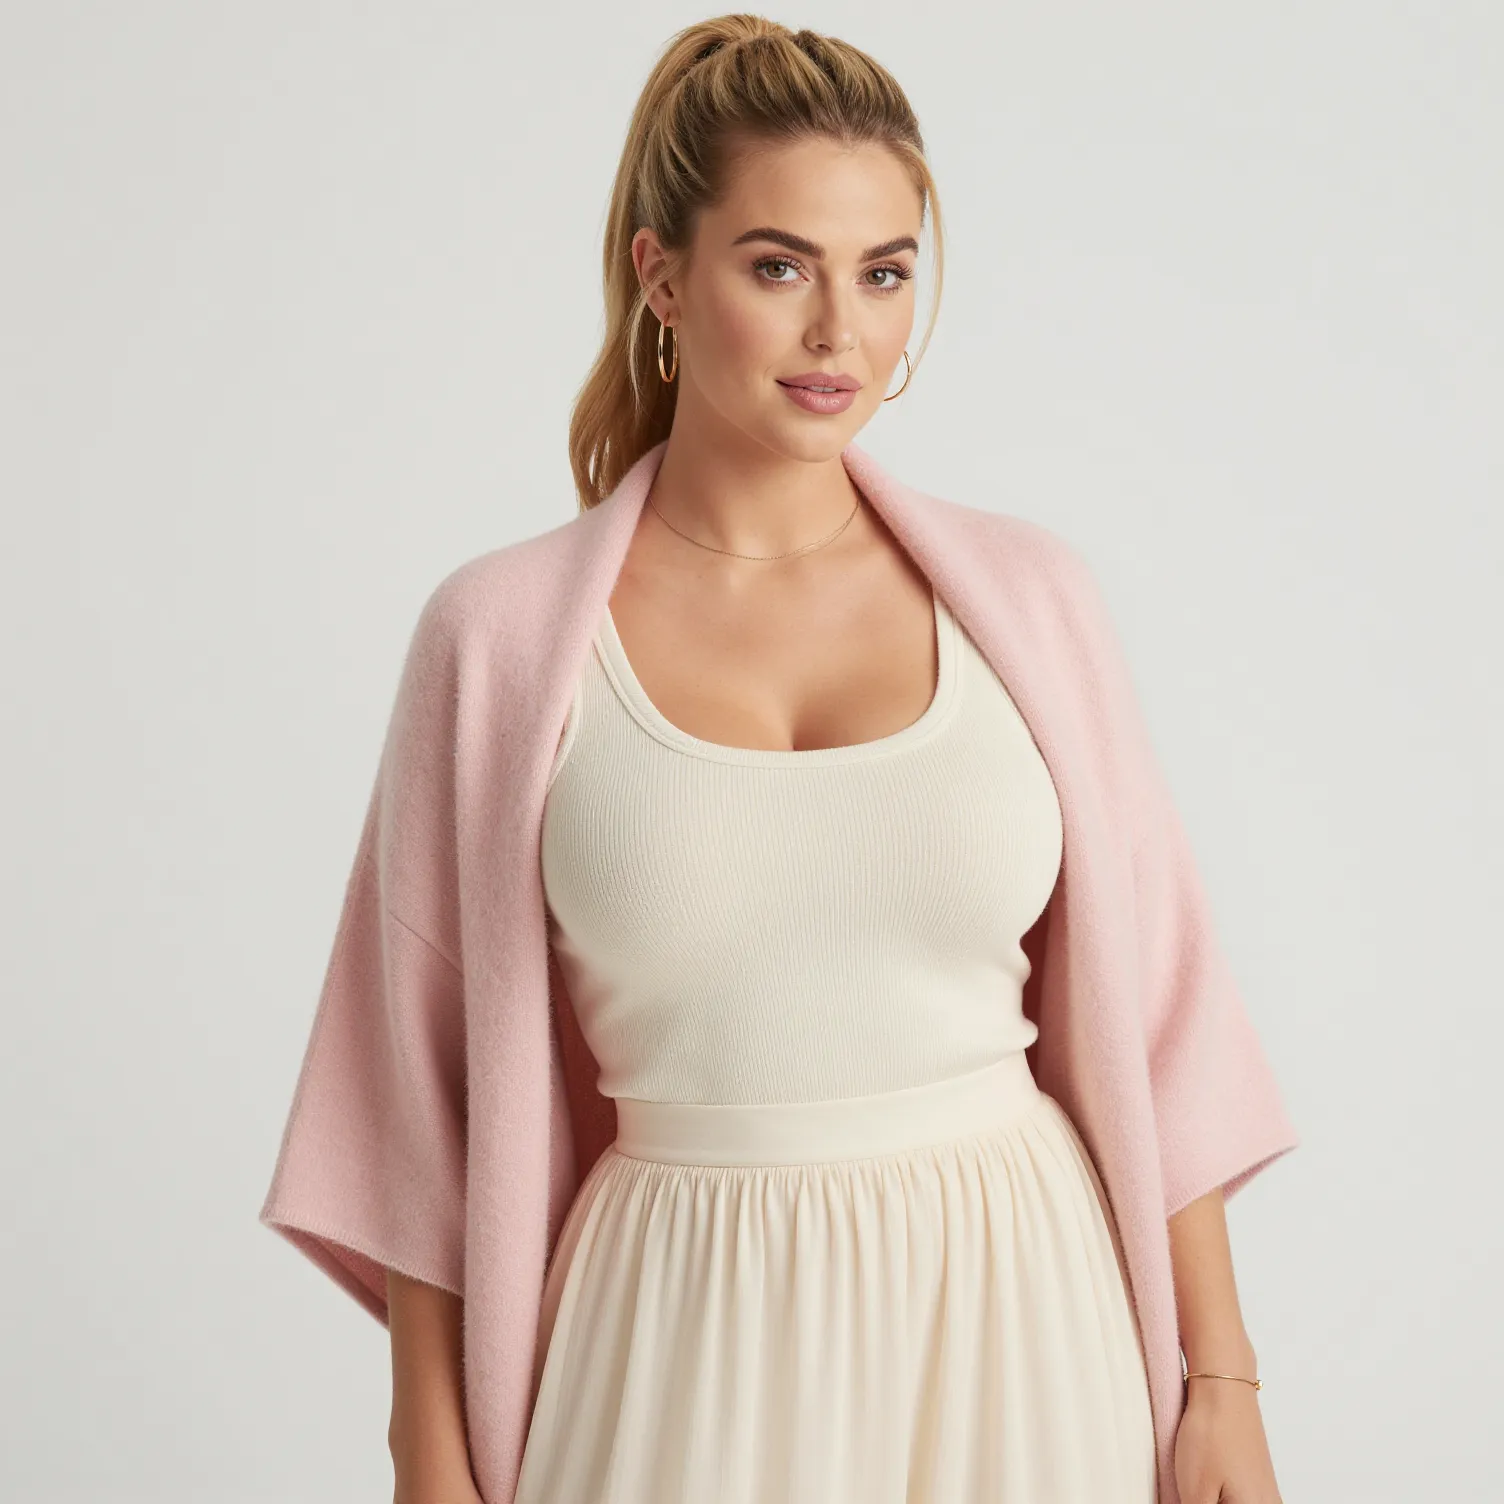
Не смешивать
Соотнесите референсное изображение с движением
Выбирайте изображение, где уже видна участвующая в действии часть тела. Если движение проходит через талию, меняет сидячую позу или кладёт руку на торс, эти области должны быть видимы и структурно ясны.
Сложность растёт, когда модели нужно раскрывать невидимую анатомию, разделять перекрывающиеся конечности или сохранять несколько точек контакта. Простая поза может быть лучшим референсом, чем драматичное изображение.
Не позволяйте источнику движения заменить персонажа
В видео движения лицо, тело, одежда или окружение исполнителя могут быть сильнее изображения идентичности. Модель способна сохранить больше исходного материала, чем задумано.
Опишите целевой субъект до движения и явно исключите сохранение исполнителя. Если идентичность слабеет, выберите клип с менее заметным исходным лицом или более совместимой позой.
Проверяйте тесное взаимодействие отдельно
Взаимодействие двух людей добавляет вторую идентичность, больше конечностей, временные перекрытия и движущиеся точки контакта. Не используйте его первым тестом нового персонажа.
Сначала проверьте главного персонажа отдельно, затем добавьте второго в коротком контролируемом плане. По возможности разделяйте тела визуально и не меняйте одновременно несколько рук, лиц и движений камеры.
Для длинной последовательности делайте отдельные клипы для вступления, смены позы, тесного взаимодействия и финала. Повторно используйте одобренные референсы вместо попытки выполнить все переходы одной генерацией.
Как составить Ref2VA-промпт для согласованных NSFW-персонажа и движения
Промпт Ref2VA должен объяснять целевое видео и его связь с источниками. Повторение описаний внешности не заменяет ясного назначения референсов.
Формат полного референсного промпта MiniMax делит запрос Ref2VA на шесть разделов:
subject_definitions:
<Subject 1> — вымышленная совершеннолетняя женщина, чья идентичность лица, длинные тёмные волосы, пропорции и чёрный атласный стиль взяты из <Picture 1>.
<Picture 2> даёт более широкий вид и подтверждает пропорции и начальную позу.
<Video 1> даёт медленную смену сидячей позы и сдержанное приближение камеры.
<Audio 1> — референс тембра для <Subject 1> (S1).

summary:
[генерация по референсу + аудиореференс]
Цель — одноплановое видео <Subject 1> в частной студии. Идентичность и стиль следуют <Picture 1> и <Picture 2>, движение и камера — <Video 1>, тембр — <Audio 1>.

retention_analysis:
<Subject 1>: fully_preserved - сохранить лицо, волосы, пропорции, атласный стиль и общее визуальное состояние.
<Video 1>: reference - передать смену позы и ритм камеры без исходного исполнителя и окружения.
<Audio 1>: reference - направлять тембр, не копируя запись.

detailed_description:
Видео использует реалистичный фотографический свет в тихой частной студии.
[Shot 1] <Subject 1> сидит в среднем плане на три четверти. Следуя контролируемому движению <Video 1>, она медленно переносит вес, поворачивает плечо к камере и принимает новую позу. Камера один раз сдержанно движется вперёд без смены угла. <Subject 1> (S1) спокойным голосом из <Audio 1> говорит: <d>[Русский] Побудь здесь немного.</d>

overall_soundscape:
Тихий фон комнаты, лёгкое движение ткани и референсная подача голоса.

non_diegetic_music:
Без фоновой музыки.
Этот промпт определяет идентичность один раз, а остальные детали посвящает движению, камере и звуку. Не повторяйте описание лица и тела в каждом поле.
Если нужен один непрерывный план, не добавляйте несвязанные указания камеры. Если второе действие требует новой позы, кадрирования или контакта, лучше сделать отдельный клип.
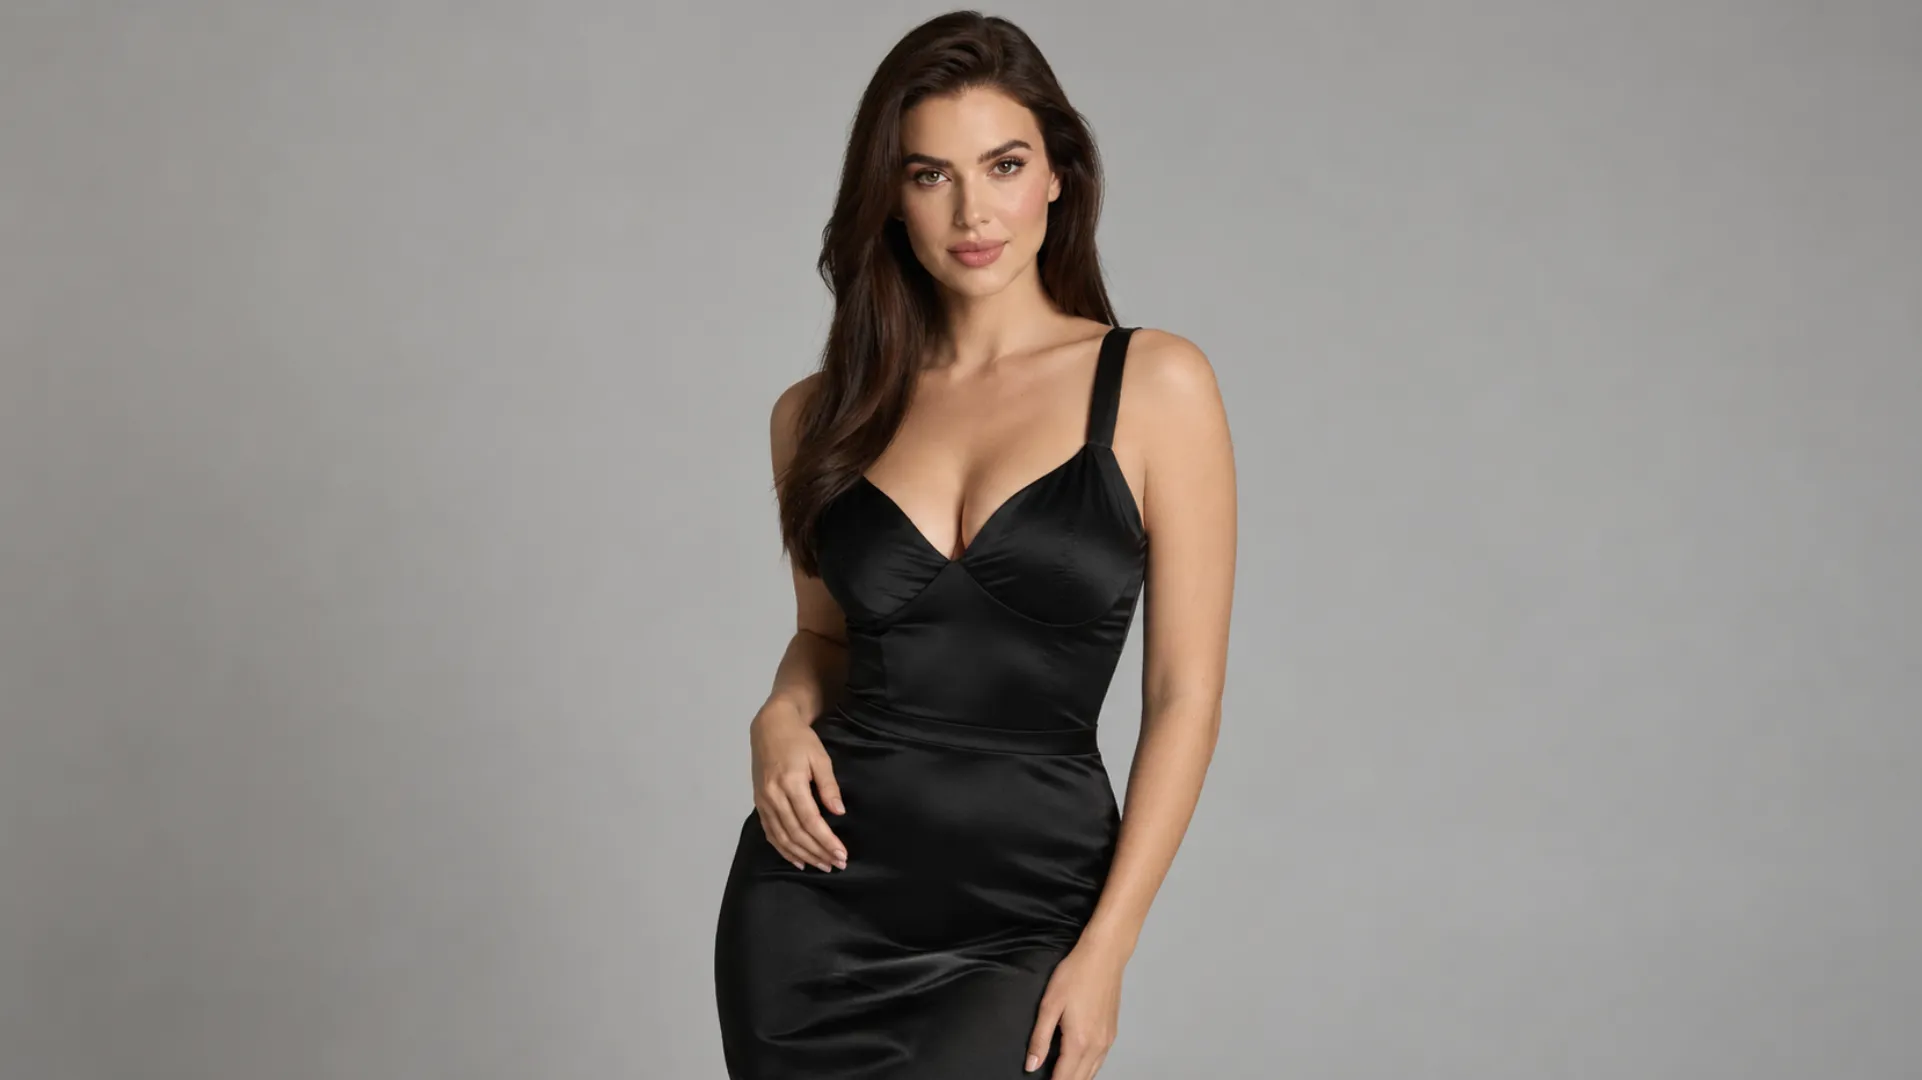 NSFW-сцена
Практический процесс MiniMax H3 Ref2VA для NSFW-видео с ИИ
Повторно используемый процесс должен усложняться только после стабилизации предыдущего слоя.
Шаг 1. Утвердите изображение персонажа
Выберите изображение, задающее идентичность, направление тела, стиль и визуальное состояние. Если подходящего нет, создайте его в Генераторе реалистичной девушки AINSFW.AI, Генераторе аниме-девушек или Картинках по тегам.
Не продолжайте только потому, что изображение привлекательное. Убедитесь, что данных достаточно для первого запланированного действия.
Шаг 2. Создайте тест идентичности
Сгенерируйте короткий крупный или средний план с движением глаз, дыханием, лёгкой сменой выражения или небольшим поворотом головы. Так видно, сохранится ли узнаваемость до большого движения.
Шаг 3. Добавьте контролируемое движение тела
Используйте более широкий референс и запросите одно изменение плеча, торса, талии или сидячей позы. В первом тесте держите камеру неподвижной.
Если персонаж меняется уже при малом движении, более сложный источник обычно делает изменение ещё заметнее.
Шаг 4. Введите референс движения
Подключите короткое видео с совместимой начальной позой. Укажите, что оно даёт движение и тайминг камеры, а не идентичность.
Сравните результат с предыдущим тестом. Если цель начинает походить на исполнителя, упростите видео или яснее назначьте субъект.
Шаг 5. Добавьте камеру и аудио
После стабилизации тела добавьте одно поведение камеры. Голос, атмосферу или музыку вводите после согласования визуальных референсов.
Не меняйте в одном тесте движение, камеру, аудио, структуру промпта и настройки. Успешный результат ценнее, когда понятна его причина.
Шаг 6. Создайте независимые видеопланы
Создавайте отдельные клипы для разных производственных ролей:
- План идентичности: крупное или среднее кадрирование с тонкой мимикой.
- План позы: один контролируемый переход тела или положения.
- Широкий план движения: более крупное движение при поддержке широкого референса.
- План взаимодействия: отдельно проверенный клип с дополнительным контактом или субъектом.
Генерируйте каждый клип из одобренного набора, не используя предыдущий результат как единственный источник следующего. Это уменьшает накопленный дрейф идентичности.
Если локальные модели, сопоставление референсов и обслуживание ComfyUI дают больше контроля, чем нужно, используйте утверждённое изображение в Генераторе преобразования изображений в видео AINSFW.AI. Это проще, когда задача начинается с одного изображения и не требует нескольких видео или аудио.
Частые вопросы о MiniMax H3 Ref2VA
MiniMax H3 Ref2VA и MiniMax H3 R2V — одно и то же?
В текущей документации ComfyUI шаблон может называться MiniMax H3 R2V, а задача и checkpoint — ref2va. Здесь оба названия обозначают процесс референс-в-аудиовидео, а не маршрут ключевых кадров FL2VA.
Может ли Ref2VA использовать несколько изображений персонажа?
Да. Официальный процесс поддерживает несколько изображений. Используйте их для совместимых углов, сведений о теле, стиле или окружении. Расхождения в идентичности или пропорциях могут снизить согласованность.
Почему загруженное видео не подключается ко входу Ref2VA?
Загрузчик может выдавать объект VIDEO, а вход ожидать извлечённые кадры. При необходимости используйте штатный узел Get Video Components, чтобы разделить кадры, аудио и метаданные.
Может ли Ref2VA сочетать изображения, видео и аудио?
Да. Ref2VA предназначен для смешанных мультимодальных референсов. Подключите хотя бы изображение или видео, последовательно пометьте источники и укажите, дают ли они идентичность, движение, камеру, повторное аудио или характеристику голоса.
Гарантирует ли Ref2VA согласованного NSFW-персонажа?
Нет. Ref2VA даёт больше референсной информации, но согласованность зависит от совпадения источников, видимых данных тела, совместимости поз, ясности промпта, сложности движения и перекрытий. Нужны короткие тесты и контролируемые добавления.