
Kort antwoord: hoe gebruik je MiniMax H3 Ref2VA voor NSFW-video?
Gebruik het speciale MiniMax H3 Ref2VA-checkpoint in een compatibele ComfyUI R2V-workflow. Begin met één goedgekeurde personageafbeelding, verbind die als <Picture 1> en definieer het terugkerende onderwerp in de prompt. Voeg alleen een referentievideo toe voor een specifieke beweging, camera, montagestructuur of voortzetting. Verbind audio afzonderlijk wanneer die stem, muziek, ritme of een herbruikbare soundtrack moet sturen.
Voor NSFW-video is de veiligste volgorde: eerst personage-identiteit, dan eenvoudige lichaamsbeweging, vervolgens camerabeweging en ten slotte nauwe interactie. Test elke toevoeging met een korte clip voor je een nieuwe referentie toevoegt.
Ref2VA verbetert referentiegestuurde controle, maar garandeert geen perfecte identiteit of anatomie. Resultaten hangen nog steeds af van passende poses, duidelijke lichaamsgrenzen, consistente afbeeldingen en een ondubbelzinnige prompt.
Heb je geen stabiel beginpersonage, maak en keur er dan één goed met de AINSFW.AI-afbeeldingsgenerator voordat je de Ref2VA-workflow bouwt.
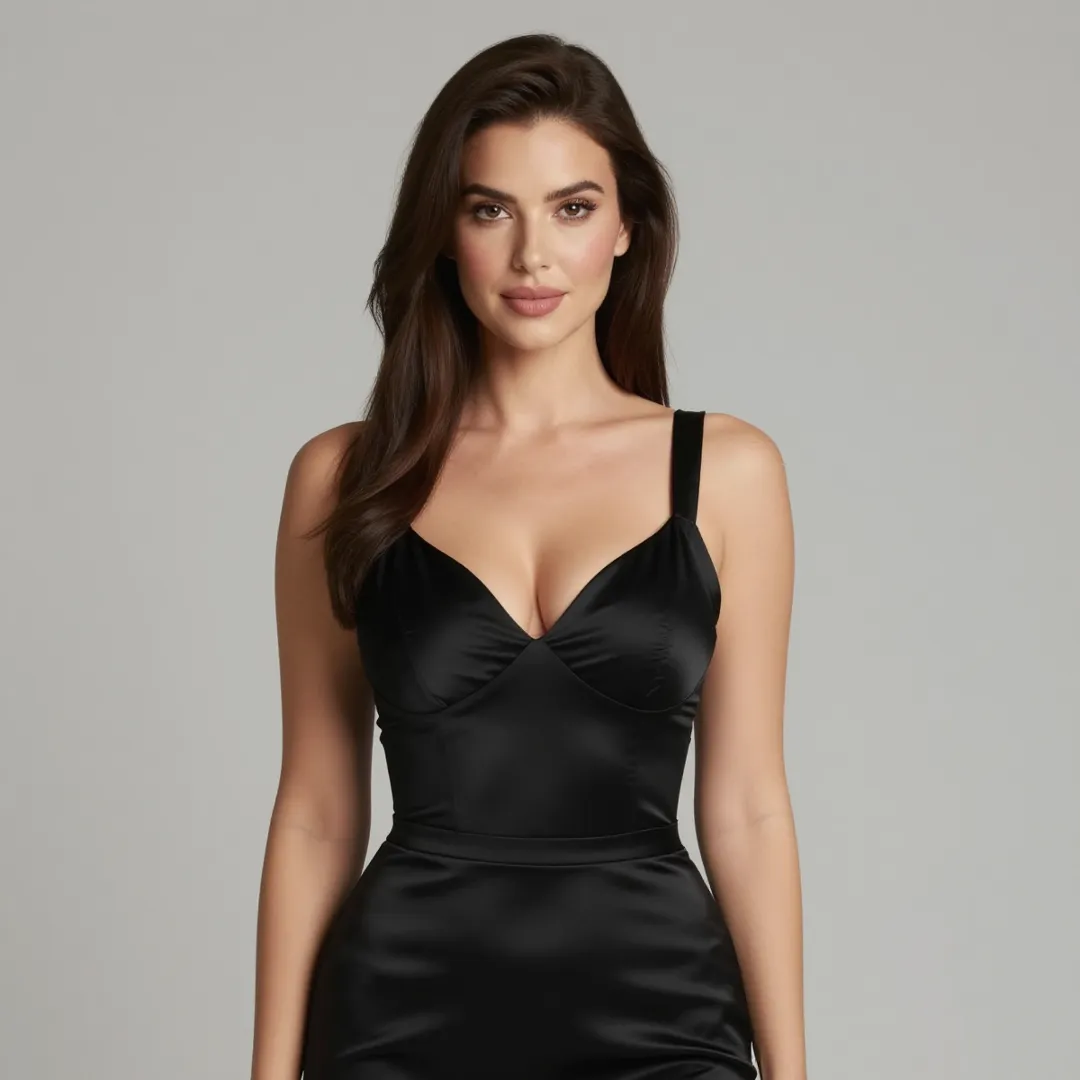
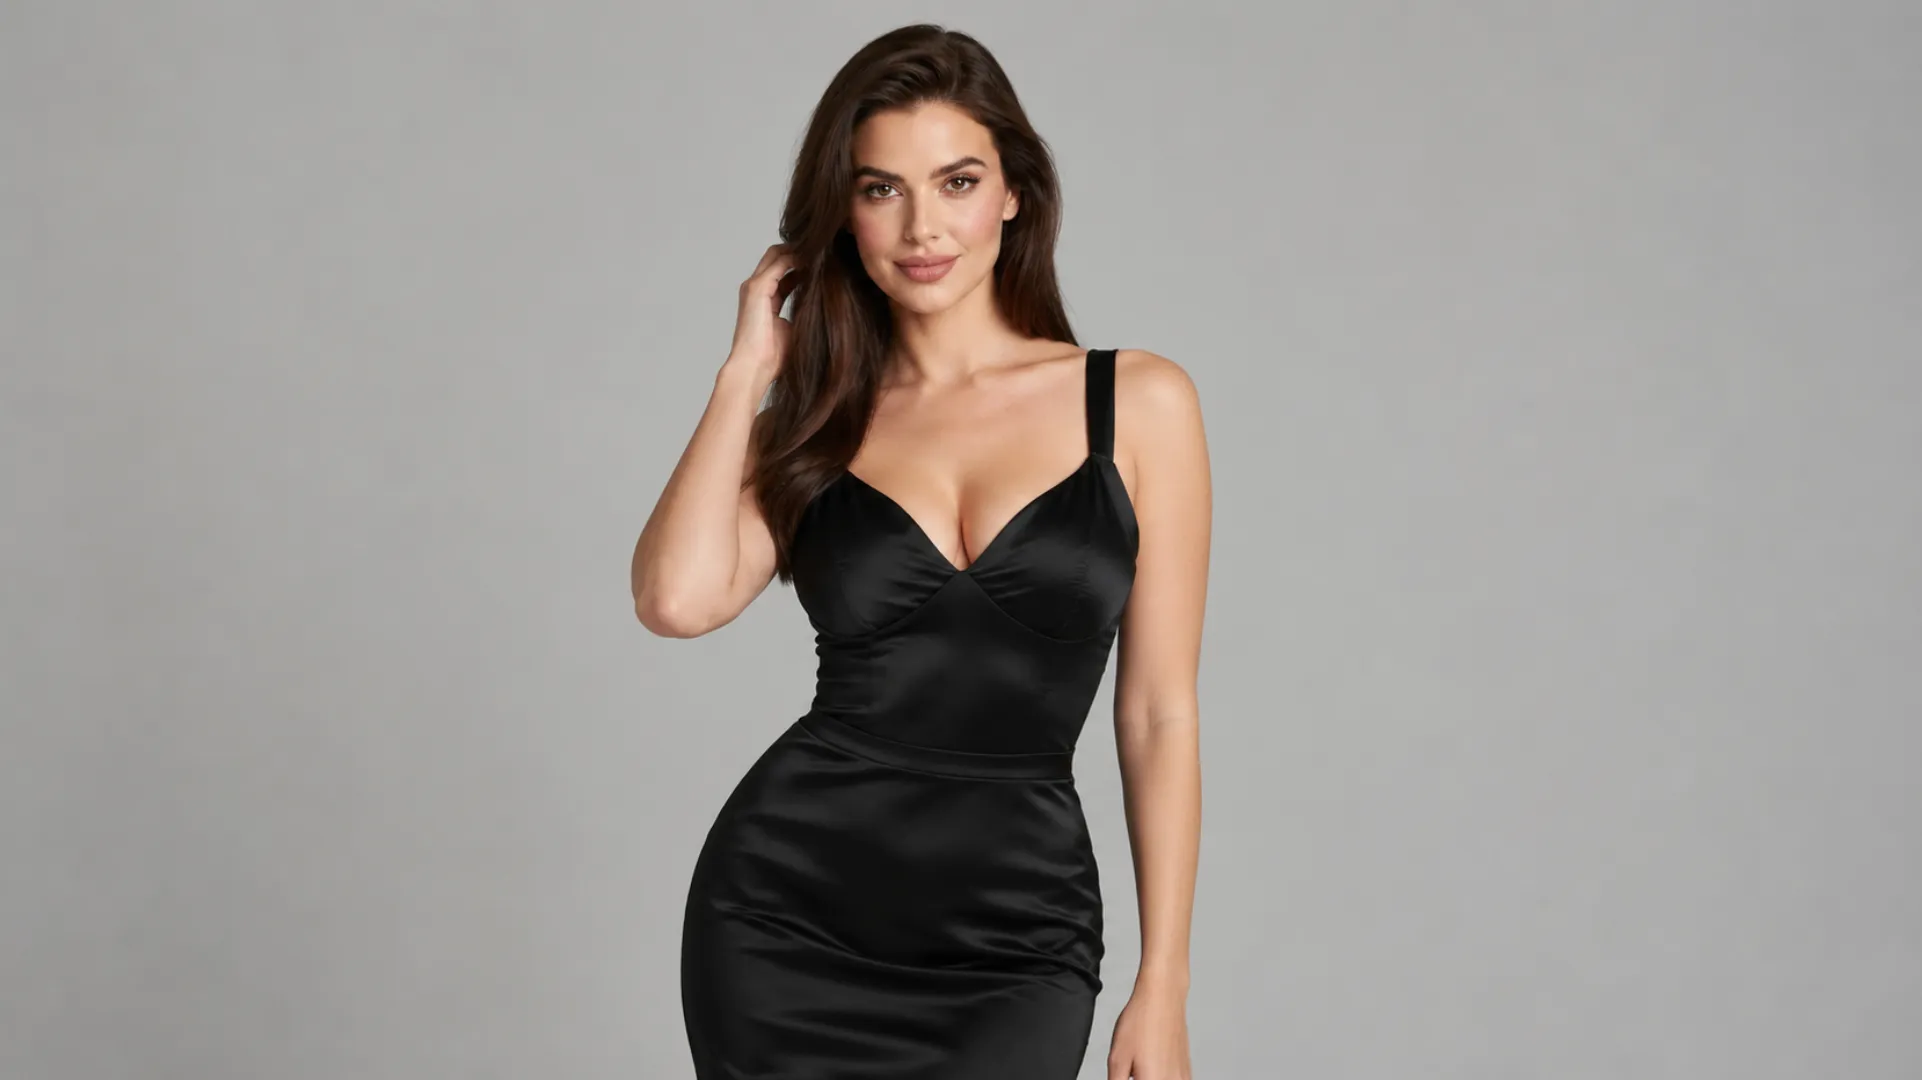 NSFW-personagevoorbeeld
MiniMax H3 Ref2VA versus FL2VA: welke workflow gebruik je?
MiniMax H3 gebruikt afzonderlijke checkpoints per taak. FL2VA verwerkt tekst-naar-audiovideo en generatie op basis van het eerste of laatste frame. Ref2VA verwerkt referentie-naar-audiovideo met afbeeldingen, video, audio of gemengde referenties.
| Je doel | Aanbevolen route |
|---|---|
| Een scène uit tekst genereren | T2VA met FL2VA |
| Eén exact openingsframe animeren | I2VA met FL2VA |
| Een openings- en eindframe verbinden | FL2VA |
| Een personage behouden zonder de afbeelding als frame nul te forceren | Ref2VA |
| Beweging of cameragedrag overdragen | Ref2VA |
| Stem, soundtrack, ritme of geluidsstructuur refereren | Ref2VA |
| Een bestaande audiovisuele bron bewerken of voortzetten | Ref2VA |
Het verschil is de rol van de bron. Een afbeelding als eerste frame bepaalt de echte openingscompositie. Dezelfde afbeelding in Ref2VA kan gezicht, lichaam, stijl, omgeving of pose bepalen zonder het eerste frame te worden.
Dit is belangrijk voor NSFW-personages. Eén openingsbeeld kan een clip verankeren, maar te weinig informatie geven wanneer het lichaam draait, het shot breder wordt of een ander onderwerp tijdelijk afdekt. Ref2VA kan extra identiteitsbeelden gebruiken zolang ze hetzelfde personage tonen.
De workflows gebruiken ook verschillende diffusiegewichten. FL2VA-gewichten in een Ref2VA-workflow laden creëert geen multimodale referentie alleen omdat omliggende nodes compatibel lijken.
MiniMax H3 Ref2VA instellen in ComfyUI
1. Laad het Ref2VA-model en de workflow
Werk ComfyUI bij voor je de workflow opent. Recente ingebouwde MiniMax H3-nodes en sjablonen kunnen in een oudere installatie ontbreken.
Open de sjabloonbibliotheek en zoek MiniMax H3 R2V, of gebruik de actuele officiële workflow-JSON. ComfyUI kan “R2V” in de sjabloonnaam gebruiken terwijl checkpoint en taak ref2va heten. Hier verwijzen beide naar dezelfde referentie-naar-videoroute.
De standaard ComfyUI-mappen plaatsen het Ref2VA-diffusiemodel in models/diffusion_models, de tekstencoder in models/text_encoders, video- en audio-VAE's in models/vae en de optionele turbo LoRA in models/loras.
Controleer dat de workflow het Ref2VA-model laadt en niet FL2VA. Gebruik de bestanden uit het huidige sjabloon, want BF16, INT8, NVFP4 en andere varianten kunnen andere loaders of geheugeninstellingen vereisen.
Gebruik voor de eerste test het normale generatiepad. De optionele turbo LoRA met vier stappen versnelt iteraties, maar officiële documentatie noemt mogelijk lagere bewegings- en audiokwaliteit.
2. Voeg één goedgekeurde personagereferentie toe
Begin met één afbeelding, niet een hele galerie. Het gezicht moet helder zijn, het bedoelde lichaamsdeel zichtbaar en de pose duidelijk begrensd.
Voor een pratende close-up kan een scherp gezicht en bovenlichaam volstaan. Gebruik voor een zittende poseverandering of ruimere sensuele beweging een beeld met schouders, romp, taille, handen en beginhouding. Vraag een strak uitgesneden portret niet om ontbrekende lichaamsinformatie.
Verbind de afbeelding met de eerste afbeeldingsreferentie. In de prompt wordt dit <Picture 1>. Extra afbeeldingen worden genummerd in verbindingsvolgorde.
De sterkste identiteitsafbeelding moet vastleggen:
- Gezichtsvorm en herkenbare kenmerken
- Uiterlijk van haar en huid
- Lichaamsverhoudingen zichtbaar in het doelshot
- Stijl of kledingtoestand die stabiel moet blijven
- Beginpose en lichaamsrichting
Verbind niet meteen versies met verschillende gezichten, kapsels, verhoudingen of stijlen. Meer referenties helpen alleen als ze compatibele informatie toevoegen.
3. Verbind een bewegingsreferentievideo
Een referentievideo kan lichaamsbeweging, cameragedrag, montageritme, een te wijzigen scène of een vervolgpositie leveren. De prompt moet de bedoelde relatie aangeven.
Sommige ComfyUI-videoloaders geven een VIDEO-object, terwijl MiniMax H3 een geëxtraheerde beeldreeks verwacht. Als de poorten niet verbinden, gebruik dan de ingebouwde node Get Video Components om frames, audio, framerate en onderdelen vrij te geven. Verbind de frames met de referentievideo-ingang.
Als de brontrack ook nodig is, verbind je de geëxtraheerde audio afzonderlijk. Ga er niet van uit dat een geladen video zijn audio automatisch als bruikbare <Audio N>-referentie toewijst.
Kies voor bewegingsoverdracht een bron met een beginhouding die op de doelpose lijkt. Een zittend personage en een zittende bewegingsbron zijn eenvoudiger te combineren dan een close-up en een onmiddellijke staande draai in volledig beeld.
De beweging moet leesbaar blijven. Sterke overlap, handen achter de romp, haar over gewrichten of kruisende performers kunnen het model informatie laten reconstrueren die geen bron duidelijk toont.
Geef aan dat de video beweging levert, niet identiteit:
<Subject 1> ontleent identiteit en uiterlijk aan <Picture 1>.
<Video 1> levert alleen de langzame aanpassing van de zithouding en het cameraritme.
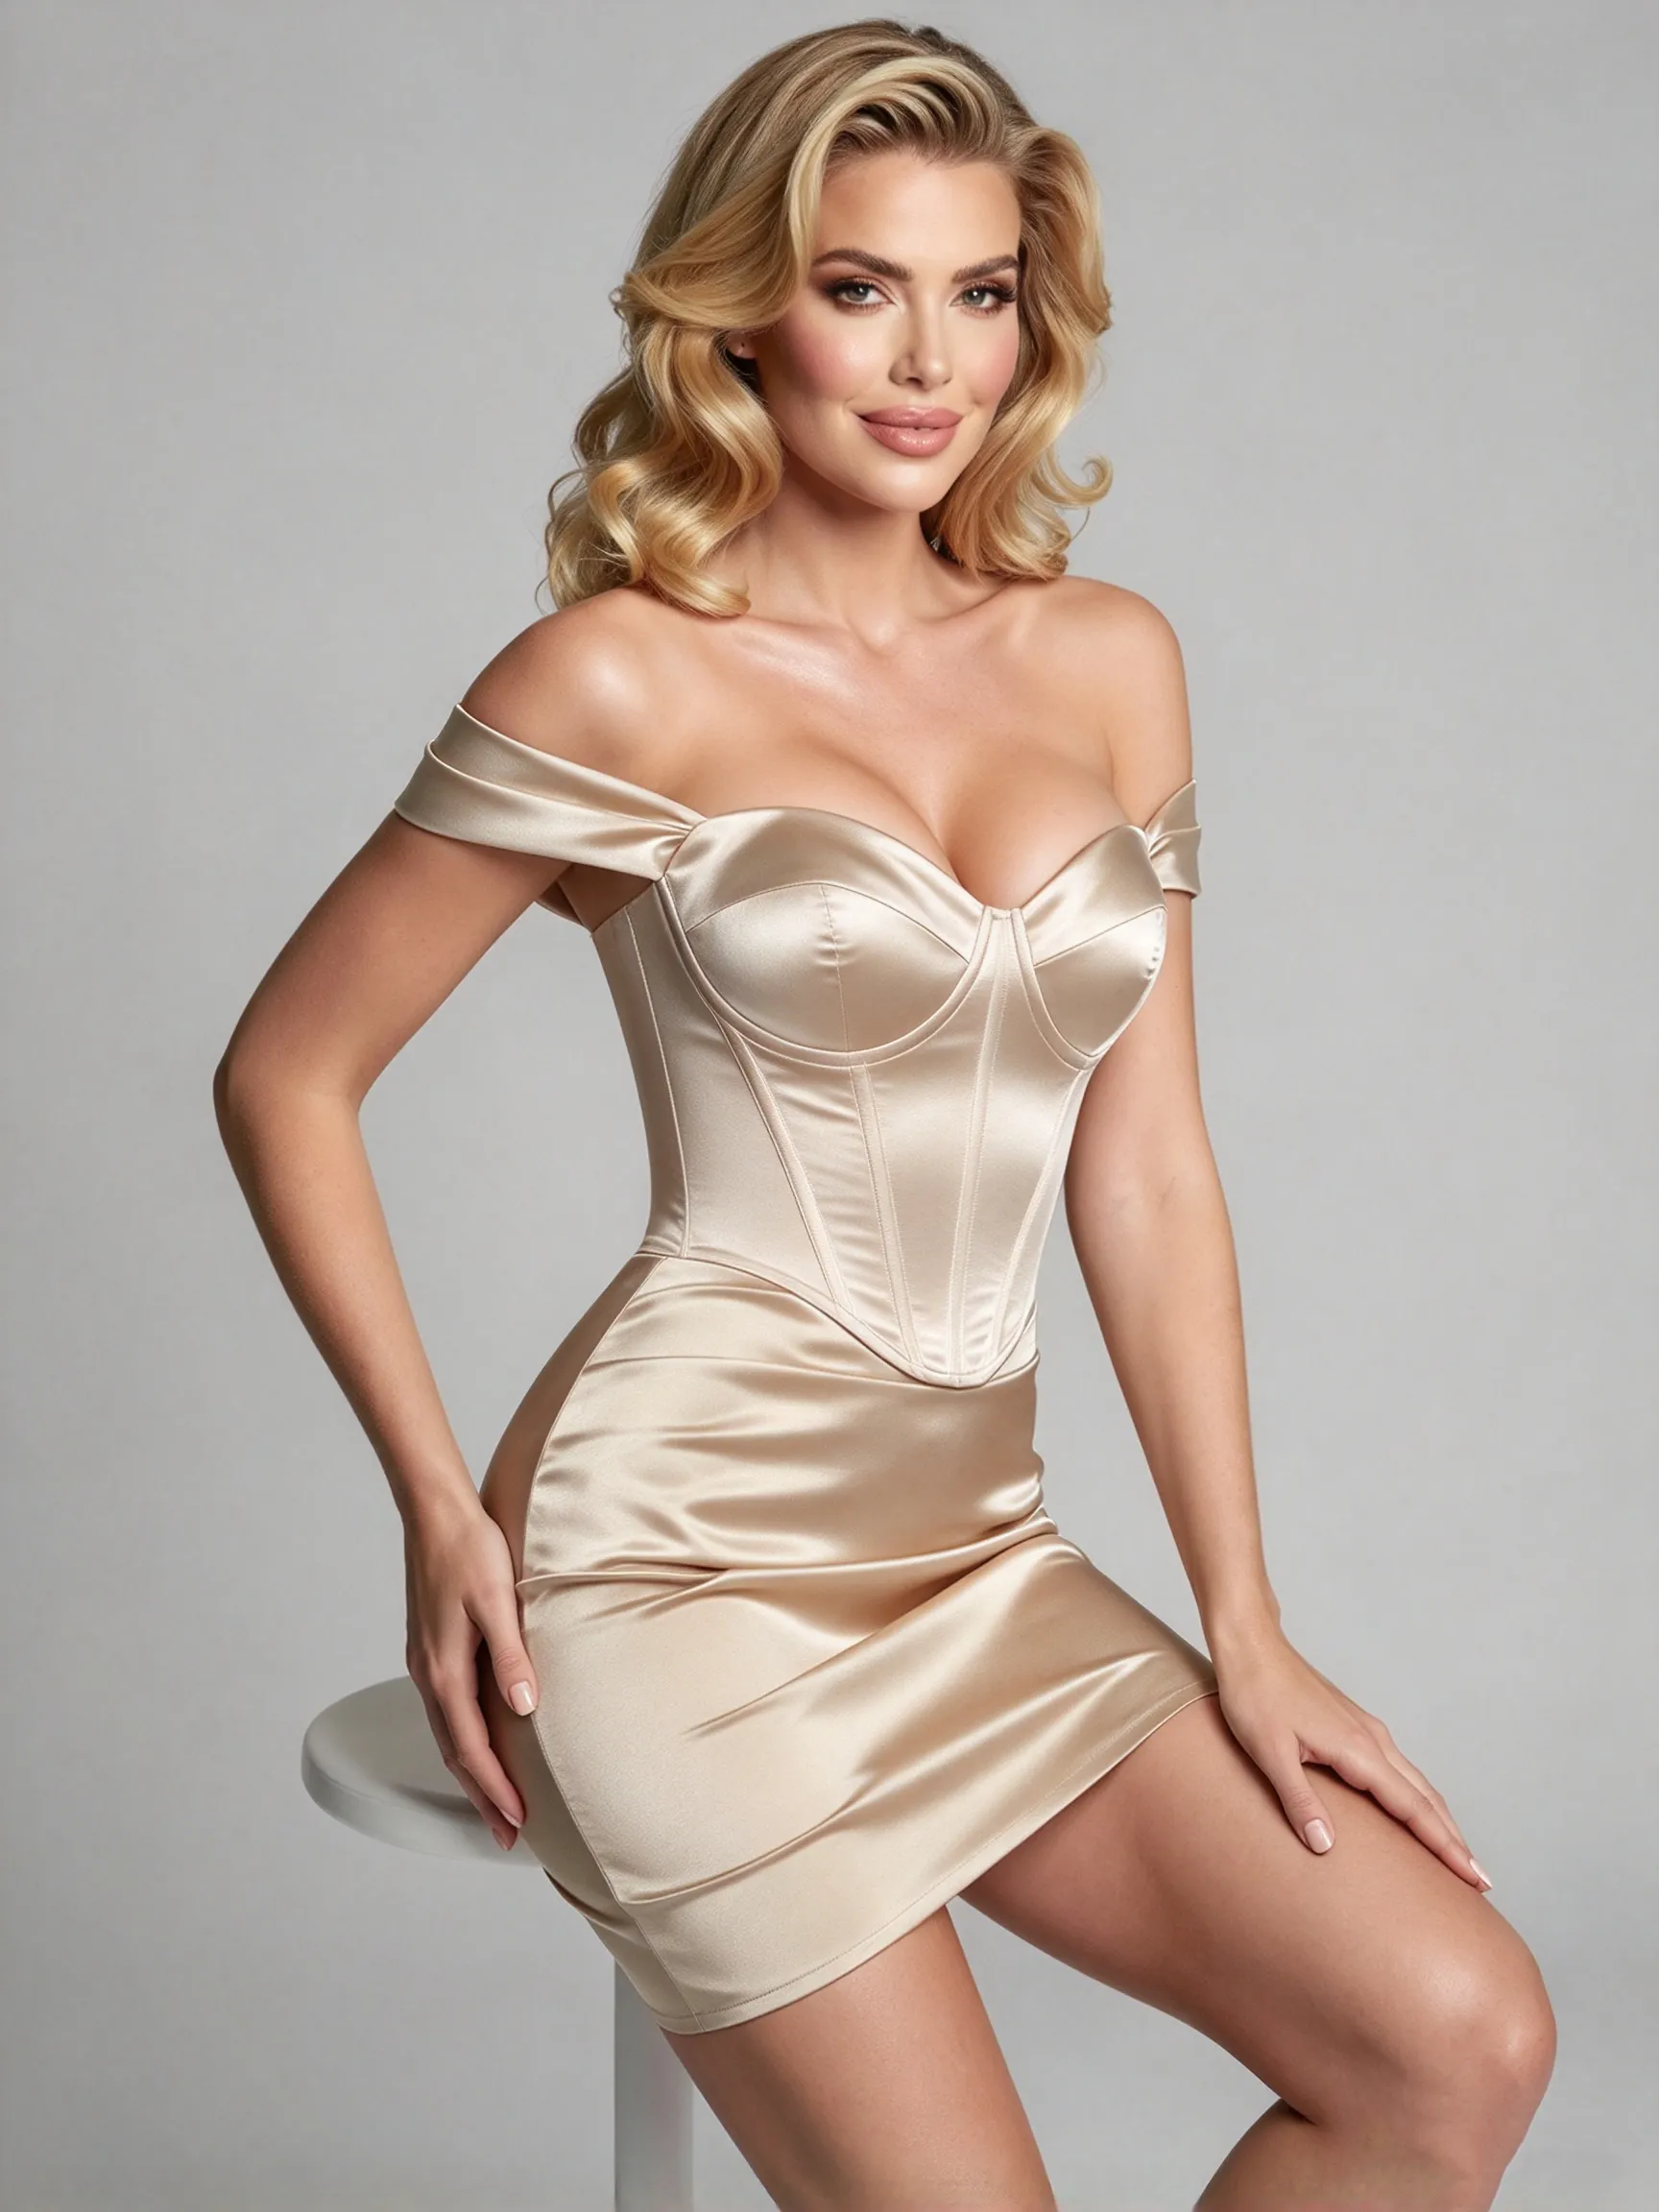
De performer uit <Video 1> blijft niet behouden in de doelvideo.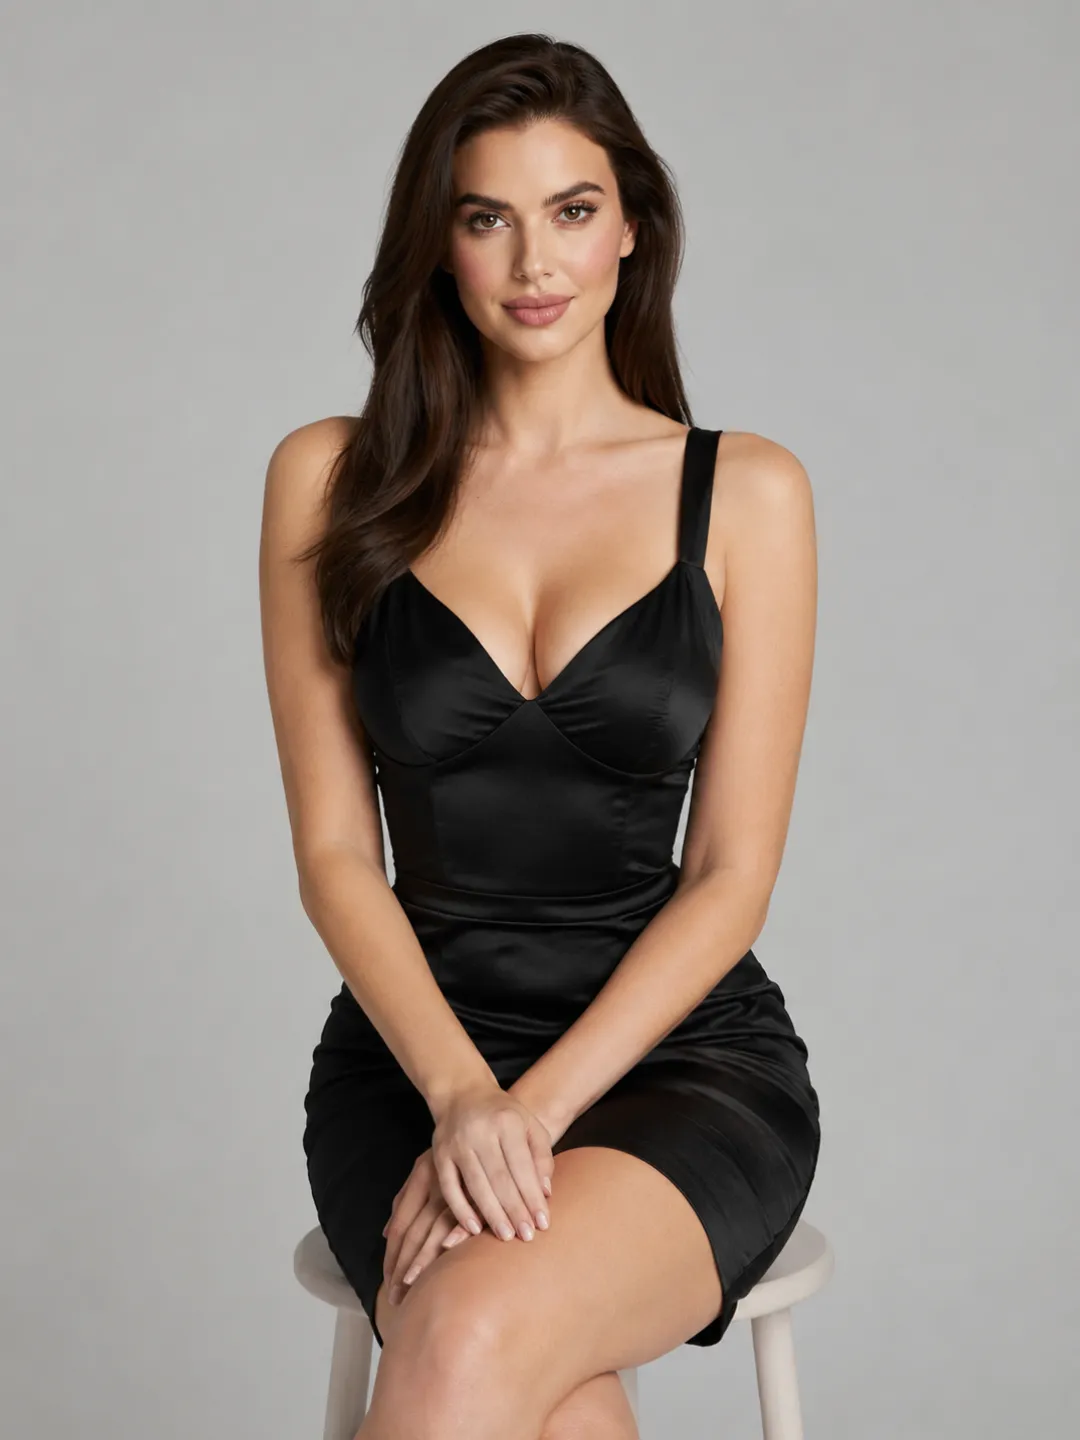 Personagereferentie
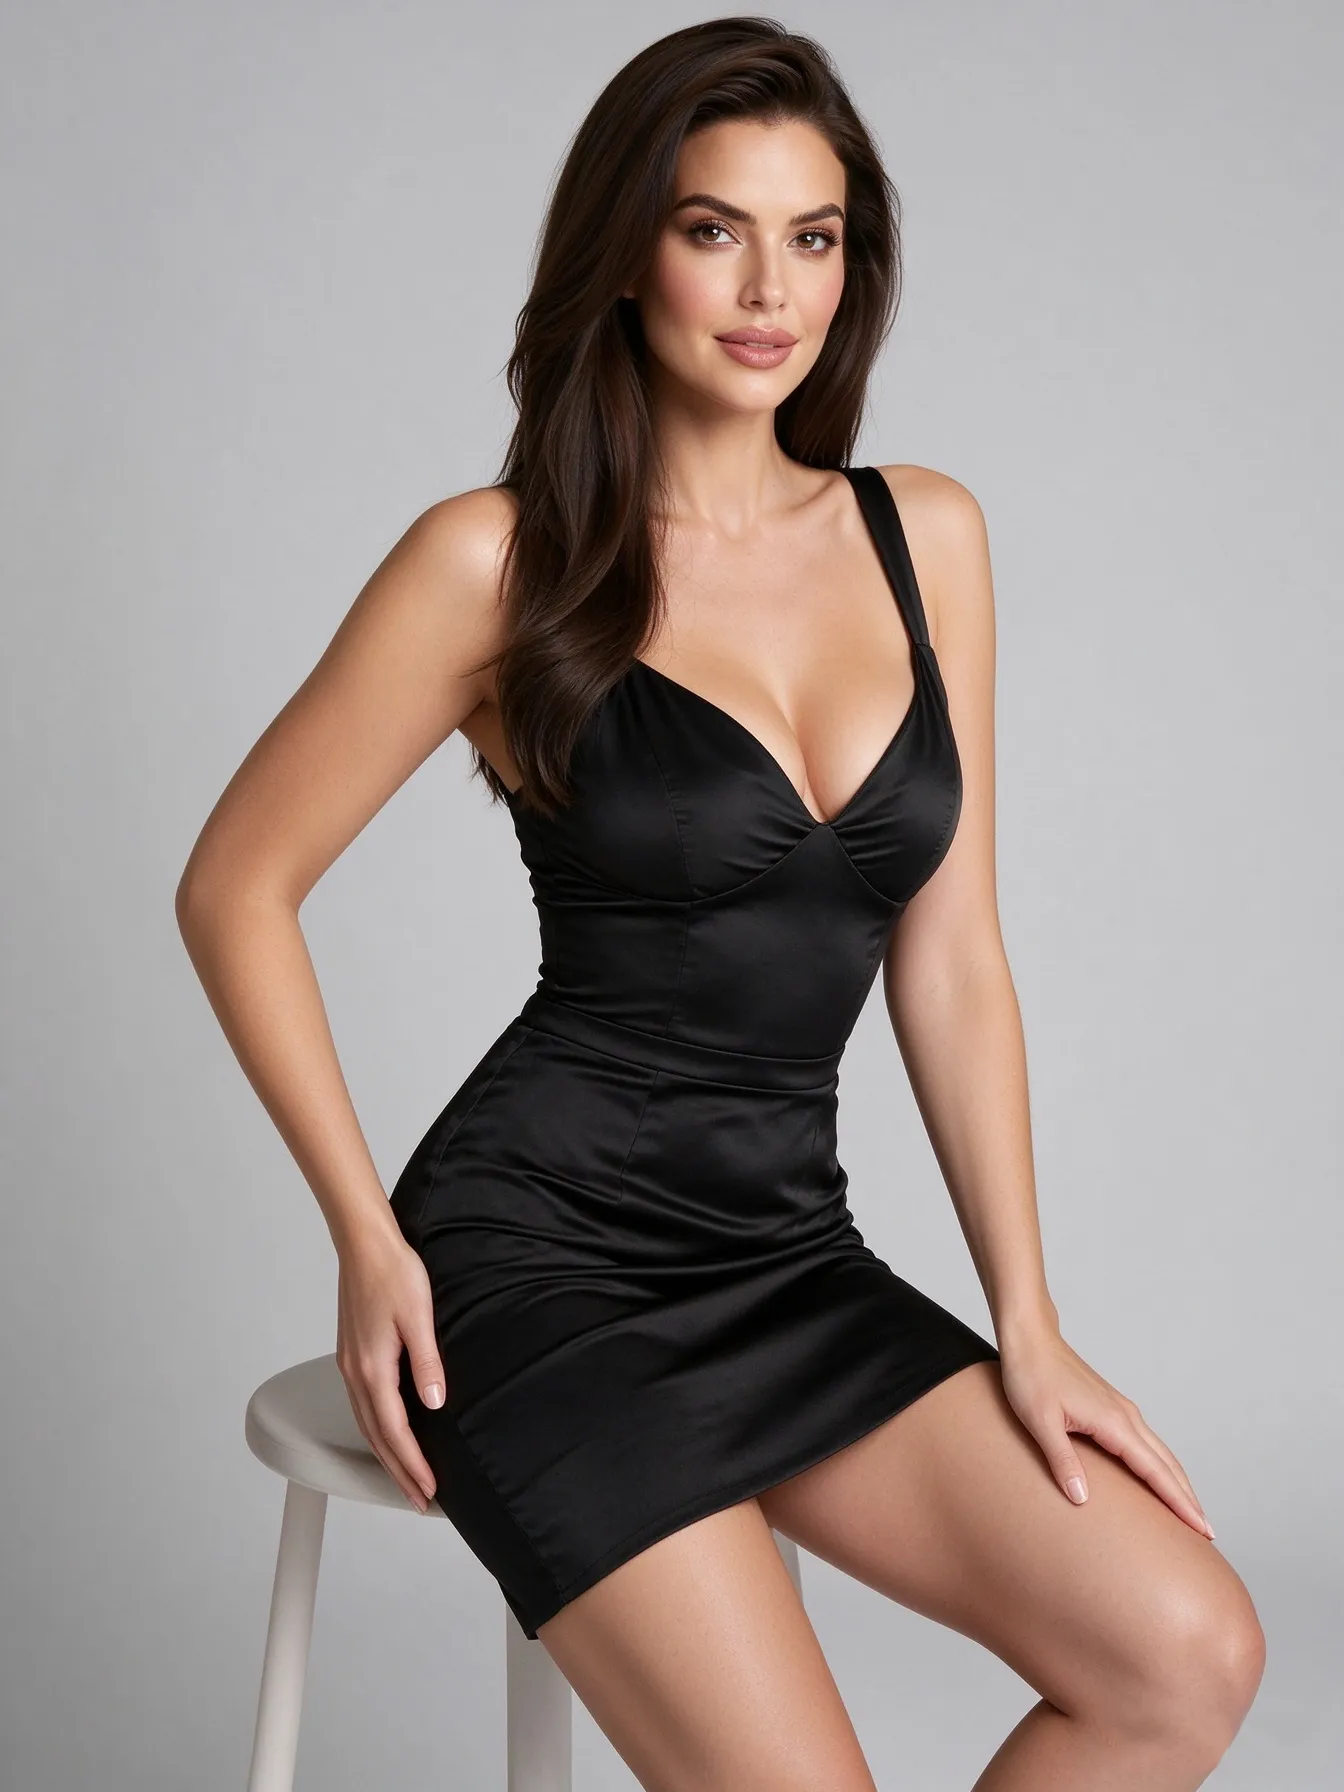
 Bewegingsreferentie
 Gegenereerd resultaat
4. Voeg audio alleen toe met een duidelijke rol
Ref2VA kan audio uit een referentievideo of een los bestand gebruiken. Volgens de huidige officiële regels mag audio niet de enige referentie zijn; er moet een afbeelding of video bij zijn.
Bepaal of de bron dient als:
- Referentie voor stemtimbre
- Referentie voor voordracht of emotie
- Hergebruikte dialoog of songtekst
- Hergebruikte achtergrondmuziek
- Referentie voor ritme of muziekstijl
- Referentie voor omgevingsgeluid
Een stem refereren is niet hetzelfde als het originele signaal kopiëren. Moet het personage nieuwe tekst met een vergelijkbare stem zeggen, definieer de bron dan als timbrereferentie en schrijf de nieuwe dialoog in de prompt.
Audiolabels worden los van videolabels genummerd. <Video 1> en <Audio 1> gelden niet automatisch als delen van hetzelfde bestand tenzij de prompt hun relatie beschrijft.
Gebruik alleen eigen of toegestane gezichts-, video- en stemreferenties. Ref2VA mag niet worden gebruikt om zonder toestemming een herkenbaar persoon na te bootsen.
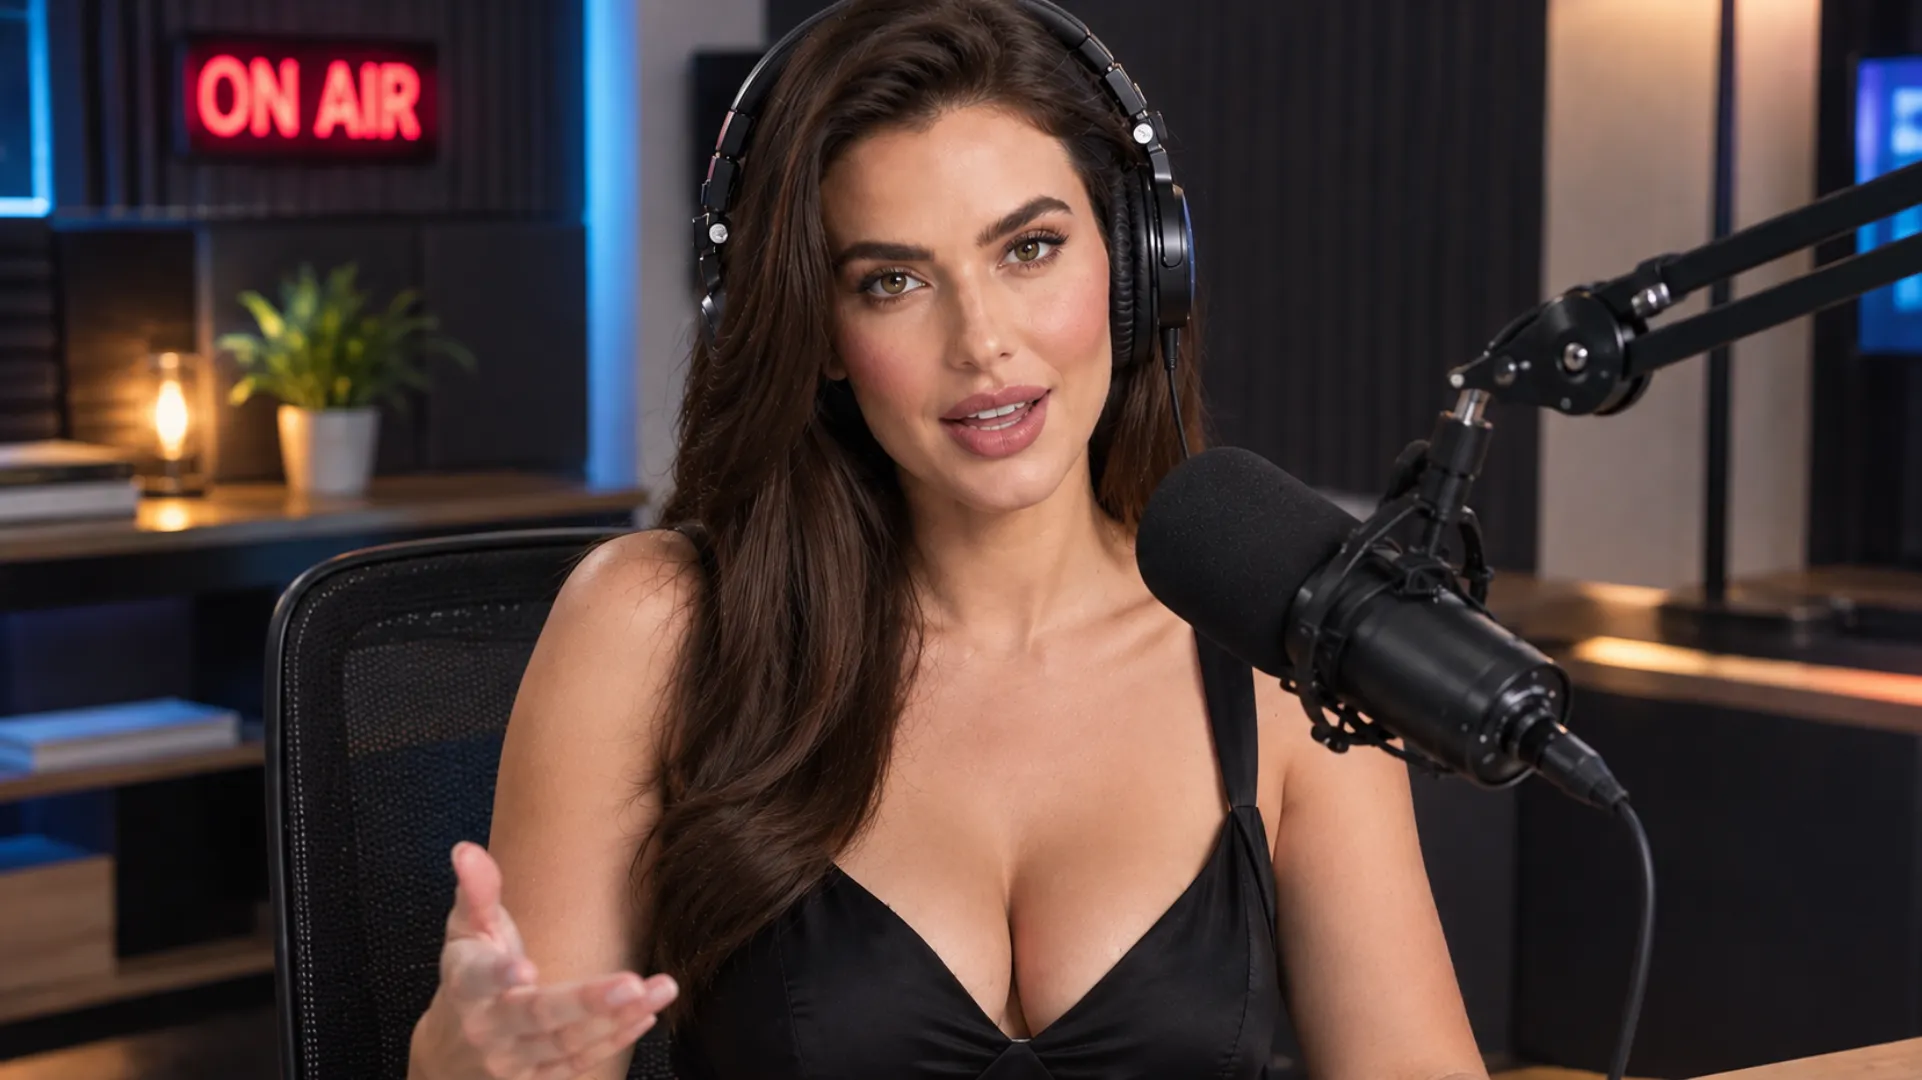 Audioreferentiescène
5. Wijs referenties consistent toe
Gebruik voor elke invoer overal hetzelfde label:
<Picture 1> bepaalt het uiterlijk van <Subject 1>.
<Picture 2> levert een breder beeld van hetzelfde personage.
<Video 1> levert lichaamsbeweging en cameratiming.
<Audio 1> levert het stemtimbre van <Subject 1>.
Noem geen afbeeldings-, video- of audionummer dat niet verbonden is. Verander later niet de betekenis van <Picture 1>.
De workflow ondersteunt meerdere afbeeldingen, video's en audioclips, maar maximale capaciteit is geen aanbevolen beginconfiguratie. Start met één afbeelding en één bewegingsbron. Voeg alleen een referentie toe wanneer die ontbrekende informatie biedt.
6. Voer een korte validatieclip uit
De eerste generatie moet bevatten:
- Eén personage
- Eén hoofdactie
- Eén shot
- Een vaste of beheerste camera
- Een eenvoudige omgeving
- Geen onnodige dialoog of muziek
Controleer het personage voor je complexiteit toevoegt. Gezicht, verhoudingen, stijl, zichtbare bedekking en poserichting moeten van opening tot hoofdbeweging samenhangend blijven.
Zodra de basisclip werkt, voeg je telkens één variabele toe: tweede aanzicht, referentievideo, camerabeweging, audio of een ander persoon. Zo zie je welke bron het resultaat veranderde.
Een NSFW-personage consistent houden tussen referenties
Gebruik verschillende aanzichten van hetzelfde personage
Een nuttige set kan een helder gezicht, een medium shot en een breder lichaamsbeeld bevatten. De beelden moeten andere informatie bieden terwijl ze dezelfde identiteit behouden.
Gezicht, haar, huid, verhoudingen en kenmerkende stijldetails moeten overeenkomen. Als één beeld de gezichtsstructuur of visuele stijl wijzigt, krijgt het model twee concurrerende definities.
Referenties moeten ook passen bij de gewenste visuele toestand. Als kleding of bedekking sterk verschilt, kies dan welke toestand het doel behoudt en verwijder de conflicterende bron.
Samen gebruiken
Niet mengen
Stem het referentiebeeld af op de beweging
Kies een identiteitsbeeld waarop het betrokken lichaamsdeel al zichtbaar is. Kruist de beweging de taille, verandert een zithouding of raakt een hand de romp, dan moeten die gebieden helder en structureel zichtbaar zijn.
De moeilijkheid neemt toe wanneer het model verborgen anatomie moet tonen, overlappende ledematen scheiden of meerdere contactpunten behouden. Een eenvoudige pose kan daarom beter zijn dan een dramatisch beeld.
Voorkom dat de bewegingsbron het personage vervangt
Een bewegingsvideo kan een performer bevatten wiens gezicht, lichaam, kleding of omgeving visueel sterker is dan het identiteitsbeeld. Het model kan meer van die bron behouden dan bedoeld.
Definieer het doelonderwerp vóór de beweging en zeg dat de referentieperformer niet behouden blijft. Kies bij verzwakte identiteit een clip met minder prominent brongezicht of beter passende pose.
Test nauwe interactie afzonderlijk
Interactie tussen twee personen voegt een identiteit, meer ledematen, tijdelijke afdekking en bewegende contactpunten toe. Gebruik dit niet als eerste test van een nieuw personage.
Valideer eerst het hoofdpersonage alleen en voeg daarna het tweede onderwerp toe in een kort, beheerst shot. Houd lichamen waar mogelijk gescheiden en verander niet tegelijk meerdere handen, gezichten en camerabewegingen.
Maak voor een langere reeks aparte clips voor introductie, poseverandering, nauwe interactie en eindshot. Hergebruik goedgekeurde identiteitsreferenties in plaats van alle overgangen in één generatie te forceren.
Ref2VA prompten voor consistente NSFW-personages en beweging
Een Ref2VA-prompt moet de doelvideo én de relatie tot de bronnen uitleggen. Uiterlijkheidswoorden herhalen vervangt geen duidelijke referentietoewijzing.
Het volledige referentieformaat van MiniMax verdeelt een Ref2VA-verzoek in zes secties:
subject_definitions:
<Subject 1> is de fictieve volwassen vrouw wier gezichtsidentiteit, lange donkere haar, lichaamsverhoudingen en zwarte satijnen stijl uit <Picture 1> komen.
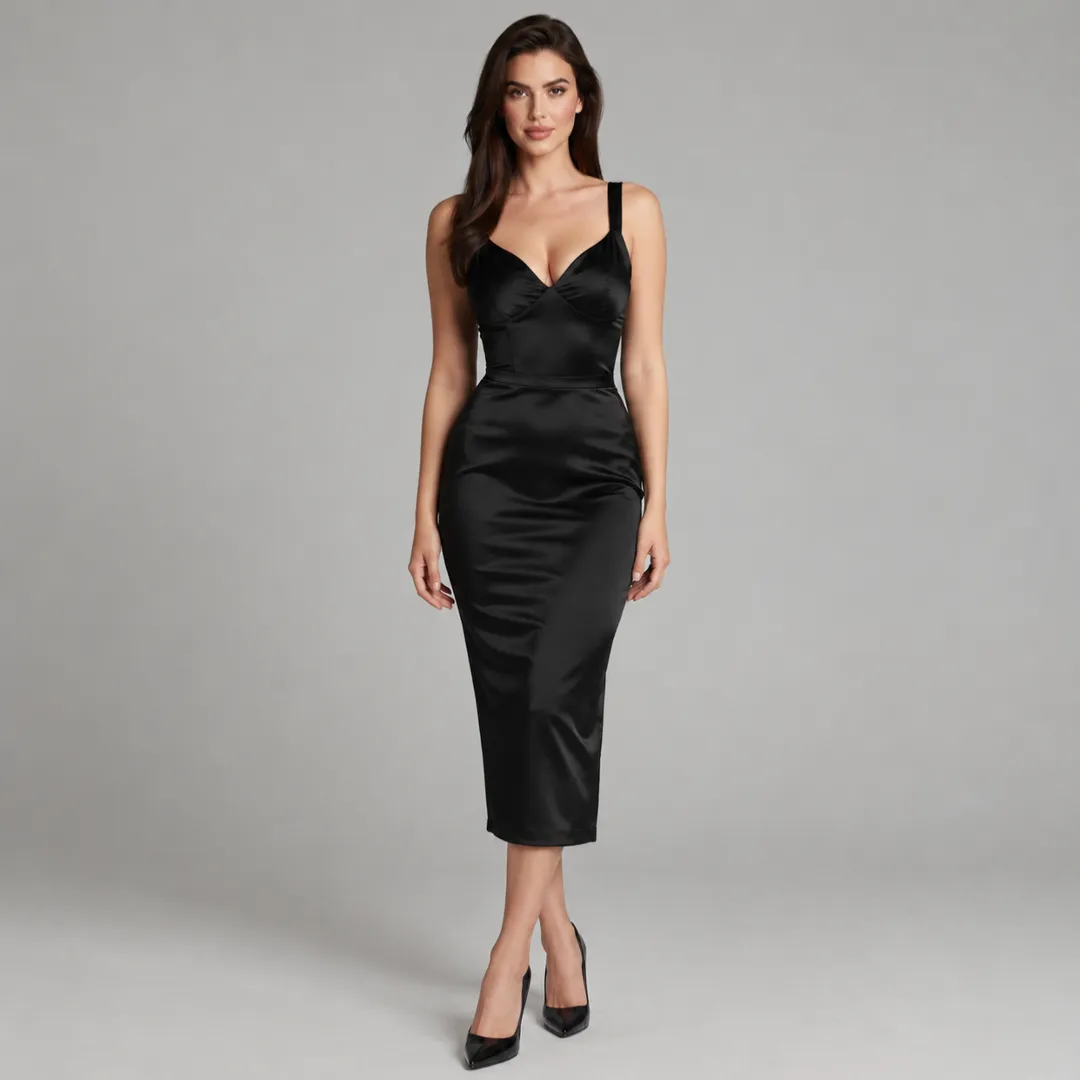
<Picture 2> toont hetzelfde personage breder en bevestigt haar verhoudingen en beginhouding.
<Video 1> levert een langzame zittende pose-aanpassing en beheerste camerabeweging.
<Audio 1> is de stemtimbreferentie voor <Subject 1> (S1).

summary:
[referentiegeneratie + audioreferentie]
Het doel is een video in één shot van <Subject 1> in een privéstudio. Identiteit en stijl volgen <Picture 1> en <Picture 2>. Beweging en cameratiming volgen <Video 1>. Het stemtimbre refereert aan <Audio 1>.

retention_analysis:
<Subject 1>: fully_preserved - gezicht, haar, verhoudingen, satijnen stijl en algemene visuele toestand behouden.
<Video 1>: reference - poseverandering en cameraritme overdragen zonder performer of omgeving van de bron te behouden.
<Audio 1>: reference - stemtimbre sturen zonder de opname te kopiëren.

detailed_description:
De video gebruikt realistische fotografische belichting in een rustige privéstudio.
[Shot 1] <Subject 1> zit in een driekwart medium shot. Volgens de beheerste beweging uit <Video 1> verplaatst ze langzaam haar gewicht, draait één schouder naar de camera en neemt de nieuwe pose aan. De camera beweegt één keer beheerst vooruit zonder hoekwijziging. <Subject 1> (S1) zegt met de rustige stemkwaliteit uit <Audio 1>: <d>[Nederlands] Blijf hier even.</d>

overall_soundscape:
Rustige kamertoon, subtiele stofbeweging en de gerefereerde stemvoordracht.

non_diegetic_music:
Geen achtergrondmuziek.
Deze prompt definieert identiteit één keer en besteedt de overige details aan beweging, camera en geluid. Herhaal gezicht en lichaam niet in elk veld.
Voeg voor één doorlopend shot geen losse camera-instructies toe. Vereist een tweede actie een andere pose, kadrering of contactpatroon, maak er dan mogelijk een aparte clip van.
 NSFW-scène
Een praktische MiniMax H3 Ref2VA-workflow voor NSFW AI-video
Een herbruikbare workflow moet pas complexer worden wanneer de vorige laag stabiel blijft.
Stap 1: keur de personageafbeelding goed
Kies een afbeelding die identiteit, lichaamsrichting, stijl en visuele toestand vastlegt. Is er geen geschikte, maak er dan één met de AINSFW.AI Real Girl Generator, Anime Girl Generator of Afbeelding Generator op basis van Tags.
Ga niet verder alleen omdat de afbeelding aantrekkelijk is. Controleer of ze genoeg visuele informatie voor de eerste geplande actie bevat.
Stap 2: maak een identiteitstest
Genereer een korte close-up of medium shot met oogbeweging, ademhaling, subtiele uitdrukking of kleine hoofddraai. Zo test je herkenbaarheid vóór grotere lichaamsbeweging.
Stap 3: voeg beheerste lichaamsbeweging toe
Gebruik een bredere identiteitsreferentie en vraag één aanpassing van schouder, romp, taille of zithouding. Houd de camera bij de eerste test vast.
Als het personage bij een kleine beweging verandert, maakt een complexere bron die verandering meestal zichtbaarder.
Stap 4: introduceer de bewegingsreferentie
Verbind een korte video met passende beginpose. Geef aan dat deze beweging en cameratiming levert, niet identiteit.
Vergelijk het resultaat met de vorige test. Gaat het doel op de referentieperformer lijken, vereenvoudig de bron of maak de onderwerpstoewijzing explicieter.
Stap 5: voeg camera en audio toe
Zodra de lichaamsbeweging stabiel is, voeg je één cameragedrag toe. Stem, sfeer of muziek volgen nadat de visuele referenties samenwerken.
Verander bewegingsbron, camera, audio, promptstructuur en generatie-instellingen niet in dezelfde test. Een resultaat is waardevoller wanneer de oorzaak begrijpelijk is.
Stap 6: maak onafhankelijke videoshots
Maak aparte clips voor verschillende productierollen:
- Identiteitsshot: close of medium kadrering met subtiele uitdrukking.
- Poseshot: één beheerste lichaams- of houdingsovergang.
- Breder bewegingsshot: grotere beweging ondersteund door een bredere referentie.
- Interactieshot: apart geteste clip met extra contact of ander onderwerp.
Genereer elke clip vanuit de goedgekeurde set in plaats van het vorige resultaat als enige bron te gebruiken. Dit vermindert cumulatieve identiteitsdrift.
Als lokale modellen, referentietoewijzing en ComfyUI-onderhoud meer controle bieden dan nodig, gebruik dan de goedgekeurde afbeelding met de AINSFW.AI-afbeelding-naar-video-generator. Dit is eenvoudiger wanneer de taak met één afbeelding begint en geen meerdere video- of audioreferenties vraagt.
Veelgestelde vragen over MiniMax H3 Ref2VA
Is MiniMax H3 Ref2VA hetzelfde als MiniMax H3 R2V?
In de huidige ComfyUI-documentatie kan het sjabloon MiniMax H3 R2V heten terwijl taak en checkpoint ref2va gebruiken. Hier verwijzen beide naar de referentie-naar-audiovideoworkflow, niet naar de FL2VA-keyframeroute.
Kan Ref2VA meerdere personageafbeeldingen gebruiken?
Ja. De officiële workflow ondersteunt meerdere beeldreferenties. Gebruik extra beelden voor passende hoeken, lichaamsinformatie, stijl of omgeving. Beelden die verschillen in identiteit of verhoudingen kunnen consistentie verminderen.
Waarom verbindt een geladen video niet met Ref2VA?
De loader kan een VIDEO-object geven terwijl de invoer frames verwacht. Gebruik zo nodig de ingebouwde Get Video Components-node om frames, audio en metadata te scheiden.
Kan Ref2VA afbeeldingen, video en audio combineren?
Ja. Ref2VA is ontworpen voor gemengde multimodale referenties. Verbind minstens één afbeelding of video, label elke bron consequent en geef aan of die identiteit, beweging, camera, herbruikbare audio of stemkarakter levert.
Garandeert Ref2VA een consistent NSFW-personage?
Nee. Ref2VA biedt meer referentie-informatie, maar consistentie hangt nog af van bronovereenkomst, zichtbare lichaamsinformatie, posecompatibiliteit, prompthelderheid, bewegingscomplexiteit en afdekking. Korte tests en beheerste toevoegingen blijven nodig.