
Resposta rápida: como usar o MiniMax H3 Ref2VA para vídeo NSFW?
Use o checkpoint dedicado MiniMax H3 Ref2VA num fluxo R2V compatível do ComfyUI. Comece com uma imagem aprovada, ligue-a como <Picture 1> e defina o sujeito recorrente no prompt. Adicione vídeo de referência apenas quando precisar de movimento, padrão de câmara, estrutura de edição ou continuação específicos. Ligue o áudio separadamente quando ele orientar voz, música, ritmo ou banda sonora reutilizável.
Para vídeo NSFW, a ordem mais segura é identidade da personagem, movimento corporal simples, movimento de câmara e, por fim, interação próxima. Teste cada adição com um clipe curto antes de introduzir outra referência.
O Ref2VA melhora o controlo por referência, mas não garante identidade ou anatomia perfeitas. Os resultados ainda dependem de poses compatíveis, limites corporais claros, imagens consistentes e um prompt inequívoco.
Se não tiver uma personagem inicial estável, crie e aprove uma com o Gerador de imagens da AINSFW.AI antes de montar o fluxo Ref2VA.
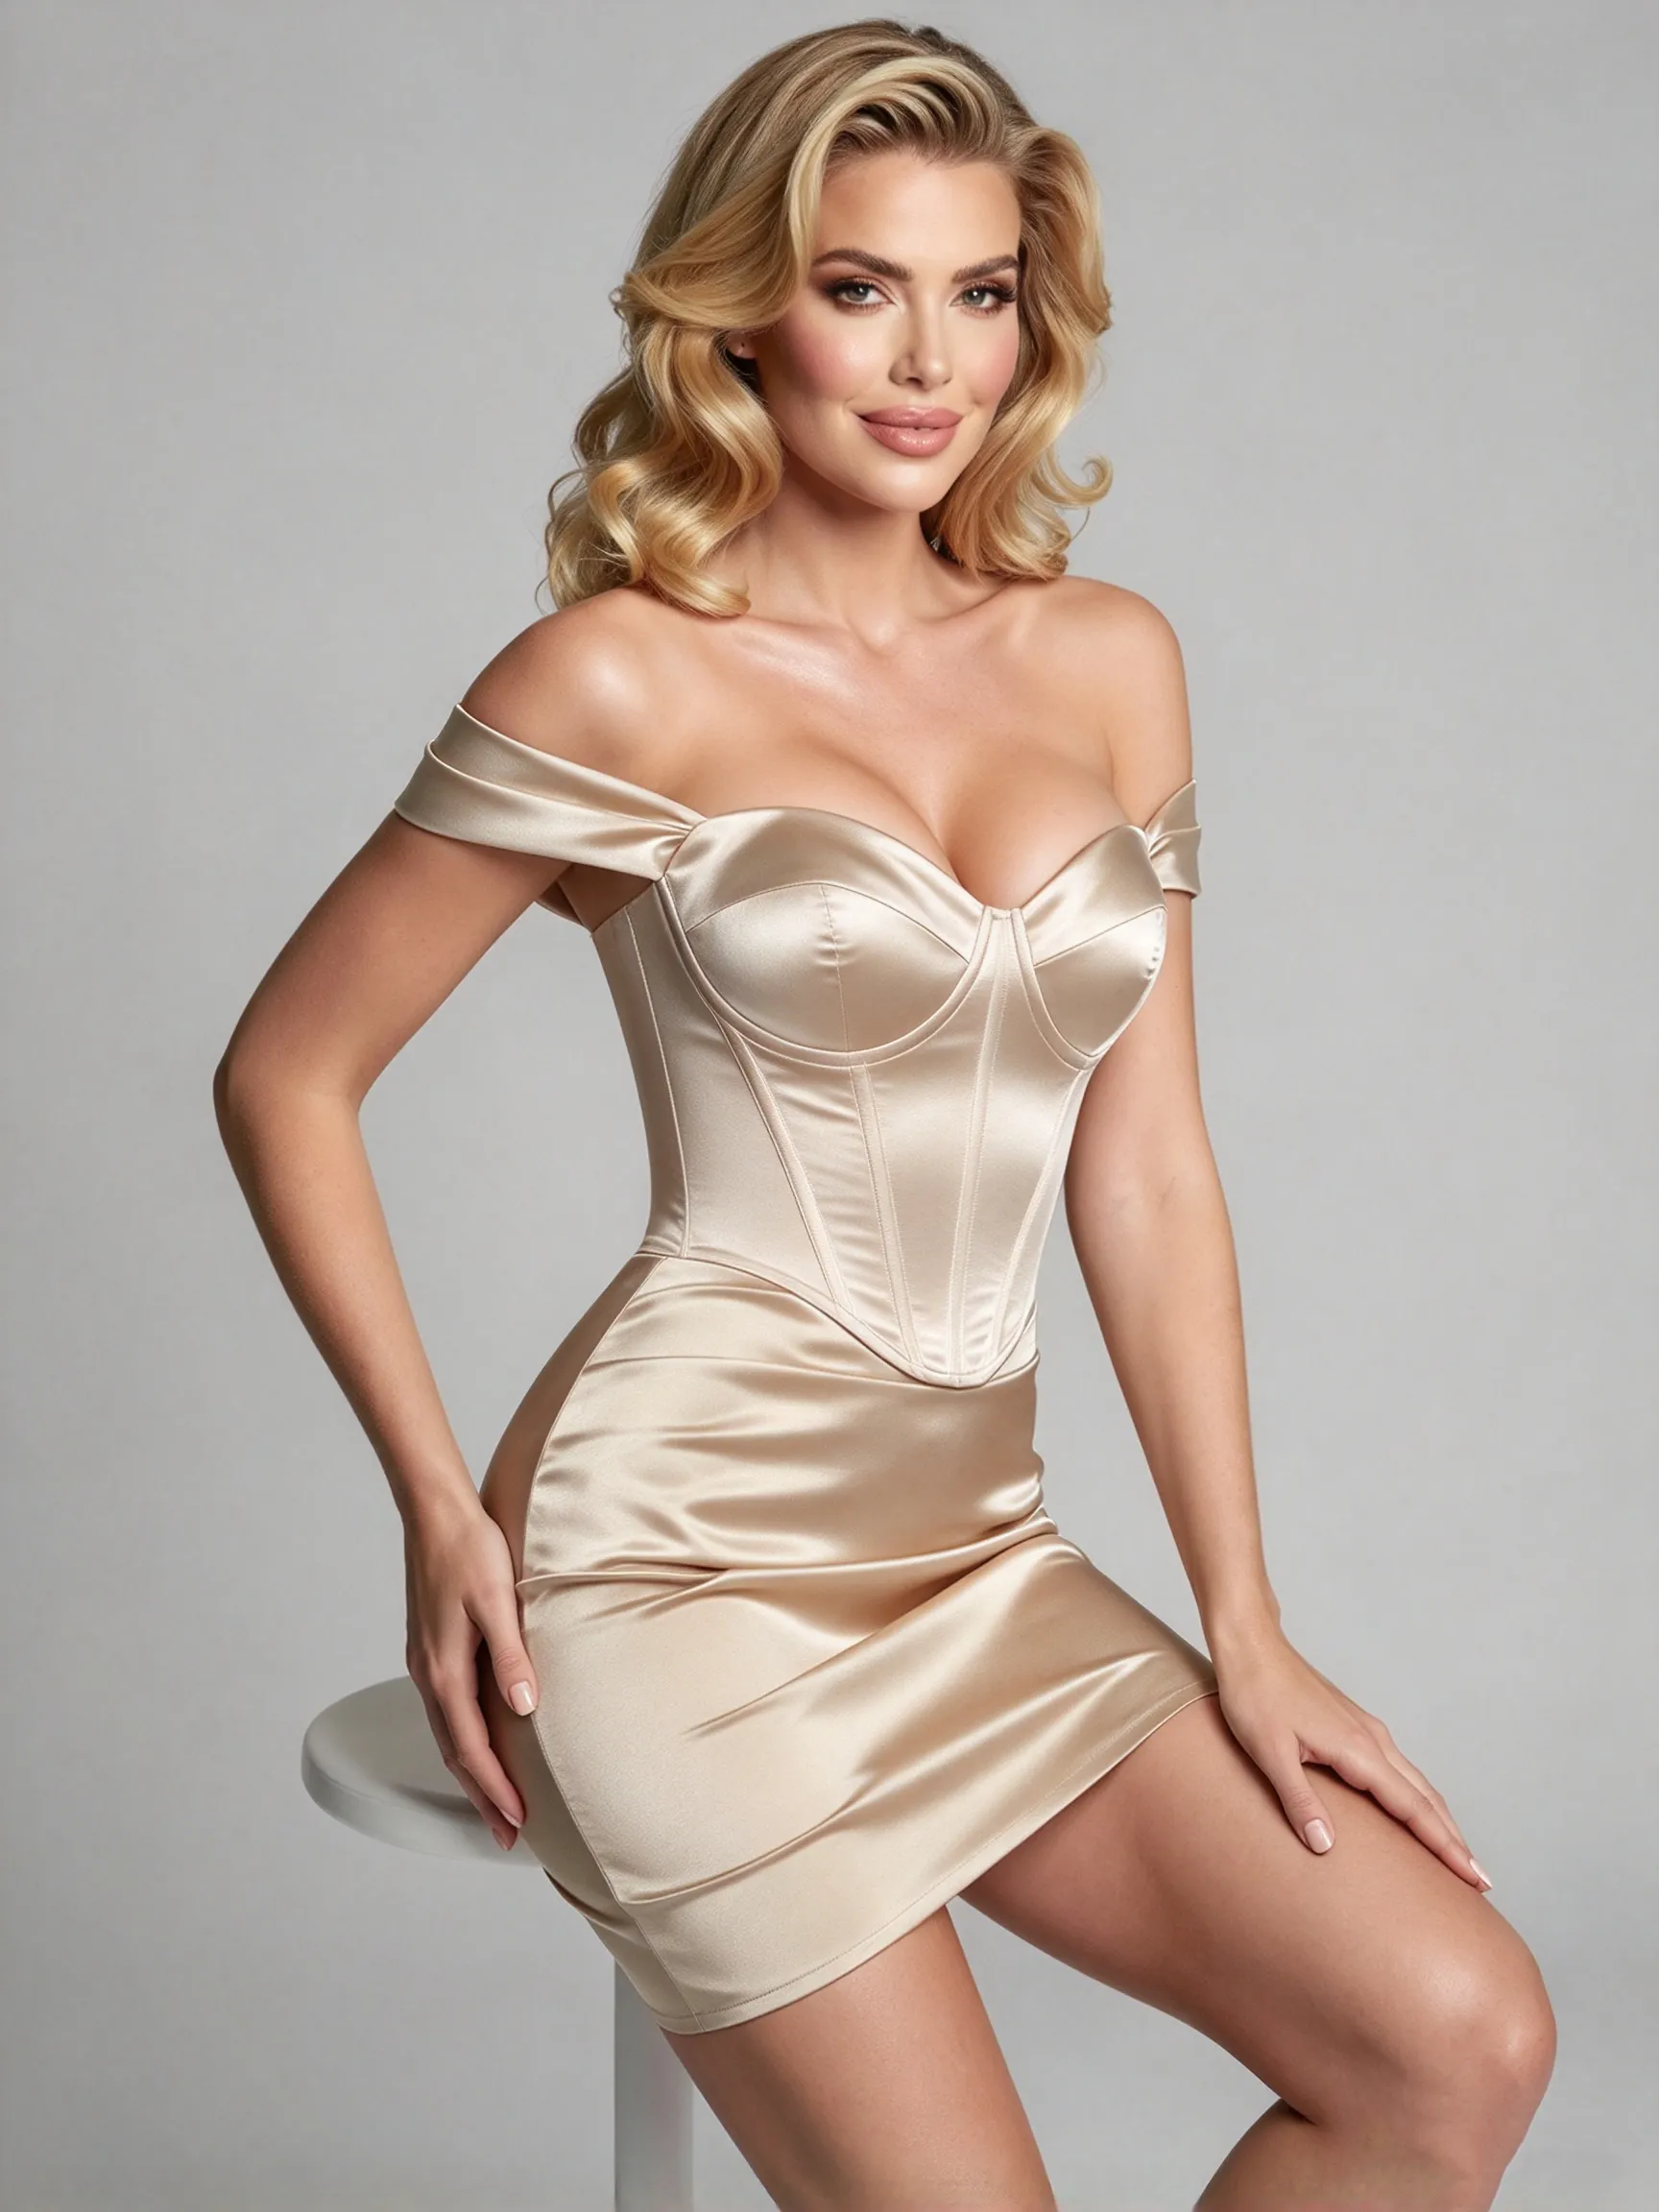
 Apresentação da personagem NSFW
MiniMax H3 Ref2VA ou FL2VA: que fluxo deve usar?
O MiniMax H3 usa checkpoints separados por tarefa. O FL2VA trata texto-para-áudio-vídeo e geração condicionada pelo primeiro ou último fotograma. O Ref2VA trata referência-para-áudio-vídeo com imagens, vídeos, áudio ou referências mistas.
| O seu objetivo | Rota recomendada |
|---|---|
| Gerar uma cena a partir de texto | T2VA com FL2VA |
| Animar um fotograma inicial exato | I2VA com FL2VA |
| Ligar fotograma inicial e final | FL2VA |
| Preservar uma personagem sem impor a imagem como fotograma zero | Ref2VA |
| Transferir movimento ou comportamento de câmara | Ref2VA |
| Referenciar voz, banda sonora, ritmo ou textura sonora | Ref2VA |
| Editar ou continuar uma fonte audiovisual existente | Ref2VA |
A diferença é o papel do recurso. Uma imagem ligada como primeiro fotograma estabelece a composição inicial real. A mesma imagem no Ref2VA pode definir rosto, corpo, estilo, ambiente ou pose sem se tornar o primeiro fotograma.
Isso importa em fluxos de personagens NSFW. Uma imagem inicial pode ancorar um clipe, mas talvez não forneça informação suficiente quando o corpo roda, o plano abre ou outro sujeito causa oclusão temporária. O Ref2VA pode usar vistas adicionais se mostrarem a mesma personagem.
Os dois fluxos também usam pesos de difusão diferentes. Carregar pesos FL2VA num fluxo Ref2VA não cria comportamento multimodal só porque os nós em redor parecem compatíveis.
Como configurar o MiniMax H3 Ref2VA no ComfyUI
1. Carregue o modelo e o fluxo Ref2VA
Atualize o ComfyUI antes de abrir o fluxo. Nós e modelos nativos recentes do MiniMax H3 podem não existir numa instalação antiga.
Abra a biblioteca de modelos e procure MiniMax H3 R2V, ou use o JSON oficial atual. O ComfyUI pode usar “R2V” no nome do modelo enquanto o checkpoint e a tarefa usam ref2va. Aqui ambos indicam a mesma rota de referência-para-vídeo.
Na estrutura padrão do ComfyUI, o modelo de difusão Ref2VA fica em models/diffusion_models, o codificador de texto em models/text_encoders, os VAE de vídeo e áudio em models/vae e o LoRA turbo opcional em models/loras.
Confirme que o fluxo carrega o modelo Ref2VA, não a versão FL2VA. Use os ficheiros indicados pelo modelo atual, pois BF16, INT8, NVFP4 e outras variantes podem exigir carregadores ou configurações de memória diferentes.
No primeiro teste, use a rota normal de geração. O LoRA turbo opcional de quatro passos acelera a iteração, mas a documentação oficial indica possível redução na qualidade de movimento e áudio.
2. Adicione uma referência aprovada da personagem
Comece com uma imagem, não com uma galeria inteira. O rosto deve estar nítido, a área corporal desejada visível e os limites da pose legíveis.
Para um plano próximo falado, uma referência nítida do rosto e tronco pode bastar. Para ajustar uma pose sentada ou um movimento sensual mais amplo, use uma imagem com ombros, tronco, cintura, mãos e postura inicial. Não peça a um retrato muito cortado informação corporal que nunca conteve.
Ligue a imagem à primeira entrada de referência de imagem. No prompt, ela torna-se <Picture 1>. As imagens adicionais são numeradas pela ordem de ligação.
A imagem de identidade mais forte deve estabelecer:
- Formato do rosto e traços reconhecíveis
- Aspeto do cabelo e da pele
- Proporções corporais visíveis no plano final
- Estilo ou estado de roupa a manter
- Pose inicial e direção do corpo
Não comece por ligar versões com rostos, penteados, proporções ou estilos visuais diferentes. Mais referências só ajudam quando acrescentam informação compatível.
3. Ligue um vídeo de referência de movimento
Um vídeo de referência pode fornecer movimento corporal, comportamento de câmara, ritmo de edição, uma cena a modificar ou um ponto de continuação. O prompt deve especificar a relação pretendida.
Alguns carregadores de vídeo do ComfyUI devolvem um objeto VIDEO, enquanto a entrada MiniMax H3 espera uma sequência de imagens extraída. Se as portas não ligarem, use o nó nativo Get Video Components para expor fotogramas, áudio, frame rate e componentes relacionados. Ligue a sequência à entrada de vídeo de referência.
Se também precisar da banda sonora original, ligue o áudio extraído separadamente. Não presuma que carregar um vídeo atribui automaticamente o áudio como referência <Audio N> utilizável.
Para transferir movimento, escolha uma fonte cuja postura inicial se pareça com a da personagem alvo. Uma personagem sentada e uma fonte sentada são mais fáceis de conciliar do que um retrato fechado e uma rotação imediata de corpo inteiro em pé.
O movimento também deve continuar legível. Grande sobreposição corporal, mãos escondidas atrás do tronco, cabelo sobre articulações ou duas pessoas a cruzarem-se podem obrigar o modelo a reconstruir informação que nenhuma fonte mostra claramente.
Indique que o vídeo fornece movimento, não identidade:
<Subject 1> recebe a identidade e aparência de <Picture 1>.
<Video 1> fornece apenas o ajuste lento da pose sentada e o ritmo de câmara.
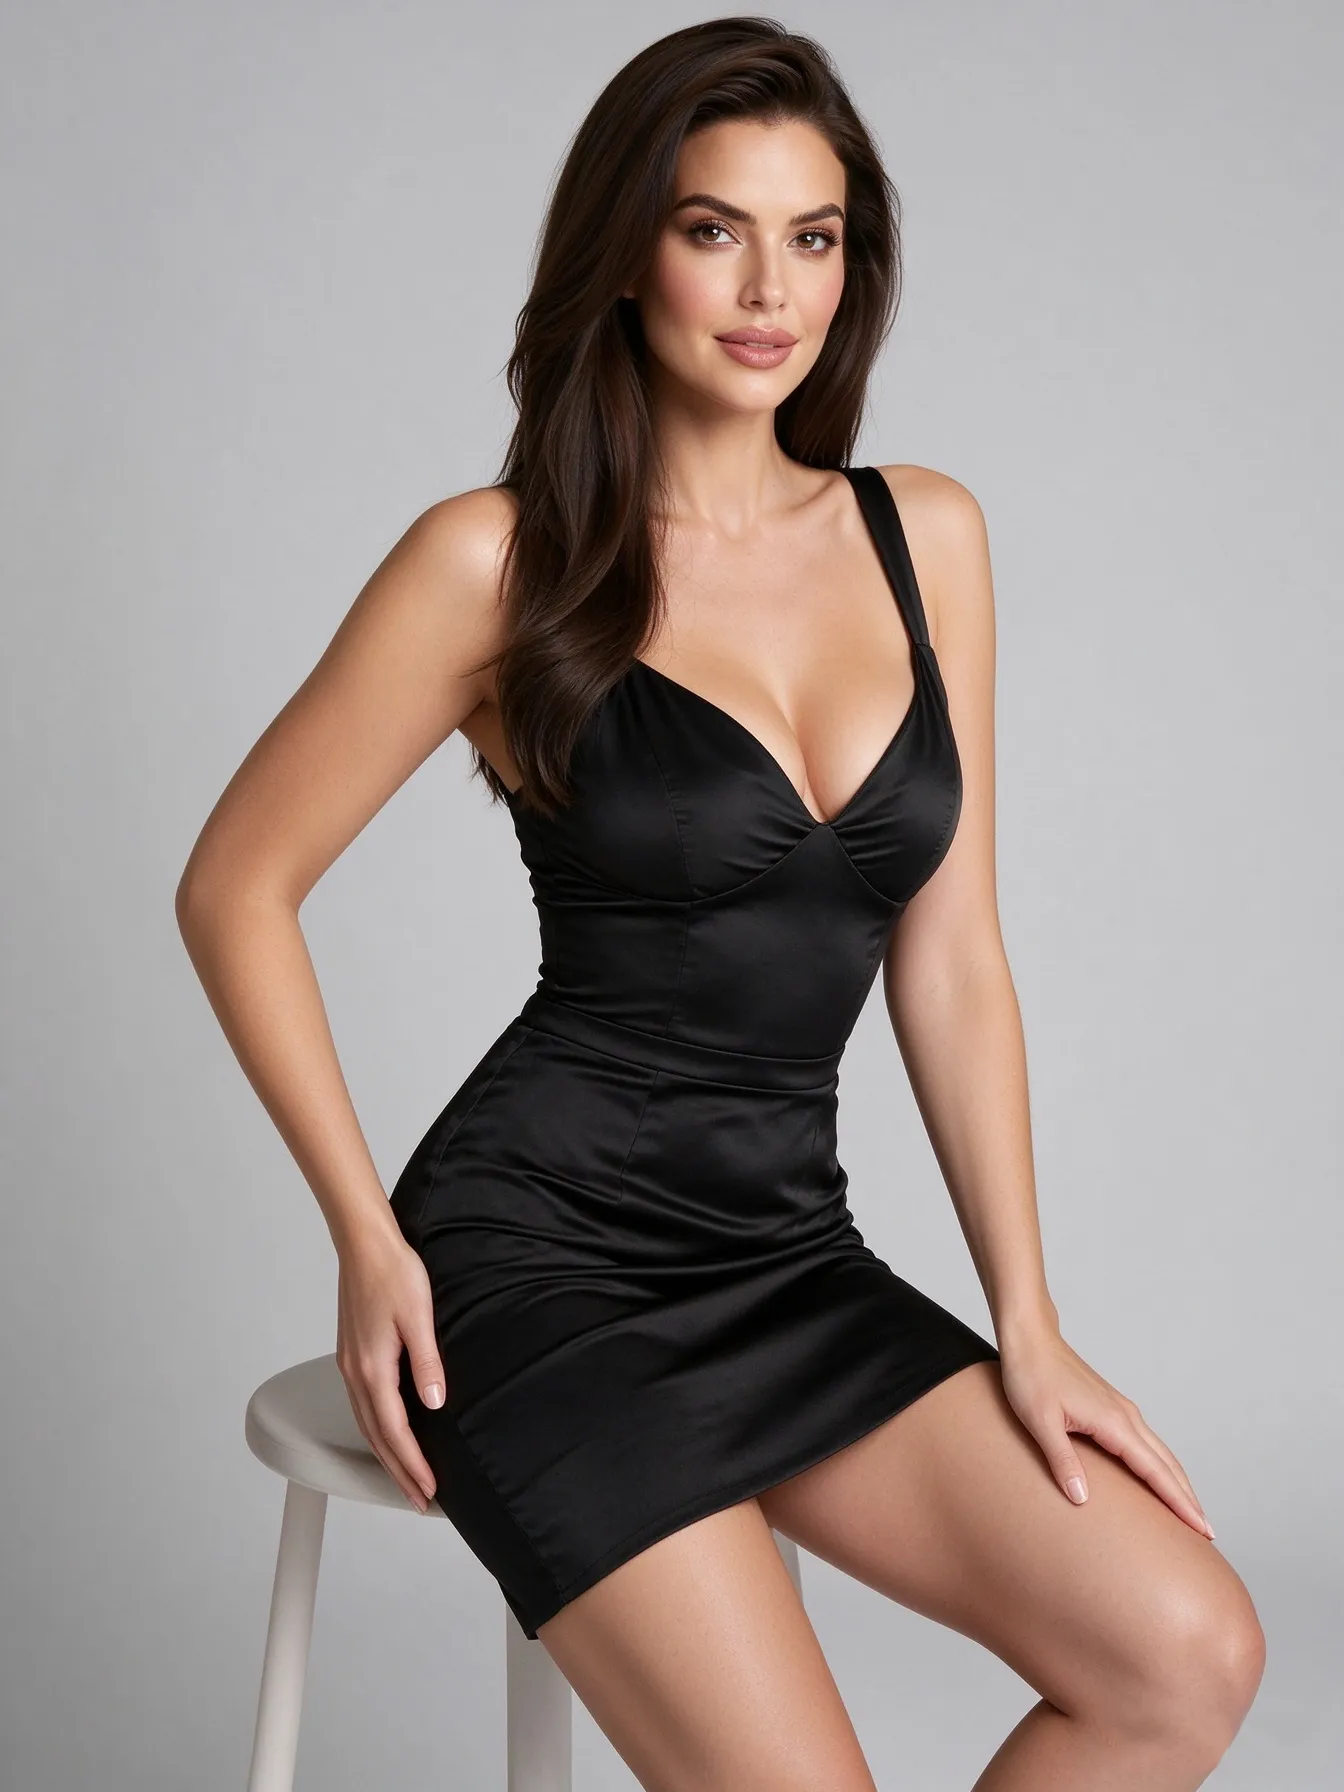
A intérprete de <Video 1> não é mantida no vídeo alvo.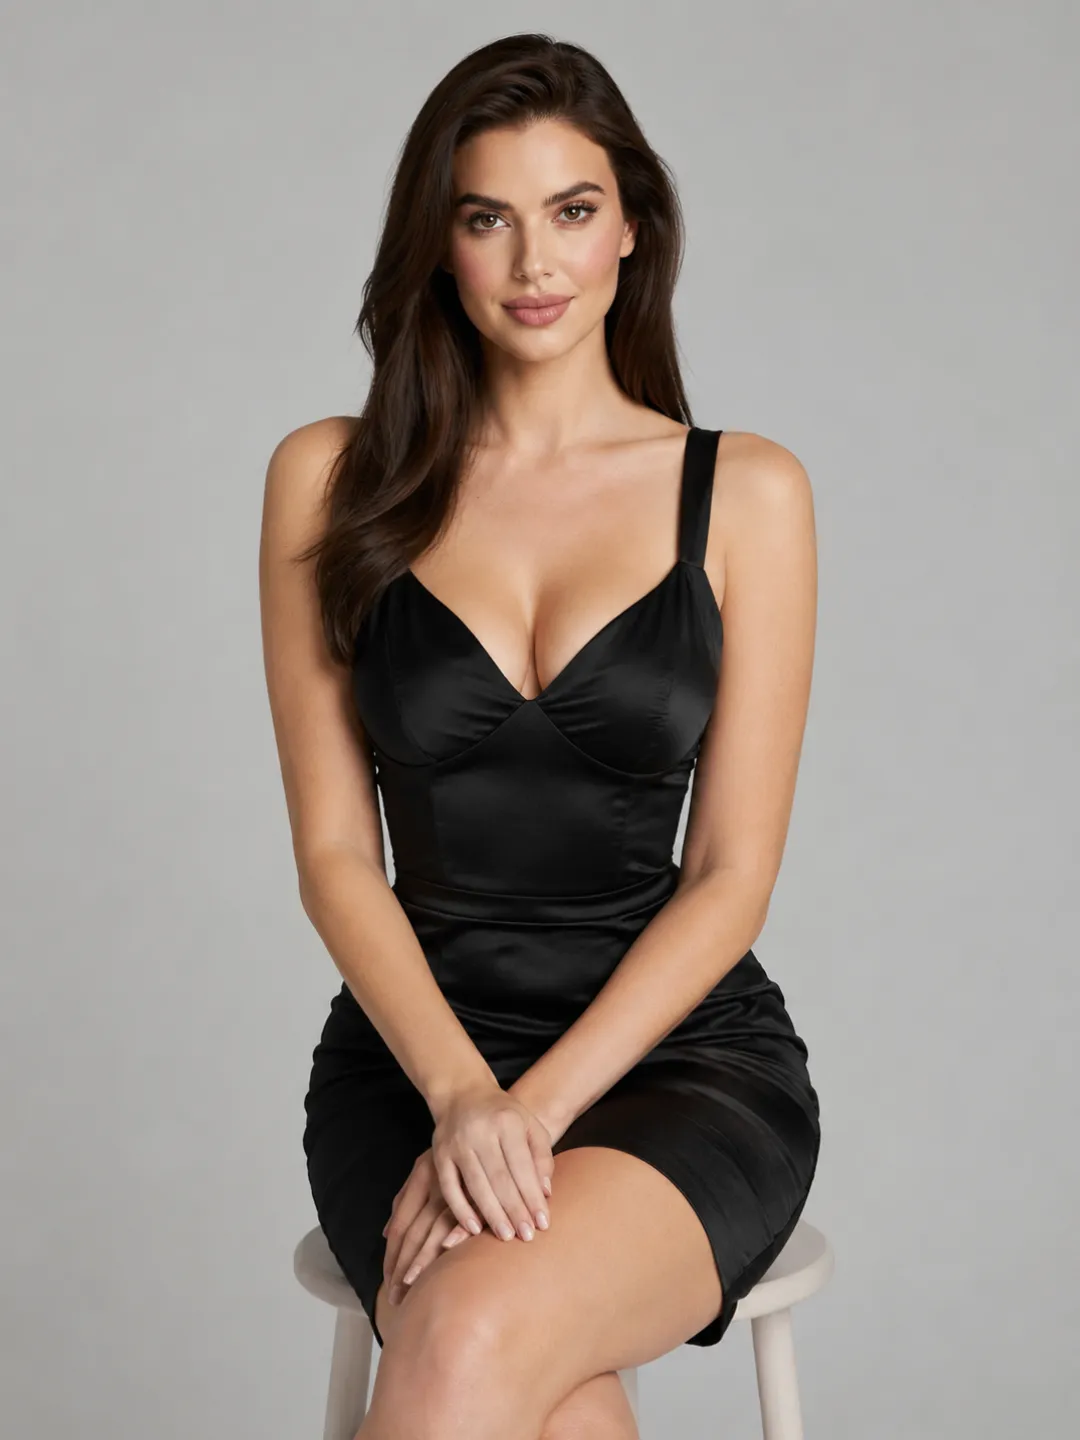 Referência da personagem
 Referência de movimento
 Resultado gerado
4. Adicione áudio apenas com uma função clara
O Ref2VA pode usar áudio extraído de um vídeo de referência ou carregado em separado. Pelas regras oficiais atuais, o áudio não pode ser o único meio de referência; deve acompanhar uma imagem ou vídeo.
Decida se a fonte deve ser:
- Referência de timbre de voz
- Referência de interpretação ou emoção
- Diálogo ou letra reutilizados
- Música de fundo reutilizada
- Referência de ritmo ou estilo musical
- Referência de som ambiente
Referenciar uma voz não é copiar o sinal original. Se a personagem deve dizer um novo diálogo com qualidade semelhante, defina a fonte como referência de timbre e escreva o novo diálogo no prompt.
As etiquetas de áudio são numeradas separadamente das de vídeo. <Video 1> e <Audio 1> não são entendidos automaticamente como partes do mesmo ficheiro sem que o prompt explique a relação.
Use apenas referências de rosto, vídeo e voz próprias ou autorizadas. O Ref2VA não deve ser usado para imitar uma pessoa identificável sem permissão.
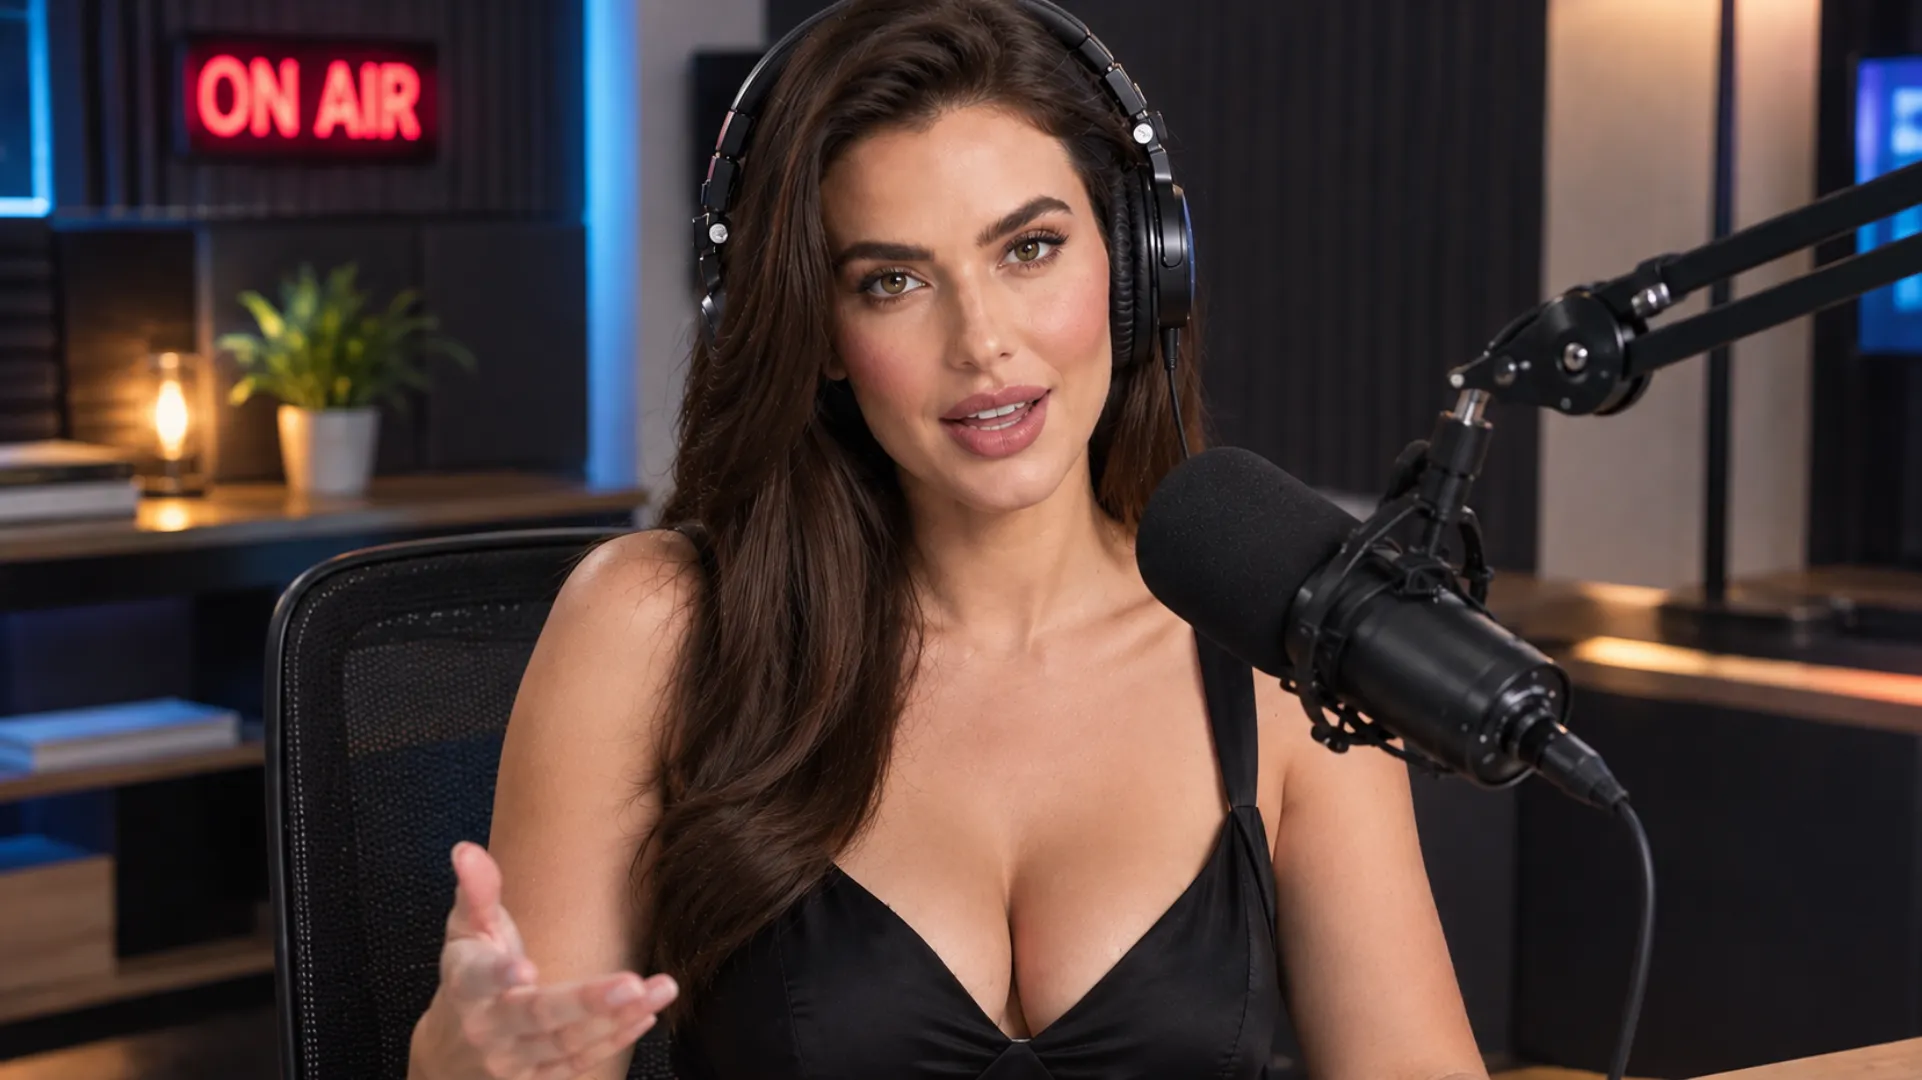 Cena de referência de áudio
5. Mapeie as referências de forma consistente
Use a mesma etiqueta para cada entrada em todo o prompt:
<Picture 1> define a aparência de <Subject 1>.
<Picture 2> fornece uma vista mais ampla da mesma personagem.
<Video 1> fornece movimento corporal e timing de câmara.
<Audio 1> fornece o timbre vocal de <Subject 1>.
Não mencione números de imagem, vídeo ou áudio que não estejam ligados. Não altere depois o significado de <Picture 1>.
O fluxo suporta várias imagens, vídeos e faixas de áudio, mas a capacidade máxima não é uma configuração inicial recomendada. Comece com uma imagem e uma fonte de movimento. Adicione outra referência apenas se ela trouxer informação em falta.
6. Execute um clipe curto de validação
A primeira geração deve conter:
- Uma personagem
- Uma ação principal
- Um plano
- Câmara fixa ou contida
- Ambiente simples
- Sem diálogo ou música desnecessários
Verifique a personagem antes de aumentar a complexidade. Rosto, proporções, estilo, cobertura corporal visível e direção da pose devem permanecer coerentes da abertura ao movimento principal.
Quando o clipe básico funcionar, adicione uma variável de cada vez: segunda vista, vídeo de referência, movimento de câmara, áudio ou outra pessoa. Assim identifica qual nova fonte alterou o resultado.
Como manter uma personagem NSFW consistente entre referências
Use vistas diferentes da mesma personagem
Um conjunto útil pode ter uma vista nítida do rosto, um plano médio e uma vista corporal mais ampla. As imagens devem fornecer informação diferente, preservando a mesma identidade.
Rosto, cabelo, pele, proporções e detalhes de estilo devem coincidir. Se uma imagem mudar a estrutura facial ou o estilo visual, o modelo recebe duas definições concorrentes.
As referências também devem concordar com o estado visual do plano final. Se uma imagem apresentar roupa ou cobertura muito diferentes, decida que estado preservar e remova a fonte em conflito.
Usar em conjunto
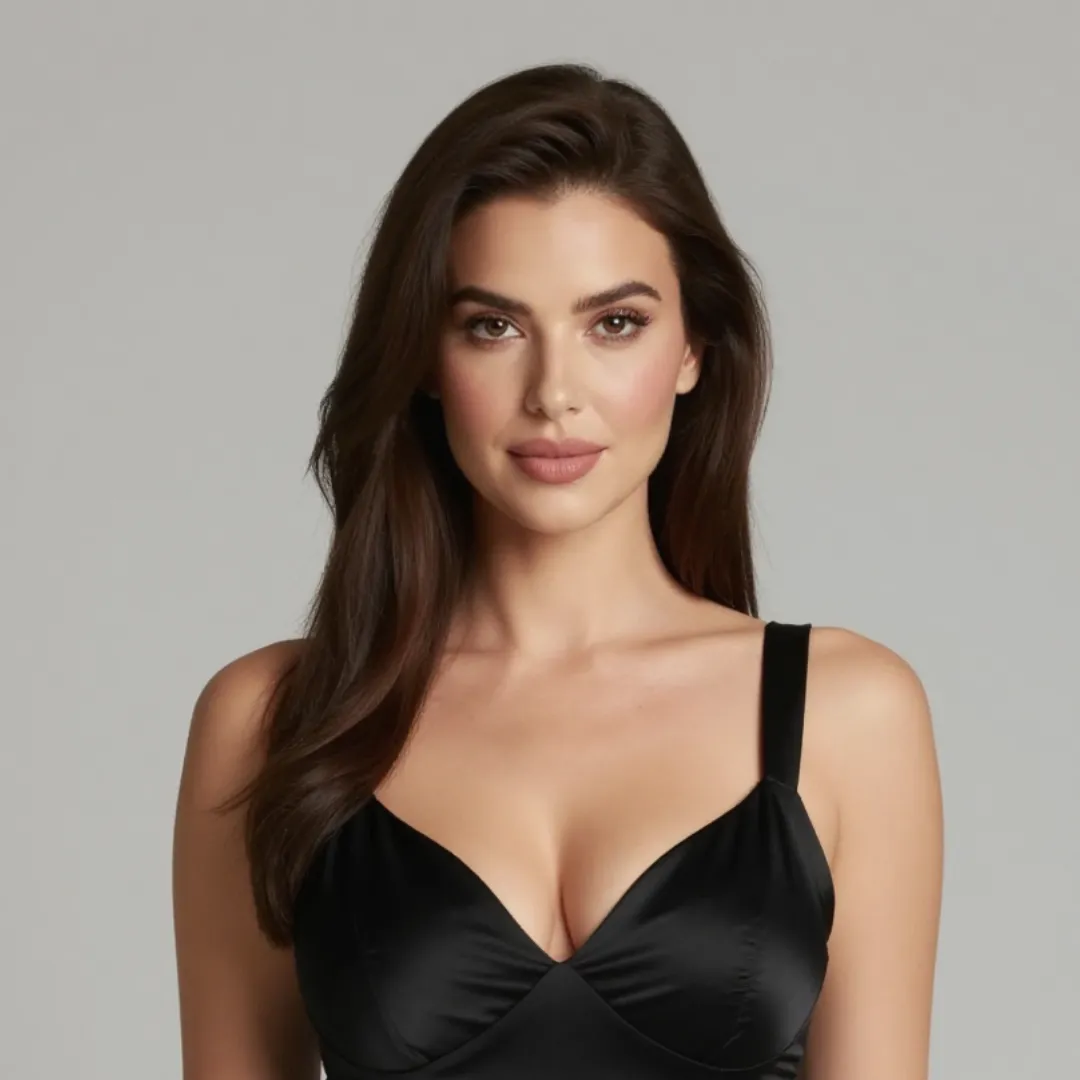
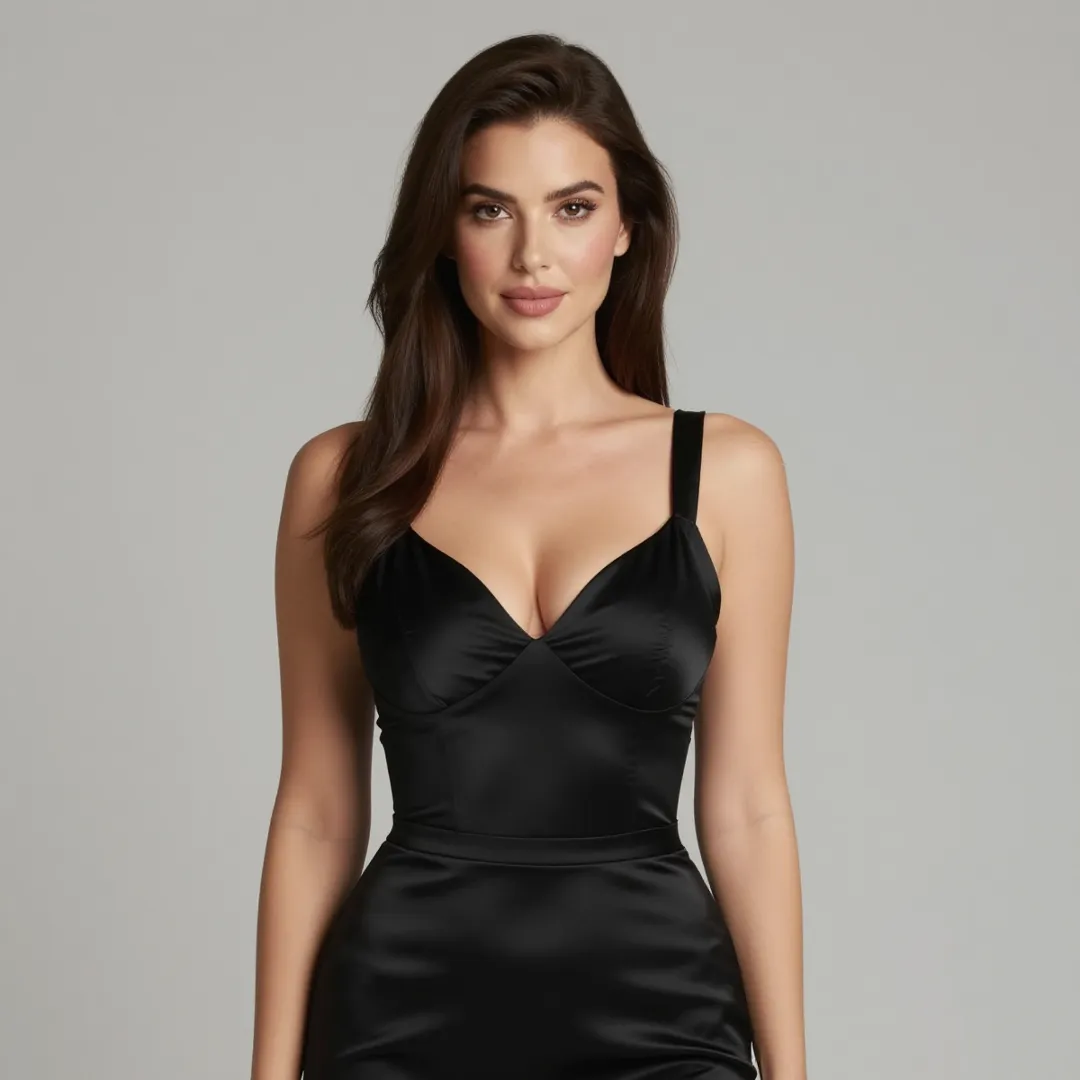
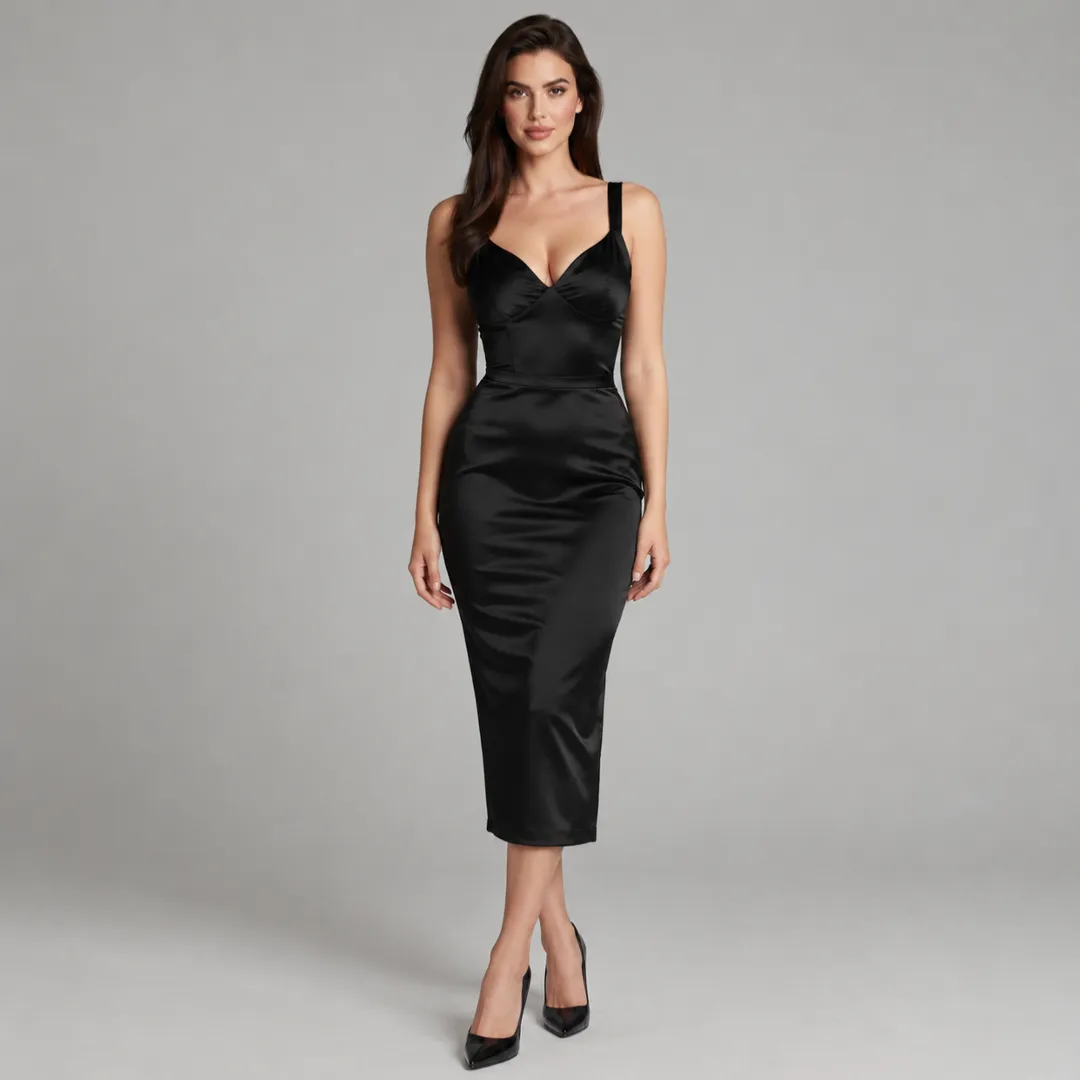
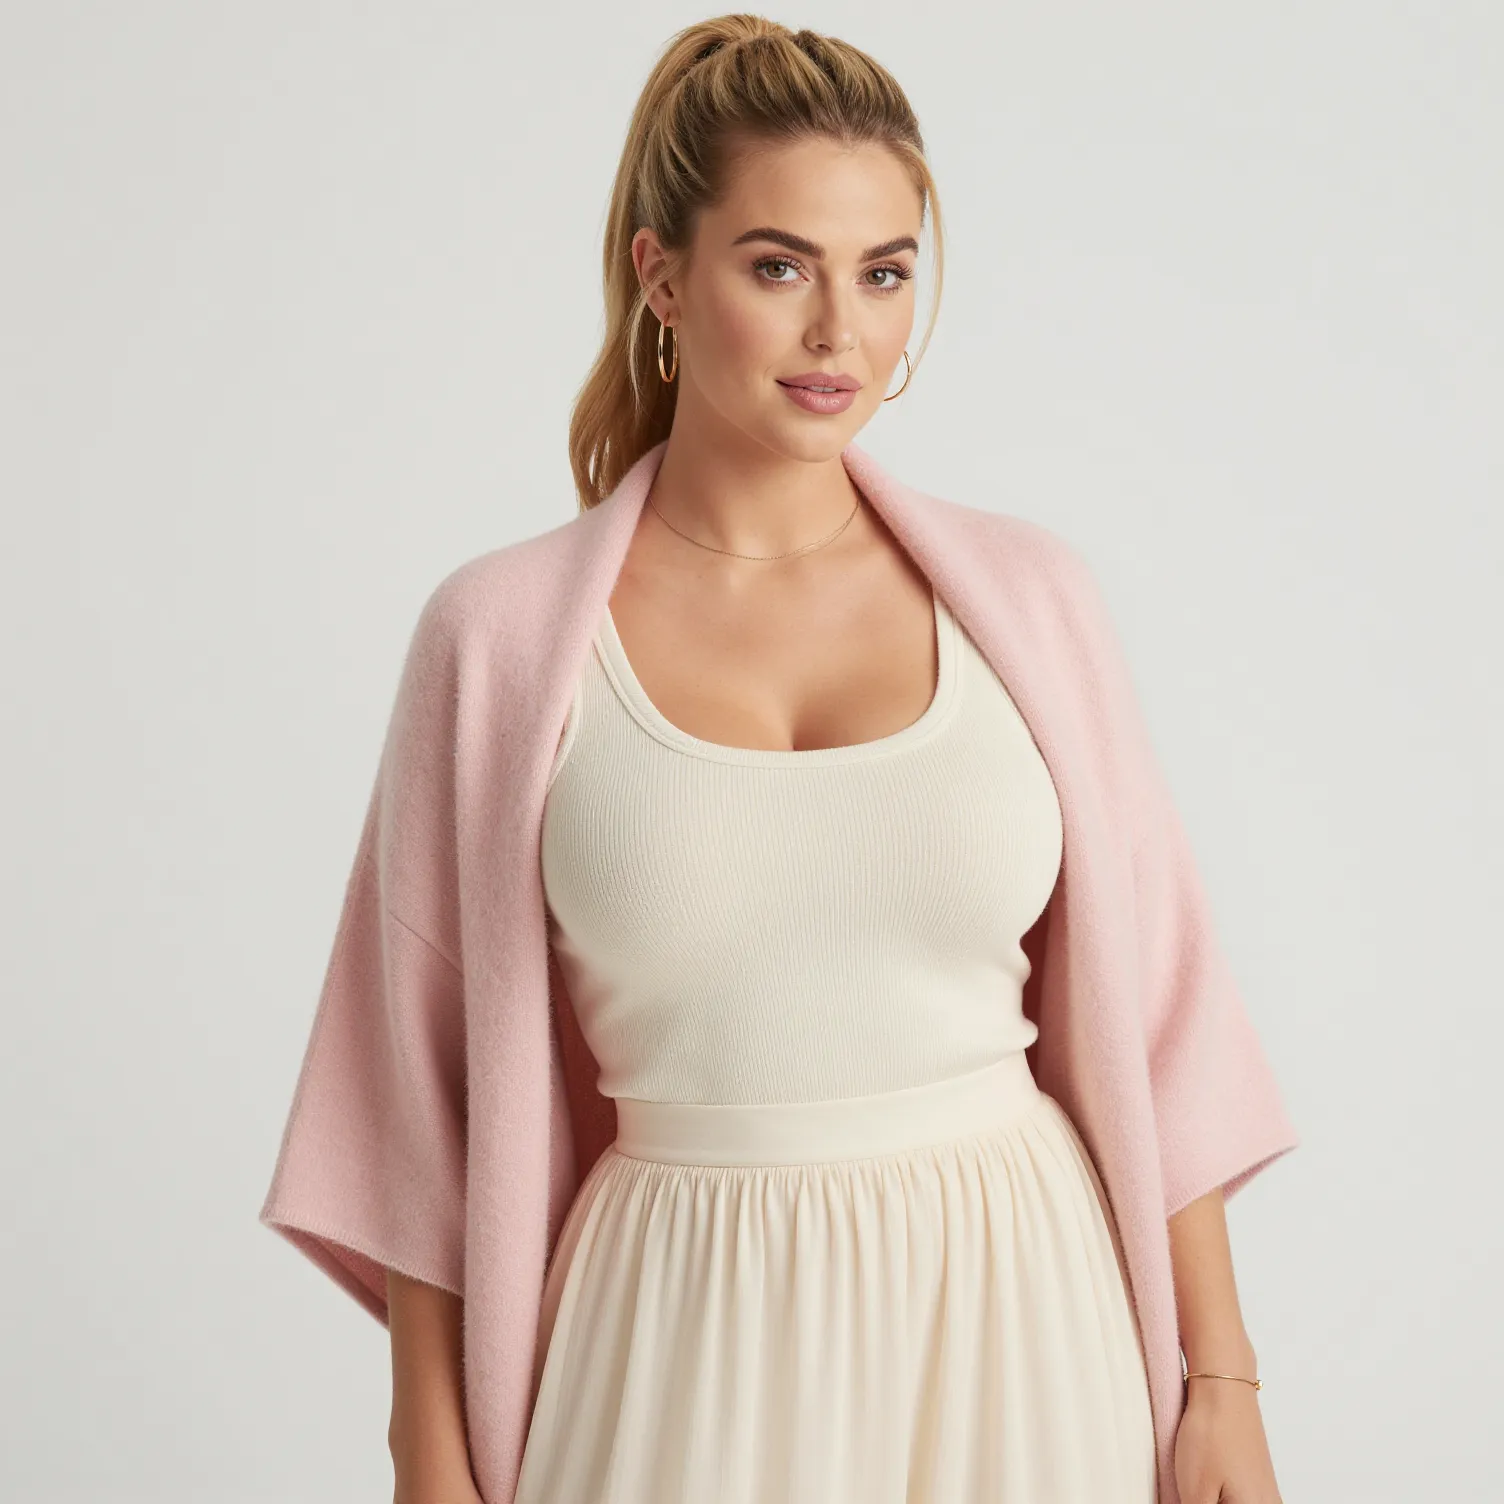
Não misturar
Combine a imagem de referência com o movimento
Escolha uma imagem de identidade que já mostre a área corporal envolvida. Se o movimento cruzar a cintura, mudar uma pose sentada ou colocar uma mão no tronco, essas áreas devem estar visíveis e estruturalmente claras.
A dificuldade aumenta quando o modelo tem de revelar anatomia oculta, separar membros sobrepostos ou manter vários pontos de contacto. Por isso uma pose simples pode ser melhor referência do que uma imagem mais dramática.
Evite que a fonte de movimento substitua a personagem
Um vídeo de movimento pode incluir uma intérprete cujo rosto, corpo, roupa ou ambiente seja visualmente mais forte que a imagem de identidade. O modelo pode preservar mais dessa fonte do que o previsto.
Defina o sujeito alvo antes do movimento. Diga explicitamente que a intérprete de referência não é mantida. Se a identidade continuar fraca, escolha um clipe com rosto de origem menos dominante ou pose mais compatível.
Teste a interação próxima em separado
Uma interação entre duas pessoas acrescenta outra identidade, mais membros, oclusão temporária e vários pontos de contacto móveis. Não a use como primeiro teste de uma nova personagem.
Valide primeiro a personagem principal sozinha e depois introduza o segundo sujeito num plano curto e controlado. Mantenha os corpos separados quando possível e evite alterar ao mesmo tempo várias mãos, rostos e movimentos de câmara.
Para uma sequência longa, crie clipes separados para introdução, mudança de pose, interação próxima e plano final. Reutilize as referências aprovadas em vez de exigir todas as transições numa só geração.
Como escrever prompts Ref2VA consistentes para personagem e movimento NSFW
Um prompt Ref2VA deve explicar o vídeo alvo e a relação com as fontes. Repetir adjetivos de aparência não substitui uma atribuição clara dos referências.
O formato de prompt de referência completa do MiniMax organiza um pedido Ref2VA em seis secções:
subject_definitions:
<Subject 1> é a mulher fictícia adulta cuja identidade facial, cabelo comprido escuro, proporções e estilo em cetim preto vêm de <Picture 1>.
<Picture 2> mostra a mesma personagem de forma mais ampla e confirma proporções e postura inicial.
<Video 1> fornece um ajuste lento da pose sentada e um avanço contido da câmara.
<Audio 1> é a referência de timbre vocal de <Subject 1> (S1).

summary:
[geração por referência + referência de áudio]
O alvo é um vídeo de estúdio privado num só plano de <Subject 1>. Identidade e estilo seguem <Picture 1> e <Picture 2>. Movimento e timing de câmara seguem <Video 1>. O timbre vocal referencia <Audio 1>.

retention_analysis:
<Subject 1>: fully_preserved - manter rosto, cabelo, proporções, estilo em cetim e estado visual geral.
<Video 1>: reference - transferir a mudança de pose e o ritmo de câmara sem manter a intérprete ou o ambiente de origem.
<Audio 1>: reference - orientar o timbre vocal sem copiar a gravação.

detailed_description:
O vídeo usa iluminação fotográfica realista num estúdio privado silencioso.
[Shot 1] <Subject 1> está sentada num plano médio a três quartos. Seguindo o movimento controlado de <Video 1>, desloca lentamente o peso, vira um ombro para a câmara e assenta na nova pose. A câmara avança uma vez de forma contida sem mudar o ângulo. <Subject 1> (S1), com a qualidade vocal calma de <Audio 1>, diz: <d>[Português] Fica aqui um momento.</d>

overall_soundscape:
Som ambiente discreto, leve movimento do tecido e interpretação vocal referenciada.

non_diegetic_music:
Sem música de fundo.
Este prompt define a identidade uma vez e dedica o restante ao movimento, câmara e som. Evite repetir a descrição do rosto e corpo em cada campo.
Se o resultado precisa de um plano contínuo, não adicione várias instruções de câmara sem relação. Se uma segunda ação exige nova pose, enquadramento ou contacto, talvez mereça um clipe separado.
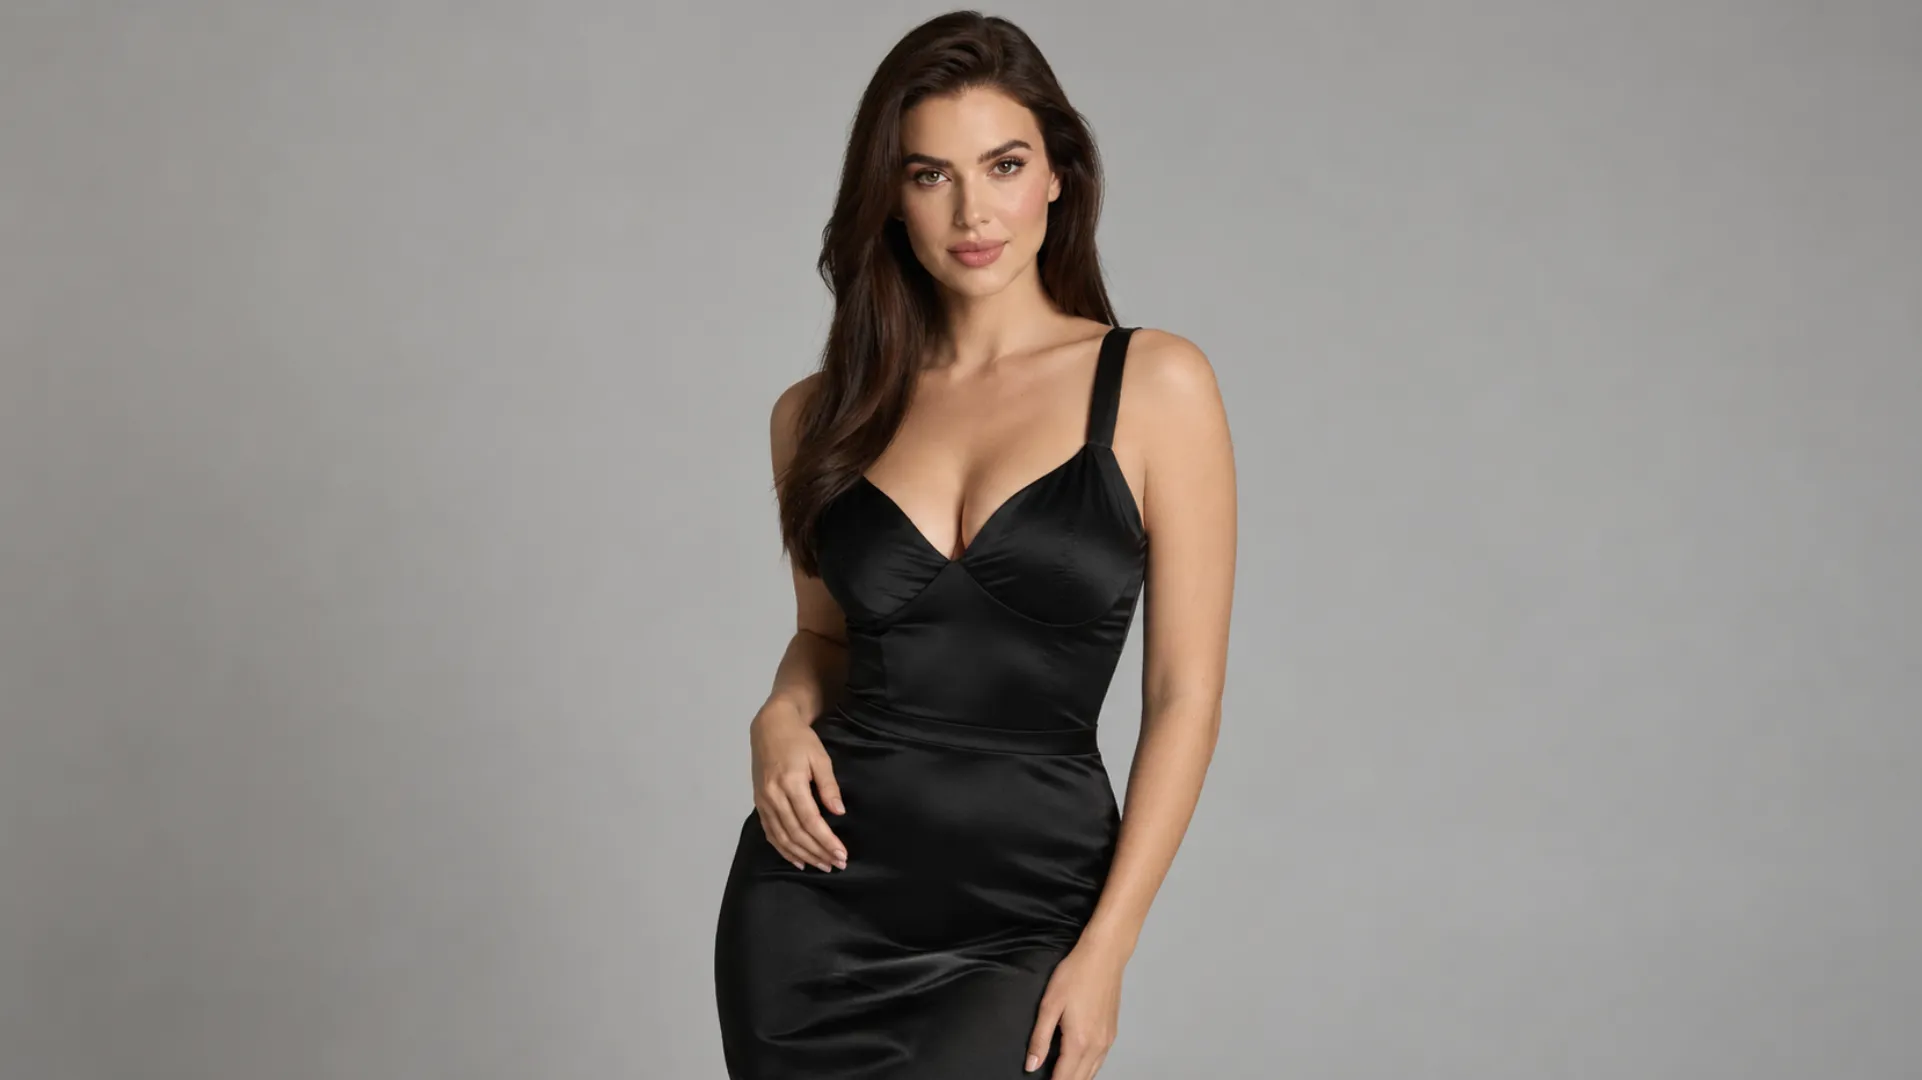 Cena NSFW
Fluxo prático do MiniMax H3 Ref2VA para vídeos NSFW com IA
Um fluxo reutilizável só deve aumentar a complexidade quando a camada anterior estiver estável.
Passo 1: aprove a imagem da personagem
Escolha uma imagem que estabeleça identidade, direção corporal, estilo e estado visual. Se não existir uma adequada, crie-a com o Gerador de garota real da AINSFW.AI, o Gerador de garota anime ou Imagens por tags.
Não avance apenas porque a imagem é atraente. Confirme que fornece informação suficiente para a primeira ação planeada.
Passo 2: crie um teste de identidade
Gere um plano curto, próximo ou médio, com movimento dos olhos, respiração, pequena mudança de expressão ou leve rotação da cabeça. Isso mostra se a personagem continua reconhecível antes de um movimento maior.
Passo 3: adicione movimento corporal controlado
Use uma referência mais ampla e peça um só ajuste de ombro, tronco, cintura ou pose sentada. Mantenha a câmara fixa no primeiro teste de movimento.
Se a personagem mudar com um movimento pequeno, uma fonte mais complexa costuma tornar essa mudança mais visível.
Passo 4: introduza a referência de movimento
Ligue um vídeo curto com pose inicial compatível. Indique que ele fornece movimento e timing de câmara, não identidade.
Compare o novo resultado com o teste anterior. Se o alvo começar a parecer-se com a intérprete de referência, simplifique a fonte ou torne a atribuição do sujeito mais explícita.
Passo 5: adicione câmara e áudio
Quando o movimento corporal estiver estável, introduza um comportamento de câmara. Adicione voz, ambiente ou música depois de as referências visuais funcionarem juntas.
Não mude no mesmo teste a fonte de movimento, câmara, áudio, estrutura do prompt e definições de geração. Um resultado vale mais quando a causa é compreensível.
Passo 6: crie planos de vídeo independentes
Crie clipes separados para funções de produção diferentes:
- Plano de identidade: enquadramento próximo ou médio com expressão subtil.
- Plano de pose: uma transição corporal ou postural controlada.
- Plano de movimento amplo: movimento maior apoiado por uma referência mais aberta.
- Plano de interação: clipe testado separadamente com contacto adicional ou outro sujeito.
Gere cada clipe a partir do conjunto aprovado em vez de usar o resultado anterior como única fonte do seguinte. Isso reduz a deriva acumulada da identidade.
Se ficheiros locais, mapeamento de referências e manutenção do ComfyUI forem mais controlo do que o projeto precisa, use a imagem aprovada com o Gerador de imagem para vídeo da AINSFW.AI. É a rota mais simples quando se parte de uma imagem e não são necessárias várias referências de vídeo ou áudio.
Perguntas frequentes sobre MiniMax H3 Ref2VA
MiniMax H3 Ref2VA é o mesmo que MiniMax H3 R2V?
Na documentação atual do ComfyUI, o modelo pode chamar-se MiniMax H3 R2V enquanto a tarefa e o checkpoint usam ref2va. Aqui ambos os nomes indicam o fluxo referência-para-áudio-vídeo, não a rota de fotogramas-chave FL2VA.
O Ref2VA pode usar várias imagens da personagem?
Sim. O fluxo oficial suporta várias referências de imagem. Use imagens adicionais para ângulos compatíveis, informação corporal, estilo ou ambiente. Imagens que discordem na identidade ou proporções podem reduzir a consistência.
Porque é que um vídeo carregado não liga à entrada Ref2VA?
O carregador pode produzir um objeto VIDEO enquanto a entrada espera fotogramas extraídos. Use o nó nativo Get Video Components do ComfyUI quando necessário para separar sequência, áudio e metadados.
O Ref2VA pode combinar imagens, vídeo e áudio?
Sim. O Ref2VA foi criado para referências multimodais mistas. Ligue pelo menos uma imagem ou vídeo, etiquete cada fonte de forma consistente e indique se fornece identidade, movimento, câmara, áudio reutilizável ou característica vocal.
O Ref2VA garante uma personagem NSFW consistente?
Não. O Ref2VA fornece mais informação, mas a consistência ainda depende do acordo entre fontes, informação corporal visível, compatibilidade das poses, clareza do prompt, complexidade do movimento e oclusão. Testes curtos e adições controladas continuam necessários.